

Kod produktów programowych do uczenia maszynowego często bywa złożony i dość skomplikowany. Wykrywanie i eliminacja błędów w nim to zadanie wymagające dużych zasobów. Nawet najprostsze wymagają poważnego podejścia do architektury sieci, inicjalizacji wag, optymalizacji sieci. Nawet mały błąd może prowadzić do nieprzyjemnych problemów.
Ten artykuł poświęcony jest algorytmowi debugowania twoich sieci neuronowych.
Skillbox poleca: Praktyczny kurs .
Przypominamy: dla wszystkich czytelników „Habra” — zniżka 10 000 rubli przy zapisie na dowolny kurs Skillbox z kodem promocyjnym „Habra”.
Algorytm składa się z pięciu etapów:
- prosty start;
- potwierdzenie strat;
- sprawdzanie pośrednich rezultatów i połączeń;
- diagnozowanie parametrów;
- kontrolowanie działania.
Jeśli coś wydaje się bardziej interesujące niż inne, możesz od razu przejść do tych sekcji.
Prosty start
Debugowanie sieci neuronowej o skomplikowanej architekturze, regularyzacji i harmonogramie uczenia jest trudniejsze niż w przypadku zwykłej. Trochę tu oszukujemy, ponieważ ten punkt ma pośredni związek z debugowaniem, ale to wciąż ważna rekomendacja.
Prosty start polega na stworzeniu uproszczonego modelu i nauczeniu go na jednym zbiorze (punkcie) danych.
Najpierw tworzymy uproszczony model
Aby szybko zacząć, tworzymy małą sieć z jedną ukrytą warstwą i sprawdzamy, czy wszystko działa poprawnie. Następnie stopniowo komplikujemy model, sprawdzając każdy nowy aspekt jego struktury (dodatkowej warstwy, parametru itp.) i przechodzimy dalej.
Uczymy model na jedynym zbiorze (punkcie) danych
Jako szybkie sprawdzenie funkcjonalności twojego projektu możesz wykorzystywać do nauki jeden lub dwa punkty danych, aby potwierdzić, czy system działa poprawnie. Sieć neuronowa powinna wykazać 100% dokładności w treningu i testowaniu. Jeśli tak nie jest, to albo model jest za mały, albo masz już błąd.
Nawet jeśli wszystko jest w porządku, przygotuj model do przeprowadzenia jednej lub kilku epok, zanim przejdziesz dalej.
Ocena strat
Ocena strat to podstawowy sposób, aby ulepszyć wydajność modelu. Musisz upewnić się, że strata odpowiada zadaniu, a funkcje strat są oceniane na odpowiedniej skali. Jeśli używasz więcej niż jednego typu strat, upewnij się, że wszystkie są jednego rzędu i prawidłowo skalowane.
Ważne jest, aby zwrócić uwagę na początkowe straty. Sprawdź, jak bliskie są rzeczywiste wyniki oczekiwanym, jeśli model rozpoczął od losowej prognozy. W : „Upewnij się, że uzyskujesz wyniki spodziewane na początku pracy z niewielką liczbą parametrów. Lepiej od razu sprawdzić utratę danych (ustawiając stopień regularyzacji na zero). Na przykład, dla CIFAR-10 z klasyfikatorem Softmax oczekujemy, że początkowe straty będą wynosić 2.302, ponieważ oczekiwana rozproszona prawdopodobieństwo wynosi 0,1 dla każdej klasy (ponieważ istnieje 10 klas), a strata Softmax jest ujemnym logarytmem prawdopodobieństwa właściwej klasy, czyli -ln(0,1) = 2,302.
Dla przykładu binarnego należy wykonać analogiczne obliczenia dla każdej z klas. Na przykład, dane: 20% 0 i 80% 1. Oczekiwana początkowa strata wyniesie do -0,2ln(0,5) -0,8ln(0,5) = 0,693147. Jeśli wynik jest większy niż 1, może to wskazywać na to, że wagi sieci neuronowej nie są prawidłowo zrównoważone lub dane nie są znormalizowane.
Sprawdzamy wyniki pośrednie i połączenia
Aby debugować sieć neuronową, trzeba rozumieć dynamikę procesów w sieci oraz rolę poszczególnych warstw pośrednich, ponieważ są one ze sobą powiązane. Oto typowe błędy, z którymi możesz się spotkać:
- nieprawidłowe wyrażenia dla aktualizacji gradientu;
- nie stosuje się aktualizacji wag;
- znikające lub eksplodujące gradienty (exploding gradients).
Jeśli wartości gradientu są zerowe, oznacza to, że szybkość uczenia w optymalizatorze jest zbyt mała, lub że natknąłeś się na nieprawidłowe wyrażenie dla aktualizacji gradientu.
Ponadto, należy monitorować wartości funkcji aktywacji, wag i aktualizacji każdej z warstw. Na przykład, wartość aktualizacji parametrów (wag i przesunięć) .
Istnieje zjawisko, które nazywa się „Dying ReLU” lub , kiedy neurony ReLU zwracają zero po nauce dużej ujemnej wartości (bias) przesunięcia dla swoich wag. Te neurony nigdy więcej nie będą aktywowane w żadnym miejscu danych.
Możesz użyć sprawdzenia gradientu, aby wykryć te błędy, przybliżając gradient przy użyciu podejścia numerycznego. Jeśli jest on bliski obliczonym gradientom, to propagacja wsteczna została zrealizowana poprawnie. Aby stworzyć sprawdzenie gradientu, zapoznaj się z tymi wspaniałymi zasobami z CS231 i , a także z Andrzeja Nga (Andrew Nga) na ten temat.
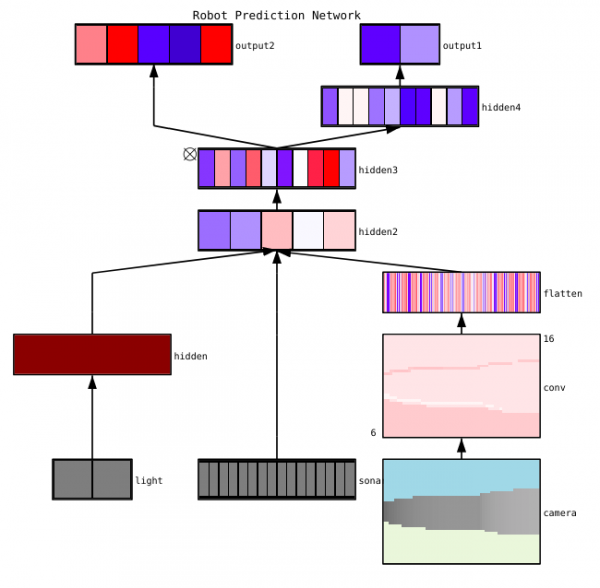
wskazuje na trzy główne metody wizualizacji sieci neuronowej:
- Wstępne — proste metody, które pokazują nam ogólną strukturę wytrenowanego modelu. Obejmują one wyprowadzanie form lub filtrów poszczególnych warstw sieci neuronowej oraz parametrów w każdej warstwie.
- Oparte na aktywacji. W nich odszyfrowujemy aktywacje pojedynczych neuronów lub grup neuronów, aby zrozumieć ich funkcje.
- Oparte na gradientach. Te metody zazwyczaj manipulują gradientami, które powstają w procesie przechodzenia w przód i w tył podczas uczenia modelu (w tym mapy istotności i mapy aktywacji klasy).
Istnieje kilka przydatnych narzędzi do wizualizacji aktywacji i połączeń poszczególnych warstw, takich jak i .
Diagnostyka parametrów
Sieci neuronowe mają wiele parametrów, które wzajemnie na siebie oddziałują, co komplikuje optymalizację. Właściwie ten rozdział jest przedmiotem intensywnych badań ekspertów, więc poniższe sugestie powinny być traktowane jedynie jako porady, punkty wyjścia, od których można się odnieść.
Rozmiar partii (batch size) — jeśli wymaga się, aby rozmiar partii był wystarczająco duży do uzyskania dokładnych ocen gradientu błędu, ale wystarczająco mały, aby stochastyczny spadek gradientu (SGD) mógł uporządkować twoją sieć. Małe rozmiary partii prowadzą do szybkiej zbieżności z powodu szumów w procesie uczenia i później — do trudności w optymalizacji. Więcej na ten temat opisano .
Współczynnik uczenia — zbyt niski doprowadzi do wolnej zbieżności lub ryzyka utknięcia w lokalnych minimach. Z drugiej strony wysoki współczynnik uczenia spowoduje rozbieżność optymalizacji, ponieważ ryzykujesz "skok" przez głęboką, ale wąską część funkcji straty. Spróbuj użyć planowania współczynnika, aby go zmniejszyć w trakcie uczenia się sieci neuronowej. W kursie CS231n .
Przycinanie gradientów— to obcinanie parametrów gradientów podczas wstecznej propagacji do maksymalnej wartości lub normy granicznej. Przydatne w rozwiązywaniu problemów z wszelkimi wybuchowymi gradientami, na które możesz natknąć się w punkcie trzecim.
Normalizacja wsadowa — jest używana do normalizacji danych wejściowych każdego warstwy, co pozwala rozwiązać problem wewnętrznego przesunięcia kowariancji. Jeśli używasz Dropout i Batch Normy razem, .
Stochastyczny spadek gradientu (SGD) — istnieje kilka wariantów SGD, które wykorzystują moment, adaptacyjne współczynniki uczenia się i metodę Nesterowa. Żaden z nich nie ma wyraźnej przewagi ani pod względem efektywności uczenia się, ani ogólności ().
Regularyzacja — jest kluczowe dla budowania modelu ogólnego, ponieważ dodaje karę za złożoność modelu lub wartości ekstremalne parametrów. To sposób na zmniejszenie wariancji modelu bez znacznego zwiększania jego biasu. Bardziej .
Aby ocenić wszystko samodzielnie, musisz wyłączyć regularizację i samodzielnie sprawdzić gradient straty.
Dropout — kolejna metoda regularyzacji twojej sieci, aby zapobiec przeciążeniu. Podczas uczenia się dropout jest realizowane poprzez utrzymanie aktywności neuronu z pewnym prawdopodobieństwem p (hiperparametr) lub ustawienie go na zero w przeciwnym przypadku. W rezultacie sieć musi używać innego podzbioru parametrów dla każdej partii szkoleniowej, co zmniejsza zmiany niektórych parametrów, które stają się dominujące.
Ważne: jeśli używasz zarówno dropout, jak i normalizacji wsadowej, zachowaj ostrożność co do kolejności tych operacji lub nawet ich wspólnego używania. Wszystko to wciąż jest aktywnie omawiane i uzupełniane. Oto dwie ważne dyskusje na ten temat i .
Kontrola działania
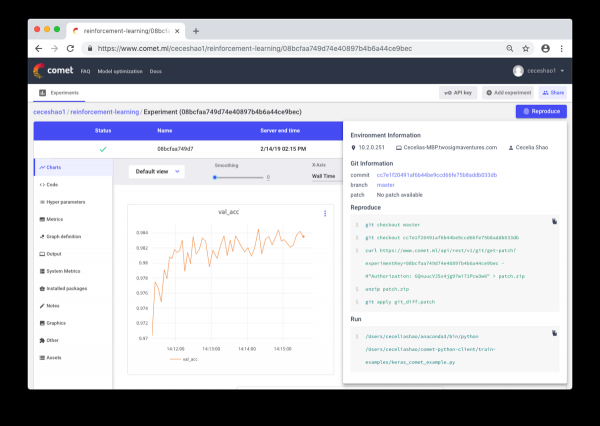
Chodzi o dokumentowanie procesów roboczych i eksperymentów. Jeśli nic nie jest dokumentowane, można zapomnieć, na przykład, jaka jest używana szybkość uczenia lub waga klas. Dzięki kontroli można bez problemu przeglądać i powtarzać wcześniejsze eksperymenty. To pozwala zmniejszyć liczbę powielających się eksperymentów.
Prawda, że ręczne dokumentowanie może stać się trudnym zadaniem w przypadku dużej ilości pracy. Tutaj z pomocą przychodzą takie narzędzia jak Comet.ml, które pomagają automatycznie rejestrować zbiory danych, zmiany w kodzie, historię eksperymentów oraz modele produkcyjne, w tym kluczowe informacje o twoim modelu (hiperparametry, wskaźniki wydajności modelu i informacje o środowisku).
Sieć neuronowa może być bardzo wrażliwa na drobne zmiany, co może prowadzić do spadku wydajności modelu. Śledzenie i dokumentowanie pracy to pierwszy krok, który warto podjąć w celu standaryzacji środowiska i modelowania.
Mam nadzieję, że ten post stanie się punktem wyjścia, z którego rozpoczniesz debugowanie swojej sieci neuronowej.
Skillbox poleca:
- Dwuletni praktyczny kurs .
- Kurs online .
- Praktyczny roczny kurs .
Źródło: habr.com
