

A empresa NVIDIA publicou os códigos-fonte do StyleGAN3, um sistema de aprendizado de máquina baseado em redes neurais generativas adversariais (GAN), destinado a sintetizar imagens realistas de rostos humanos. O código é escrito em Python utilizando o framework PyTorch e é distribuído sob a licença NVIDIA Source Code License, que impõe restrições ao uso comercial.
Modelos prontos e treinados também estão disponíveis para download, treinados na coleção Flickr-Faces-HQ (FFHQ), que inclui 70 mil imagens de rostos humanos de alta qualidade (1024×1024) em formato PNG. Além disso, existem modelos baseados nas coleções AFHQv2 (fotos de rostos de animais) e Metfaces (imagens de rostos humanos de retratos de pintura clássica). O desenvolvimento foca em rostos, mas o sistema pode ser treinado para gerar qualquer objeto, como paisagens e automóveis. Ferramentas para o treinamento da rede neural com coleções de imagens próprias também são fornecidas. É necessário ter uma ou mais placas gráficas NVIDIA (recomendadas as GPUs Tesla V100 ou A100), pelo menos 12 GB de RAM, PyTorch 1.9 e o toolkit CUDA 11.1+. Um detector especial está em desenvolvimento para identificar a artificialidade dos rostos gerados.
O sistema permite sintetizar a imagem de um novo rosto com base na interpolação das características de vários rostos, combinando os traços característicos e adaptando a imagem final para a idade desejada, sexo, comprimento do cabelo, caráter do sorriso, forma do nariz, cor da pele, óculos e ângulo da fotografia. O gerador considera a imagem como uma coletânea de estilos, separando automaticamente os detalhes característicos (sardas, cabelo, óculos) dos atributos gerais de alto nível (posição, sexo, mudanças relacionadas à idade) e permitindo combiná-los de forma arbitrária, definindo propriedades dominantes através de coeficientes de peso. Como resultado, imagens indistinguíveis de fotografias reais são geradas.
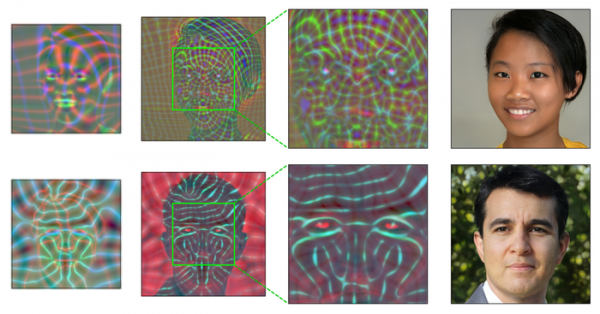
A primeira versão da tecnologia StyleGAN foi publicada em 2019, seguida pela versão aprimorada StyleGAN2 em 2020, que possibilitou uma melhoria na qualidade das imagens e eliminou alguns artefatos. No entanto, o sistema permaneceu estático, ou seja, não permitia animações realistas ou movimento facial. Ao desenvolver o StyleGAN3, o principal objetivo foi adaptar a tecnologia para sua aplicação em animações e vídeos.
O StyleGAN3 utilizou uma arquitetura reformulada para a geração de imagens, livre de aliasing, e novos cenários de treinamento da rede neural foram propostos. Inclui novas utilidades para visualização interativa (visualizer.py), análise (avg_spectra.py) e geração de vídeos (gen_video.py). A implementação também reduziu o consumo de memória e acelerou o processo de treinamento.
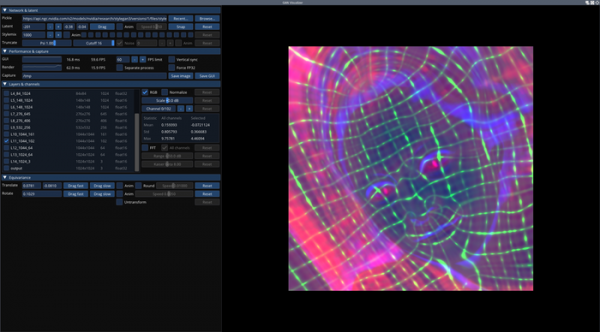
Uma característica chave da arquitetura StyleGAN3 foi a transição para a interpretação de todos os sinais na rede neural na forma de processos contínuos, o que permitiu manipular as posições relativas durante a formação de detalhes, não vinculadas às coordenadas absolutas de pixels individuais na imagem, mas associadas à superfície dos objetos representados. No StyleGAN e no StyleGAN2, a vinculação a pixels na geração levava a problemas de visualização dinâmica; por exemplo, ao mover a imagem, havia desacordo em detalhes finos, como rugas e fios de cabelo, que pareciam se mover separadamente do restante do rosto. No StyleGAN3, esses problemas foram resolvidos e a tecnologia se tornou bastante adequada para a formação de vídeos.
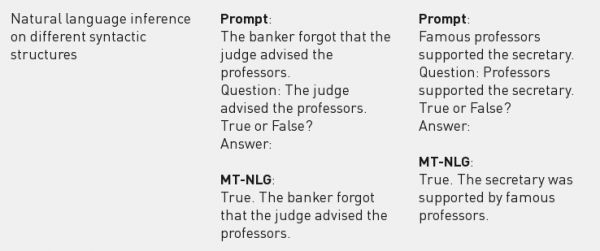
Além disso, pode-se mencionar o anúncio da criação da maior modelo de linguagem MT-NLG pelas empresas NVIDIA e Microsoft, baseado em uma rede neural profunda com arquitetura de transformador. O modelo cobre 530 bilhões de parâmetros, e para seu treinamento foi utilizado um cluster contando com 4480 GPUs (560 DGX A100 com 8 GPUs A100 80GB cada). servidores As áreas de aplicação do modelo incluem a resolução de tarefas de processamento de informações em linguagem natural, como previsão do término de frases incompletas, respostas a perguntas, compreensão de leitura, formação de conclusões em linguagem natural e análise de ambiguidade no significado das palavras.
Fonte: opennet.ru
