

A empresa Google apresentou o codec de áudio Lyra V2, que utiliza técnicas de aprendizado de máquina para alcançar a máxima qualidade na transmissão de voz em canais de comunicação muito lentos. A nova versão se destaca pela transição para uma nova arquitetura de rede neural, suporte a plataformas adicionais, recursos expandidos de controle de taxa de bits, aumento de desempenho e alcance de uma qualidade de som superior. A implementação de referência do código é escrita em C++ e distribuída sob a licença Apache 2.0.
Em termos de qualidade dos dados de voz transmitidos em baixa velocidade, a Lyra supera substancialmente os codecs tradicionais que utilizam métodos de processamento digital de sinais. Para alcançar uma alta qualidade na transmissão de voz sob a limitação da quantidade de informações transmitidas, além dos métodos convencionais de compressão de som e transformação de sinais, a Lyra aplica um modelo de fala baseado em um sistema de aprendizado de máquina, que permite recriar informações ausentes com base em características típicas da fala.
O codec inclui um codificador e um decodificador. O algoritmo do codificador consiste em extrair parâmetros de dados de voz a cada 20 milissegundos, comprimí-los e enviá-los ao receptor pela rede com uma taxa de bits variando de 3,2 kbps a 9,2 kbps. No lado do receptor, o decodificador utiliza um modelo generativo para reconstruir o sinal de voz original com base nos parâmetros de som transmitidos, que incluem espectrogramas mel logarítmicos que consideram as características da energia vocal em diferentes faixas de frequência e são preparados levando em conta o modelo de percepção auditiva humana.
No Lyra V2, uma nova modelo generativa é utilizada, baseada na rede neural convolucional SoundStream, que se destaca por suas baixas exigências em recursos computacionais, permitindo a decodificação em tempo real mesmo em sistemas de baixo desempenho. O modelo utilizado para gerar som foi treinado com várias milhares de horas de gravações de vozes em mais de 90 idiomas. O TensorFlow Lite é utilizado para a execução do modelo. O desempenho da implementação proposta é suficiente para codificar e decodificar voz em smartphones de baixo custo.
Além de usar outro modelo generativo, a nova versão também se destaca pela inclusão na arquitetura do codec de elos com quantizador RVQ (Quantizador de Vetor Residual), realizado no lado do remetente antes da transmissão dos dados e, no lado do receptor, após a recepção dos dados. O quantizador transforma os parâmetros fornecidos pelo codec em conjuntos de pacotes, codificando a informação de acordo com a taxa de bits selecionada. Para garantir diferentes níveis de qualidade, são previstos quantizadores para três taxas de bits (3,2 kps, 6 kbps e 9,2 kbps); quanto maior a taxa de bits, melhor a qualidade, mas com requisitos mais altos de largura de banda.
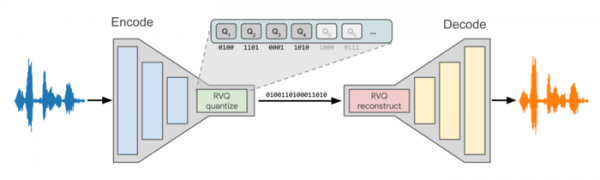
A nova arquitetura permitiu reduzir a latência na transmissão do sinal de 100 para 20 milissegundos. Para comparação, o codec Opus para WebRTC demonstrou latências de 26,5 ms, 46,5 ms e 66,5 ms nas taxas de bits testadas. Além disso, a performance do codificador e do decodificador aumentou significativamente — em comparação com a versão anterior, destaca-se uma aceleração de até 5 vezes. Por exemplo, no smartphone Pixel 6 Pro, o novo codec realiza a codificação e decodificação de uma amostra de 20 milissegundos em 0,57 ms, o que é 35 vezes mais rápido do que o necessário para a transmissão em tempo real.
Além da performance, também foi alcançada uma melhoria na qualidade da recuperação do som — na escala MUSHRA, a qualidade da fala nas taxas de bits de 3,2 kbps, 6 kbps e 9,2 kbps, ao usar o codec Lyra V2, corresponde às taxas de bits de 10 kbps, 13 kbps e 14 kbps ao usar o codec Opus.
Fonte: opennet.ru
