

É curioso como a história dos lançamentos de modelos abertos para a conversão de prompts textuais em imagens, desenvolvidos e treinados pela Stability AI, se assemelha a uma série de altos e baixos das versões do sistema operacional da Microsoft. Após a lendária e bem-sucedida XP, tivemos a problemática Vista; em seguida, a maravilhosa 'sete' — e logo depois, a pouco inspiradora Windows 8. A versão 1.5 do Stable Diffusion, inicialmente pouco atraente, mas que foi gradualmente aperfeiçoada por entusiastas, foi seguida pela claramente fracassada SD 2.0 — fracassada, na verdade, porque incluía um codificador OpenCLIP atípico para modelos desse tipo, do . Nesse processo de seleção, foram descartados não apenas referências visuais inadequadas (NSFW), mas também obras e ilustrações de artistas famosos, como o notório Greg Rutkowski. Isso deixou os entusiastas bastante irritados: enquanto para a SD 1.5, mesmo na sua versão inicial, sem a aplicação de checkpoints especialmente treinados, funcionavam bem prompts simples usando estilos — 'paisagem épica de fantasia medieval, no estilo de Greg Rutkowski' — e o resultado era impressionante, a SD 2.0 parou de 'reconhecer' os nomes dos ilustradores mais conhecidos, cujos direitos autorais sobre as obras criadas ainda estão em vigor e que não se dignaram a disponibilizar essas obras para o treinamento da IA. Era necessário usar mais palavras para descrever o desejado, e com prompts excessivamente longos, o modelo teve dificuldades.
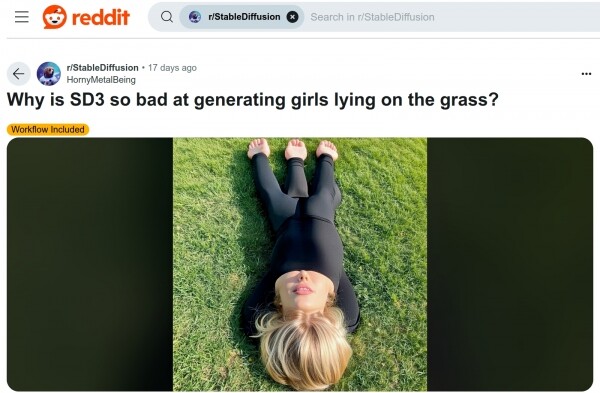
Sentaram — levantaram, sentaram — levantaram
Combinado com o codificador modificado (o transformador de prompts de texto em tokens digitais com os quais o modelo realmente trabalha depois), a impossibilidade de aplicar estilos nomeados simplesmente desmotivou os entusiastas a aprimorar a "duzinha" por conta própria. Afinal, era necessário entender como adaptar a técnica já desenvolvida de elaboração de prompts para o novo codificador e reensinar o modelo a reconhecer as imagens e os temas com os quais os criadores não o apresentaram durante o treinamento inicial — e a diferença de qualidade em relação à "meia" que as imagens geradas pela "duzinha" ofereciam não era garantida. Sim, houve um salto qualitativo do tamanho padrão de 512×512 do SD 1.5 para 768×768, mas, naquele momento, a comunidade já utilizava amplamente upscalers, outpainters e outras ferramentas para aumentar as dimensões da imagem final, de modo que o SD 2.0 passou, na verdade, despercebido. SDXL (desenvolvido pela OpenAI e utilizado, em particular, pelo projeto DALL-E) — o código dele também é aberto, mas a base de dados na qual foi treinado, , é proprietária. Além disso, o tamanho padrão da tela aumentou em "Oversize" para 1024×1024, e uma série de aprimoramentos adicionais surgiram — assim, os entusiastas se dedicaram com prazer ao seu aprimoramento. E, atualmente, o SDXL (inclusive suas variantes, que surgiram recentemente e exigem menos do "hardware", como e ) pode ser considerado, com confiança, o gerador de imagens de IA com código aberto mais popular. No entanto, fervorosos defensores do SD 1.5 discordam com argumentos, apontando que ferramentas essenciais como o ControlNet ainda não foram adequadamente transferidas para o SDXL. .
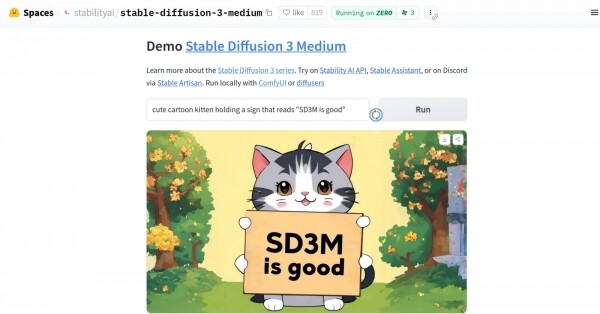
Stable Diffusion 3 Medium Stable Diffusion 3 Large , também conhecida como SD3 8B. A SDXL 1.0, lembramos, é , no entanto, a SD3M, segundo os desenvolvedores, é . Pretendia-se que, com menores necessidades de memória de vídeo do que a da "Oversize", ela deveria gerar imagens "com um novo nível de fotorrealismo" mesmo em resposta a indicações simples. Entre as qualidades da troiso foram citados também "qualidade sem precedentes da tipografia do texto gerado em imagens", "compreensão aprofundada das indicações devido à combinação dos esforços de três codificadores simultaneamente" e "disponibilidade para um treinamento eficaz mesmo com conjuntos de dados limitados".
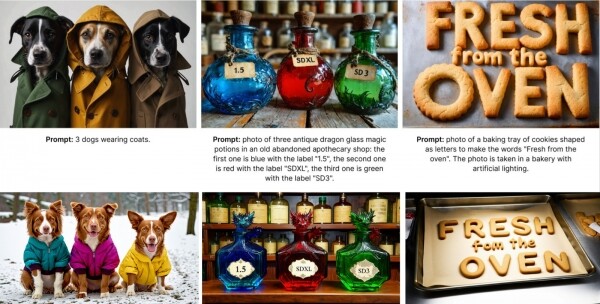
Era de se esperar, evidentemente, que a comunidade de entusiastas, com uma nova ferramenta tão aguardada em mãos, se dedicasse a aperfeiçoá-la com a mesma determinação que teve para a "halfbaked" e a "Oversize" em seu tempo. No entanto, desde o início, as coisas não saíram como planejadas: a SD3M conseguiu, nas primeiras horas após a publicação dos arquivos do modelo no Hugging Face e Civitai seu público, e isso aconteceu de duas maneiras distintas. A primeira foi uma inexplicável idiossincrasia em relação a indicações que incluíam uma frase aparentemente inofensiva como "deitado na / no grama"; a segunda foram as formulações extremamente obscuras no contrato de usuário, que mesmo advogados profissionais não conseguiram compreender de imediato. E embora, do ponto de vista de um entusiasta comum de arte em IA, isso possa parecer irrelevante, o aspecto legal terá um impacto direto no desenvolvimento futuro do modelo, podendo até mesmo resultar na ausência de qualquer evolução.
As criações anteriores da Stable Diffusion com código aberto (mais precisamente, com valores de pesos de rede neural disponíveis para download gratuito e execução local), como a SDXL, foram acompanhadas por uma das características típicas de modelos generativos com características como "licença de copyright perpétua, global, não exclusiva, gratuita, irrevogável, para reprodução, preparação, exibição pública, execução pública, sublicenciamento e distribuição de materiais adicionais, tanto do modelo em si quanto de derivações dele". A "Troika" prevê duas variedades de licenciamento: — com formulações bastante lenientes como "A Stability AI lhe concede uma licença não exclusiva, global, intransferível, não sublicenciável, revogável, gratuita e limitada sobre a propriedade intelectual" — e .
A grama não levará a coisa boa
Logo após um breve período, a comunidade chegou à conclusão de que . E essencialmente declarou boicote à empresa desenvolvedora, não querendo perder tempo e energia em treinar novamente um modelo claramente cru e mal elaborado — com a consciência de que a Stability AI pode a qualquer momento, por capricho de seus gerentes de mídia, revogar a licença anteriormente concedida a um entusiasta específico que realiza tal treinamento. O contrato de licença é formulado de tal maneira que aqueles que o estudam, advogados leigos, têm a impressão de que, após a revogação da permissão para uso comercial do SD3M, o antigo beneficiário estará obrigado a deletar todas as derivações que criou da propriedade intelectual a ele licenciada, incluindo tanto os próprios modelos treinados (LoRA, inversões de texto, checkpoints inteiros) quanto suas derivações (citação: "Após a rescisão deste Acordo, você deverá deletar e cessar o uso de quaisquer Produtos de Software ou Obras Derivadas") — ou seja, os frutos do trabalho de outras pessoas que usaram esses modelos derivados como ponto de partida para seu próprio trabalho; e isso feito sem qualquer pagamento, realizado movido apenas pelo puro entusiasmo.
Logo após o clamor de indignação atingir alturas estratosféricas, começaram a surgir relatos de juristas profissionais, E o que o feedback com a proibição de uso futuro realmente deve se referir apenas a alguns produtos auxiliares com código fechado, que a Stability AI entregará ao usuário comercial (digamos, para acelerar e otimizar a mesma pré-treinamento SD3M), — mas a empresa ainda não forneceu esclarecimentos finais sobre isso. E o próprio fato de um silêncio opressivo por já três semanas (no momento da redação deste artigo) desde o surgimento da "trinca" em acesso aberto prejudica a reputação do desenvolvedor muito mais do que a grama — que é gerada pela criação dele.
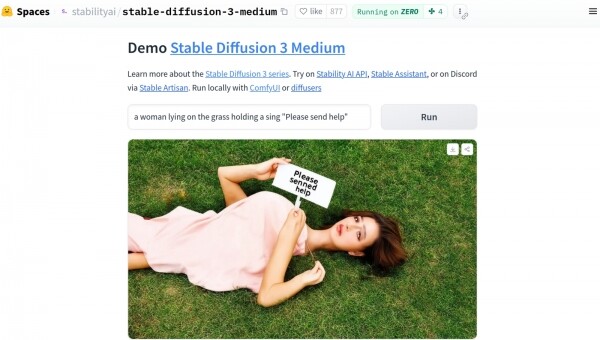
Quanto à infame grama, que se tornou literalmente um meme em questão de horas , e depois em praticamente todos os sites mais ou menos relevantes na rede, descobriu-se que a presença na sugestão de uma frase como "uma garota deitada na grama" leva à geração na saída da "trinca" não apenas de alucinações, mas de criações horríveis da fantasia doentia — no sentido médico — de artistas e cineastas que se especializam em body horror (suplicamos, se sua sanidade e vida são importantes para você, — mantenha-se longe disso e nem tente inserir essa frase na janela de busca de imagens com o filtro de segurança desligado). Nesse aspecto, imagens de pessoas em pé — e um pouco menos sentadas — são capturadas pela "trinca" com uma nota de quatro com um mais, e retratos às vezes se mostram impecáveis; pelo menos, não piores do que com o modelo básico SDXL 1.0, — o problema está exatamente em algum tabu interno sobre a posição horizontal do corpo humano.
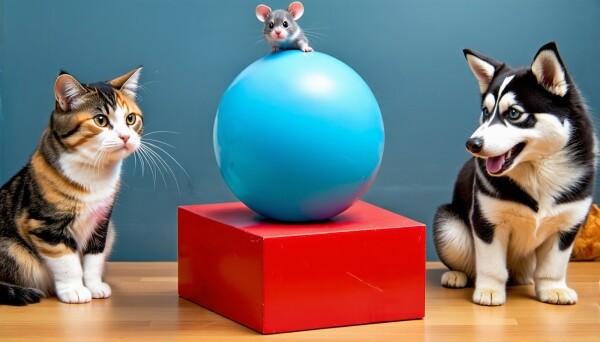
De acordo com o comentário de Emad Mostaque, fundador e ex-(até março de 2024) chefe da Stability AI, que saiu da empresa para , a brutalidade contra o SD3M logo antes da abertura de seus pesos para uso não comercial limitado (o API do modelo maior SD3 8B para geração online, lembramos, , mas seus pesos continuam ocultos) foi consequência da busca atual pela segurança — , formuladas ainda em março deste ano como . É exatamente dentro dessa política, utilizando o modelo generativo SD3M, que não é permitido aos usuários "cometer, promover, facilitar, encorajar, planejar, instigar ou contribuir para a violência, terrorismo ou a criação de conteúdo que incite o ódio, discriminando ou ameaçando grupos protegidos (seja por gênero, etnia, identidade ou orientação sexual, religião ou outros)" — portanto, nada de imagens de pandas, lutando com dragões enlouquecidos! Apenas gatinhos usando chapéus engraçados, cachorros em jaquetas adoráveis, garrafas com conteúdos desconhecidos e biscoitos fresquinhos, saindo do forno!
Falando tecnicamente, pode-se dizer que a modelagem foi um processo que consistiu na exclusão de imagens de pessoas deitadas e outras imagens que, de alguma forma, insinuavam interpretações impróprias do conjunto de dados de treinamento — e por isso agora a "três" simplesmente "não entende" o significado da palavra "deitar". Ou, talvez, a arquitetura atualizada do SD3 foi capaz de identificar de forma confiável os pesos nos perceptrons que se ativam ao gerar imagens "não seguras" — e esses pesos foram cuidadosamente zerados antes do lançamento, resultando no efeito colateral conhecido como "alucinação forçada". Provavelmente, : o codificador traduz corretamente o texto em tokens, mas no espaço latente "protegido" esses tokens não se referem mais a nada específico — e, portanto, os pixels resultantes são dispostos na imagem, essencialmente, aleatoriamente.
Considerando a disponibilidade da API de um modelo SD3 8B completo, mas fechado, há vários meses e as promessas calorosas dos gerentes de mídia da Stability AI de que a versão "compactada" 2B , os entusiastas da arte gerada por IA receberam com entusiasmo o lançamento público dos pesos do SD3M em 12 de junho: . No momento, ainda é possível obtê-la, embora de forma um pouco mais indireta do que é habitual para os checkpoints SDXL e SD 1.5. O caminho habitual é acessar o site Civitai, onde a maioria dos modelos pode ser baixada sem registro, mas a partir de 17 de junho e até o momento da redação deste artigo, a página dedicada ao 'terceiro' está . E a razão é uma só: a licença comercial para SD3M está redigida de forma tão confusa que até os advogados da Civitai precisaram de um tempo para estudá-la mais a fundo. Afinal, se algum entusiasta treinar em seu PC uma LoRA para o 'terceiro' e publicá-la na Civitai, e a Stability AI decidir que o resultado é inadequado e revogar a licença do responsável, — como fica o site host? Ele não está apenas hospedando checkpoints, ciclos auxiliares e modelos, mas também oferecendo aos visitantes a possibilidade de geração de imagens na nuvem, e o treinamento das mesmas LoRA, inversões textuais e assim por diante. Em resumo, enquanto a justiça não se decide, os arquivos do próprio modelo e três conversores de texto em tokens que vêm junto com ele só podem ser obtidos .
Vamos lá
No entanto, há um detalhe: para acessar os links de download, é necessário se registrar no site e, em seguida, confirmar a aceitação do mencionado anteriormente acordo de licença draconiana — no entanto, esse procedimento é gratuito e facilmente acessível a partir da Rússia. Há quatro opções de modelos (models) e quatro de conversores de sugestões de texto em tokens (encoders) disponíveis, além de três ciclos de referência para execução no ambiente de trabalho ComfyUI, :
modelos:
- sd3_medium.safetensors
- sd3_medium_incl_clips.safetensors
- sd3_medium_incl_clips_t5xxlfp8.safetensors
- sd3_medium_incl_clips_t5xxlfp16.safetensors
codificadores:
- clip_g.safetensors
- clip_l.safetensors
- t5xxl_fp8_e4m3fn.safetensors
- t5xxl_fp16.safetensors
ciclos:
- sd3_medium_example_workflow_basic.json
- sd3_medium_example_workflow_multi_prompt.json
- sd3_medium_example_workflow_upscaling.json
Na presente "Oficina", limitaremos-nos ao modelo básico sd3_medium.safetensors (4,2 GB), três codificadores — clip_g.safetensors (1,3 GB), clip_l.safetensors (234 MB) e t5xxl_fp8_e4m3fn.safetensors (4,7 GB), além do ciclo de trabalho sd3_medium_example_workflow_multi_prompt.json. O fato é que na nossa máquina de teste está instalada, vale lembrar, uma placa de vídeo GeForce GTX 1070 com 8 GB de VRAM, e esse volume não é suficiente para modelos maiores com todos os conversores integrados de uma vez. Nos checkpoints baseados em SD 1.5 e SDXL, os codificadores estão, por padrão, embutidos no arquivo principal, mas neste caso, há não dois, mas três desses conversores, totalizando mais de 6 GB — junto com o próprio modelo, já ultrapassa 10 GB; e se pegarmos a versão de 16 bits do codificador T5XXL, será necessária uma placa de vídeo ainda mais poderosa. No entanto, na variante em que os conversores de texto para tokens são carregados primeiro na memória de vídeo e então o modelo que trabalha com esses tokens, é possível usar até mesmo um adaptador gráfico de 6 GB. Sob esse aspecto, a "tríplice modular" definitivamente supera o típico checkpoint SDXL de 5-7 GB.
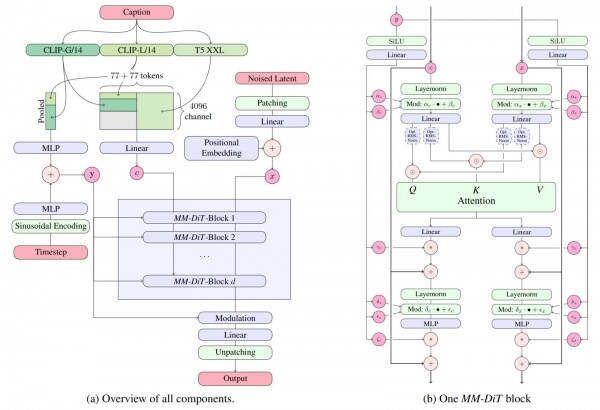
SD3M é um modelo baseado em transformadores de difusão multimodal () — e, por isso, se diferencia fundamentalmente de desenvolvimentos anteriores da Stability AI (e não só dela), que são baseados na A "Oficina" não é um lugar para um estudo profundo das diferenças entre essas abordagens de geração de imagens com IA; digamos apenas que , sua capacidade de trabalhar com um maior número de tokens (o que, por sua vez, permite ao operador formular dicas textuais bastante extensas, e ao sistema — segui-las de maneira bastante precisa), além de melhor qualidade das imagens obtidas. A SD3 8B em tamanho completo é capaz de gerar imagens em uma tela de 4 MP (2048×2048 pontos), além de em critérios como reprodução de texto na imagem, precisão de correspondência da imagem gerada com a dica textual e estética visual geral. A conversão de texto em vetor de tokens é feita aqui imediatamente por três codificadores ( e um T5-XXL — "T5", por sinal, da ) — e, de modo geral, eles não são obrigados a trabalhar com o mesmo prompt.
Mas chega de introduções: vamos ao que interessa na "Oficina" — a geração de imagens com base no modelo SD3M. Usaremos, como já foi mencionado, o ambiente de trabalho ComfyUI, que pode ser baixado . É importante ressaltar que esta versão é destinada apenas para execução em adaptadores gráficos NVIDIA ou diretamente em CPUs AMD ou Intel (que será, obviamente, muito mais lento): os proprietários de placas de vídeo AMD rocm e pytorch, que podem ser instalados através do gerenciador de pacotes pip.
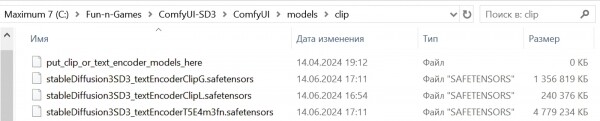
Após a instalação do ambiente de trabalho, deve-se colocar os arquivos .safetensors previamente baixados: os modelos no diretório ComfyUImodelscheckpoints, e os conversores de texto em tokens no ComfyUImodelsclip. E — é hora de começar!
É hora de acelerar
Vale mencionar que o AUTOMATIC1111, bem conhecido dos leitores das antigas "Oficinas" sobre desenho por IA, também , no entanto, no ComfyUI, o suporte ao novo modelo ainda é o mais completo. Não é surpreendente — pois até muito recentemente, o autor do “monstro de macarrão”, conhecido na comunidade de entusiastas como ComfyAnonimous, ou simplesmente Comfy, , onde trabalhou, entre outras coisas, no ambiente de trabalho interno que é utilizado pelos próprios desenvolvedores. Como veremos logo mais, a versão mais recente do ComfyUI realmente demonstra que seu autor possui certos insights sobre como essa modelo polêmico é estruturado e funciona — insights que os criadores de outros ambientes de trabalho para execução local do Stable Diffusion 3 Medium, por motivos óbvios, não podem se gabar.
Instalar o ComfyUI na versão portátil para Windows é muito simples: após baixar o arquivo ZIP correspondente basta descompactá-lo em qualquer diretório conveniente; de preferência, é claro, em uma partição lógica baseada em SSD, e não em HDD, uma vez que a troca entre o armazenamento e a memória considerando os ciclos de carregamento e descarregamento de modelos, mesmo para gerar uma única imagem (o sistema terá que primeiro colocar na VRAM os conversores de texto em tokens, em seguida limpar a memória de vídeo e carregar o SD3M em si) é esperado ser ainda mais considerável, especialmente se o computador em questão tiver pouca memória de vídeo disponível. A propósito, a instalação portátil é excelente também por sua total independência: nada — exceto a quantidade de espaço livre na unidade lógica — impede de implantar localmente quantas cópias do ComfyUI forem necessárias, permitindo experimentar à vontade com várias extensões, sem temer corromper um sistema já ajustado e funcionando bem.
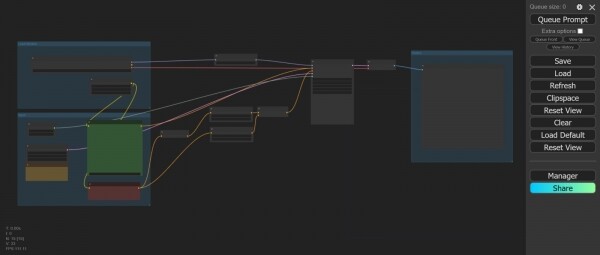
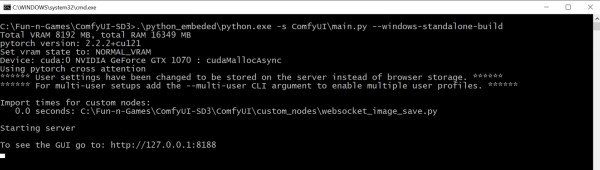
Confirmando que o arquivo do modelo principal SD3M sem codificadores de texto incorporados (o arquivo stableDiffusion3SD3_sd3Medium.safetensors, 4,2 GB) está colocado na subpasta checkpoints (no nosso teste de instalação, o caminho completo é C:Fun-n-GamesComfyUI-SD3ComfyUImodelscheckpoints), e que todos os três modelos de codificadores (os arquivos stableDiffusion3SD3_textEncoderClipG.safetensors, stableDiffusion3SD3_textEncoderClipL.safetensors e stableDiffusion3SD3_textEncoderT5E4m3fn.safetensors; 1,3 GB, 234 MB e 4,7 GB, respectivamente) estão na subpasta clip (C:Fun-n-GamesComfyUI-SD3ComfyUImodelsclip), você pode iniciar o ambiente de trabalho dando um clique duplo no arquivo run_nvidia_gpu.bat na pasta raiz (no nosso caso C:Fun-n-GamesComfyUI-SD3). Após o início do servidor, uma nova aba será automaticamente aberta no navegador padrão na janela do prompt de comando do Windows (isso é implicado pelas configurações do arquivo BAT), onde o interface web estará disponível no endereço 127.0.0.1/8188. (apenas numa primeira aproximação) 'monstro das massas'.
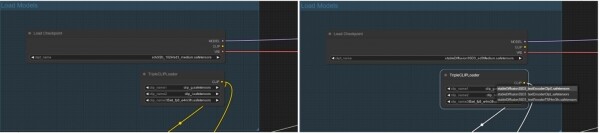
Basicamente, se você tem à disposição uma placa de vídeo NVIDIA mais moderna (da geração RTX em vez de GTX, mesmo que apenas com 6 GB de VRAM), você pode imediatamente carregar no ambiente de trabalho o fluxo do trabalho de referência criado pelo próprio ComfyAnonimous, já mencionado anteriormente — o arquivo comfy_example_workflows_sd3_medium_example_workflow_multi_prompt.json com várias janelas para entrada de prompts, uma para cada um dos três codificadores — e trabalhar com ele. No entanto, primeiro será necessário ajustar os quatro nomes dos arquivos dos modelos (nos nós de carregamento) para ficarem de acordo com os disponíveis. O autor do fluxo de trabalho de referência, aparentemente, operou em seu local de trabalho (na Stability AI, como já mencionado) com arquivos locais que eram nomeados um pouco diferente, então, se você clicar no botão “Queue Prompt” na interface espartana do ComfyUI logo após carregar o fluxo de trabalho, o ambiente dará uma mensagem de erro.
Agricultura de três campos para geração de IA
No entanto, isso pode ser corrigido facilmente: o que é realmente desanimador é que a nossa já velha GTX 1070 processa o SD3M de forma absurda e lenta — a geração da imagem leva de 27 a 30 segundos a cada iteração, e considerando que o parâmetro “Steps” no fluxo de trabalho de referência está definido como “28”, o tempo gasto é injustificadamente alto. Portanto, vamos realizar uma pequena otimização — usando o módulo Python venv (), que tem como objetivo, entre outras coisas, acelerar a operação dos modelos de IA generativa. Ele não está incluído na versão portátil do ComfyUI, , que basicamente se resumem a implantar um ambiente Python completo no PC local — e ativar o módulo necessário a partir desse ambiente.
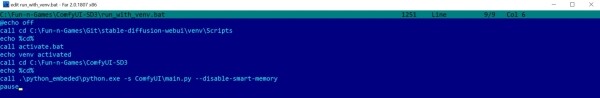
Vamos contar que os leitores que acompanham nossas “Oficinas” já possuem uma instalação do AUTOMATIC1111 ativa em suas máquinas. Nesse caso, tudo fica muito mais simples: o módulo venv já está implantado, e tudo o que é necessário fazer para ativá-lo ao iniciar o ambiente de trabalho ComfyUI é . Para começar, é necessário finalizar o trabalho do servidor, alternando para sua janela e pressionando «Ctrl» + «C», e então digitando «y» para confirmar; depois, copie o arquivo BAT run_nvidia_gpu.bat para um novo, com um nome como run_with_venv.bat. O arquivo de inicialização original é bastante conciso — ele simplesmente chama uma cópia portátil do Python com o parâmetro —windows-standalone-build:
.python_embededpython.exe -s ComfyUImain.py —windows-standalone-build
pausa
Esse parâmetro em si não é muito claro — ele implica algumas otimizações que, provavelmente, são projetadas para adaptadores gráficos NVIDIA mais novos e, por isso, podem complicar a vida de quem ainda mantém seus veneráveis GTX. Por essa razão, vamos remover —windows-standalone-build da linha de comando, e também abriremos mão de outra otimização moderna — o ‘gerenciador de memória inteligente’ ativo por padrão, smart memory, que , sem descarregá-las. Isso realmente acelera o desenho de imagens por IA, no entanto, torna nosso computador moralmente ultrapassado em um sistema de uma tarefa — não é mais possível navegar na web, jogar ou mesmo trabalhar com documentos e e-mail no PC ao mesmo tempo que a atividade do ambiente de trabalho. Portanto, para aqueles que não dispõem de um computador dedicado para artes da IA, um arquivo BAT para iniciar o ComfyUI (não apenas com o objetivo de gerar imagens com SD3M, aliás — ele também serve bem para SDXL) é o mais adequado:
@echo off
call cd C:Fun-n-GamesGitstable-diffusion-webuivenvScripts
echo %
call activate.bat
echo venv ativado
call cd C:Fun-n-GamesComfyUI-SD3
echo %
call .python_embededpython.exe -s ComfyUImain.py —disable-smart-memory
pausa
Aqui se presume que a instalação portátil do ComfyUI foi realizada no diretório C:Fun-n-GamesComfyUI-SD3, e que o AUTOMATIC1111 foi instalado anteriormente em C:Fun-n-GamesGitstable-diffusion-webui. Vários ‘echo’ são necessários apenas para controle visual do correto funcionamento da troca de diretórios e que os comandos necessários estão sendo executados — depois que tudo estiver ajustado, eles podem ser removidos do arquivo BAT.
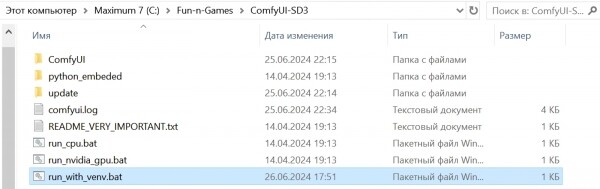
Vamos reiniciar o ambiente de trabalho, desta vez clicando duas vezes em run_with_venv.bat. Como anteriormente simplesmente fechamos o servidor e não mexemos na interface web, na aba correspondente ainda deve estar o mesmo fluxo de referência ComfyUI com os nomes dos modelos ajustados. Vamos prestar atenção na parte direita: ali está o nó 'Preview Image', que não salva a imagem gerada no disco, mas apenas a demonstra. Se ativarmos o fluxo a cada vez para gerar uma única imagem, avaliá-la visualmente, ajustar os parâmetros e reiniciar, isso pode funcionar: a imagem desejada sempre pode ser salva manualmente com um clique direito sobre ela. Mas se estivermos realizando várias gerações sequencialmente no ambiente de trabalho, é melhor que seus resultados sejam acumulados automaticamente na memória permanente (no diretório ComfyUIoutput por padrão).
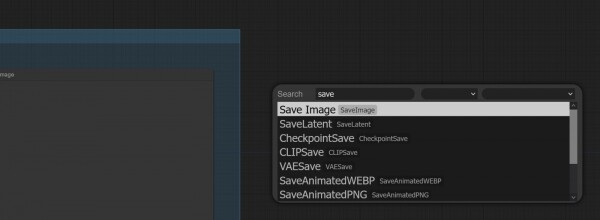
Então é melhor trocar o nó 'Preview Image' por 'Save Image'. Para isso, clique duas vezes em qualquer área livre do fluxo — uma janela de seleção de nós com uma barra de pesquisa será aberta. Nesta barra, começaremos a digitar 'Save...' — e quase imediatamente veremos o nome desejado. Depois, basta clicar nele e conectar a entrada do nó que apareceu à saída 'IMAGE' do nó 'VAE Decode', que originalmente estava conectado ao 'Preview Image'. O 'Preview Image' pode ser removido a seguir — apenas selecione-o clicando no cabeçalho e pressione a tecla 'Del' no teclado.
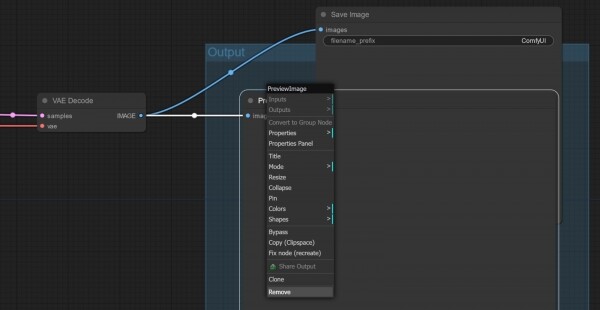
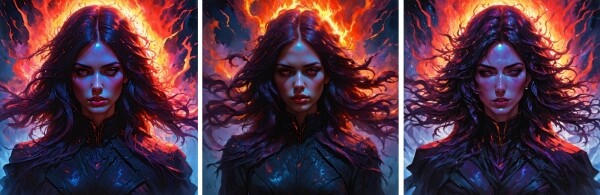
E agora — é hora de executar o fluxo de referência criado por ComfyAnonimous (com nossas humildes correções). O resultado é o seguinte:
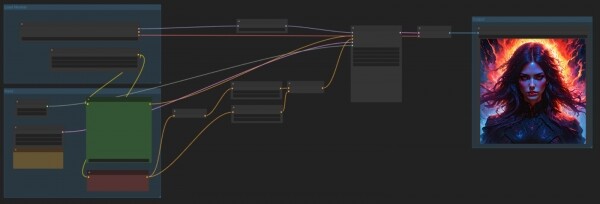
Uma imagem bastante impressionante, até com uma certa atmosfera — e não dá para dizer que foi criada usando o mesmo modelo que a instrução para desenhar pessoas deitadas na grama, que totalmente desmorona. Ao mesmo tempo, o sistema funciona de forma bastante ágil — cerca de 5-6 segundos por iteração para uma imagem com área de 1 MP no GTX 1070 pode ser considerado um bom resultado. Para comparação: o mesmo PC na mesma ComfyUI com o mesmo arquivo BAT gera imagens SDXL de tamanhos semelhantes, gastando cerca de 6-7 segundos em cada iteração, então a 'três' pode ser considerada menos exigente em relação ao hardware do PC, onde a geração de IA é realizada.
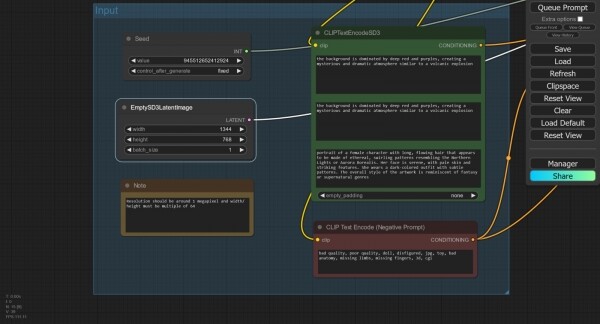
Agora vamos ajustar as dimensões da tela. Perto do nó "EmptySD3LatentImage", que define essas dimensões, está o nó de referência "Note", que está "vazio" (ou seja, não conectado a nada). Dentro dele há um lembrete importante: a área total da imagem em caso de SD3M deve ser de aproximadamente 1 megapixel, e é com base nisso que devem ser escolhidas as dimensões do retângulo da tela. Definiremos as dimensões como 1344×768 — o que resulta em aproximadamente 1,03 megapixel.
Observe: acima há o nó "Seed", onde a semente de fato está definida, neste caso "945512652412924", e é indicado que ela não deve mudar após a geração (parâmetro "fixed").
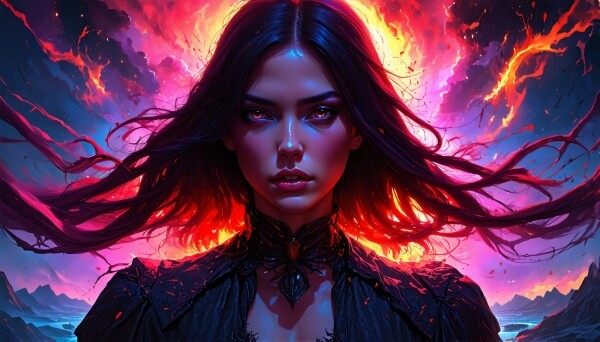
Executaremos o mesmo ciclo com a semente anterior, mas agora para a tela retangular. Logo se percebe que o tempo total de execução é menor, embora a velocidade de renderização tenha permanecido a mesma — menos de 6 segundos por iteração. E isso faz sentido: como as dicas textuais não mudaram, não é necessário carregar novamente o(s) codificador(es) para elas. A imagem gerada, como é evidente, difere um pouco da primeira, quadrada, mas não é fundamental — a composição geral, como era de se esperar, foi mantida.
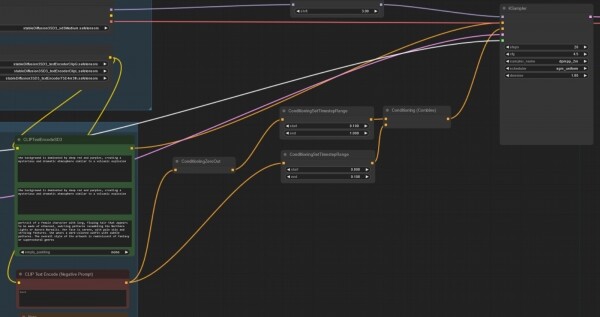
Agora vamos prestar atenção nos nós "CLIPTextEncodeSD3" e "CLIP Text Encode (Negative Prompt)". O primeiro se destaca por conter três campos de entrada; se removermos o texto desses campos, se tornarão visíveis as anotações sobre quais codificadores eles são destinados — de cima para baixo: CLIP G, CLIP L e T5XXL. Anteriormente, não havia nós desse tipo no ComfyUI por razões compreensíveis. O ciclo de referência contém dicas curtas e duplicadas para os dois primeiros campos de texto (para os codificadores CLIP G e CLIP L) e uma muito mais extensa para o terceiro — T5XXL. É claro que o conteúdo desses campos pode ser manipulado em uma ampla faixa, e o próprio estudo de como a alteração do texto neles afeta a imagem final representa uma tarefa desafiadora, mas extremamente fascinante. Contudo, por razões que se tornarão claras um pouco mais tarde, não nos aprofundaremos nisso por enquanto.
Na nódulo «CLIP Text Encode (Negative Prompt)», por outro lado, não há nada de especial — mas considere o quão complicado é o caminho entre ele e a entrada correspondente «conditioning» do nódulo principal «KSampler»! Esse caminho se bifurca, e uma de suas ramificações (a parte superior, neste caso) indica que, começando a partir de 10% dos passos de geração até sua conclusão, o sistema não levará em conta a sugestão negativa (navegar pelo nódulo «ConditioningZeroOut» significa efetivamente anular a condição). Enquanto a segunda ramificação permite que a sugestão negativa (ainda que condicionalmente com peso reduzido) prossiga para o próximo processamento sem alterações — mas apenas nos primeiros 10% do número total de passos de geração.
Um distante nebuloso
Mais uma vez: nos primeiros 10%, ou seja, 3 de 28 designados neste caso, a sugestão negativa é enviada para o nódulo «KSampler», que está ocupado formando a imagem no espaço latente (no espaço de pixels, ou seja, em uma imagem compreensível para o ser humano, cujo resultado é exibido pelo próximo nódulo, «VAE Decoder»), de maneira normal: a ramificação superior (com a anulação da condição) está inativa, apenas a parte inferior está em operação. Já os 90% restantes dos passos (25 de 28 no nosso caso) a sugestão negativa não funciona de forma alguma: a parte superior da transmissão de condições está ativa — com sua anulação — enquanto o movimento pela parte inferior é bloqueado pelo parâmetro de acionamento correspondente do nódulo «ConditioningSetTimestepRange». Agora está claro porque alguns revisores afirmam que , — o efeito delas (se considerarmos exatamente este, o ciclo base, e presumirmos que em sites com geração online pelo modelo SD3 Medium existem regras semelhantes) é mínimo.
E ainda assim, ele existe: se simplesmente conectar diretamente a saída do nó "CLIP Text Encode (Negative Prompt)" à entrada correspondente do "KSampler" (ou marcar todos os nós intermediários com condições nesse caminho como "bypass"), a qualidade da imagem final piora consideravelmente. Isso, aliás, pode ser visto como uma prova indireta da "não-treinabilidade" do SD3M, uma vez que ajustar a força e a importância do prompt negativo, a rigor, deveria ser algo que os desenvolvedores conseguiram fazer antes de disponibilizar os pesos do modelo ao público. Duas ramificações de condições engenhosamente estabelecidas para a aplicação do prompt negativo são uma espécie de remendo e, nesse sentido, às expectativas inflacionadas pelo departamento de marketing da Stability AI a seu respeito soam bastante justificadas.
A falta de pelo menos um breve guia oficial sobre como trabalhar com o SD3M levou a rumores na internet de que este modelo O que, claro, não é verdade, mas de qualquer forma, esses prompts precisam ser aplicados de forma bem diferente Em particular, os entusiastas afirmam seriamente que adicionar ao campo negativo descrições detalhadas de quantidades máximas de obscenidades (sim, o velho e bom "nsfw, nude" não é suficiente — você terá que usar a imaginação) mesmo da famosa garota deitada na grama. Se isso é verdade ou não — não será descoberto sem uma verificação cuidadosa (e não é certo que mesmo a marcação "18+" no cabeçalho do nosso site protegerá a publicação de processos legais por parte de fervorosos defensores da moralidade, caso arriscemos publicar o "milagre-prompt" organizado por entusiastas — mesmo que esteja em inglês). Essa situação engraçada lembra o caso com graças aos quais — precisamente porque continham descrições bastante detalhadas do que e como não deveria ser feito por bons cristãos — chegaram até nós pelo menos fragmentos de relatos escritos sobre crenças e costumes da Rússia pré-cristã.
Agora, espera-se que tenha ficado mais claro por que se aprofundar no estudo do SD3M nesta fase não parece ser o uso mais razoável de energia e tempo. Realmente há muito a ser discutido e explorado: e os parâmetros de geração recomendados de forma bastante rigorosa no nó "KSampler" (CFG — 4,5-5,0; número de passos — cerca de 28; par sampler/scheduler — exclusivamente dpmpp_2m/sgm_uniform, caso contrário, a qualidade da saída cai significativamente); e uma variação bastante significativa na qualidade subjetiva das gerações com parâmetros iniciais exatamente iguais, mas com diferentes sugestões; e a eliminação da famosa "maldição de ficar deitado na grama" (para a qual já ); e, na verdade, descobrir quais parâmetros de geração cada um dos três conversores de texto em tokens realmente influencia — e como, ao manipulá-los, conseguir criar verdadeiras obras-primas de Arte Visual de IA (se isso for possível com a "três", é claro).
Ainda mais considerando que a demissão de Emad Mostaque em março e ComfyAnonymous em junho, , — não são as únicas dificuldades enfrentadas pela Stability AI. Como reportou a Reuters citando o The Information, esta startup britânica acabou de que agora é Prem Akkaraju, indicado por um conhecido grupo global de investidores em TI — e esse grupo, por sua vez, está pronto para injetar na empresa uma quantia considerável em dinheiro (). A situação da Stability AI como uma estrutura de negócios hoje está francamente instável; muitos entusiastas desapontados prevêem seu rápido fim — e nessa situação é difícil esperar que a empresa faça um trabalho cuidadoso mesmo em erros tão óbvios.
Uma política de licenciamento mal planejada, infelizmente, impede a comunidade de aprimorar o SD3M de forma independente, como ocorreu com o SD 1.5 e SDXL. Pelo menos, os checkpoints derivados e ferramentas como LoRA para os dois últimos modelos certamente continuarão disponíveis para execução local, mesmo quando (e se) a Stability AI encerrar seu caminho como uma entidade comercial. Logo após o fracasso retumbante da ‘tríplice’ nos fóruns especializados, começaram a surgir cada vez mais vozes em apoio à criação de um projeto não comercial para o desenvolvimento de um modelo generativo para a conversão de texto em imagens, com base em crowdfunding — e até o momento esse movimento começa a se estruturar sob o nome . A Invoke (uma das plataformas de geração de IA online voltada para estúdios profissionais), Comfy Org (uma equipe dedicada ao suporte e desenvolvimento do ComfyUI), Civitai (que não precisa de apresentações) e a equipe por trás da LAION (banco de imagens anotadas, no qual essas modelos são em grande parte treinadas) já manifestaram sua disposição de se unir ativamente a ele.
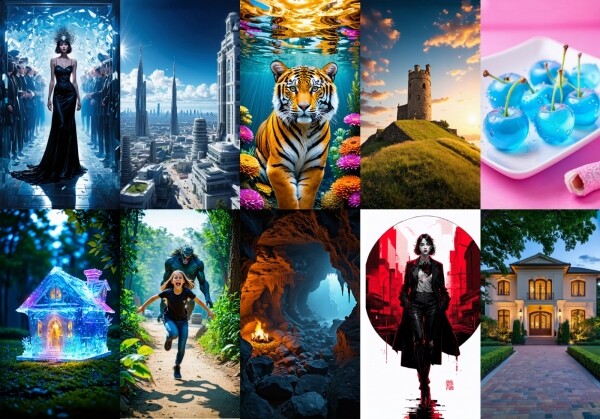
Portanto, no horizonte próximo, os novos lançamentos da ‘Oficina’ provavelmente se concentrarão no trabalho com aqueles modelos para os quais a comunidade já conseguiu criar um amplo conjunto de melhorias e ferramentas adicionais — sobre a ‘1.5’ e o ‘OverSize’. Talvez o tempo de glória do SD3M ainda chegue — mas hoje é difícil até imaginar quando exatamente. Enquanto isso, os interessados podem baixar o arquivo com as gerações do SD3M apresentadas neste artigo (os ciclos de imagem estão integrados diretamente nos arquivos PNG; basta arrastar a imagem para o campo de trabalho do ComfyUI a partir do ‘Explorador’ do Windows para reproduzir toda a sequência e os parâmetros de geração) . Talvez algum dos nossos leitores consiga descobrir antes dos frequentadores do Reddit e do Hugging Face a melhor forma de distribuir o texto em três campos de dica, por exemplo?
Materiais relacionados:
.
.
.
.
.
Fonte: 3dnews.ru
