

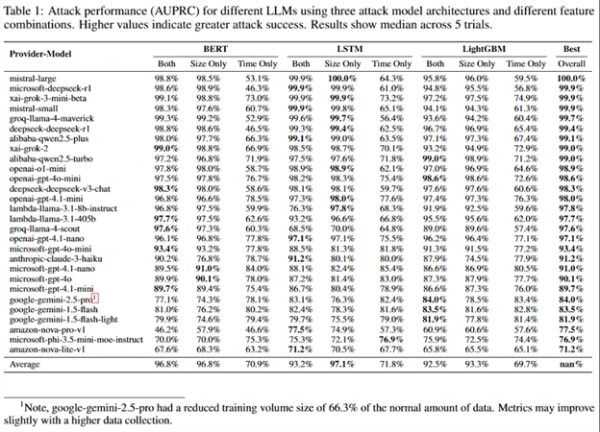
Pesquisadores de segurança da Microsoft desenvolveram uma técnica de ataque de canais laterais chamada Whisper Leak, que permite, com base na análise passiva do tráfego criptografado transmitido através de uma conexão TLS, classificar os temas das solicitações aos serviços baseados em grandes modelos de linguagem. Informações sobre o tamanho dos pacotes de rede e os atrasos entre suas transmissões foram suficientes para determinar os temas das solicitações aos chatbots AI com uma precisão superior a 98%. Na prática, o método proposto pode ser usado para identificar, no tráfego em trânsito do usuário, certos temas de solicitações, como tentativas de obter informações sobre ações ilegais, sem a necessidade de decifrar o conteúdo.
A ferramenta para extração de dados de dumps de tráfego, treinamento de modelos e testes do método está publicada no GitHub. A possibilidade de realizar o ataque foi demonstrada para 28 grandes modelos de linguagem populares dos maiores fabricantes. Por exemplo, a precisão na identificação de solicitações sobre o tema "lavagem de dinheiro" para muitos serviços de IA atingiu 100%, tendo no tráfego analisado 1 solicitação desejada e 10.000 solicitações não relacionadas ao tema.
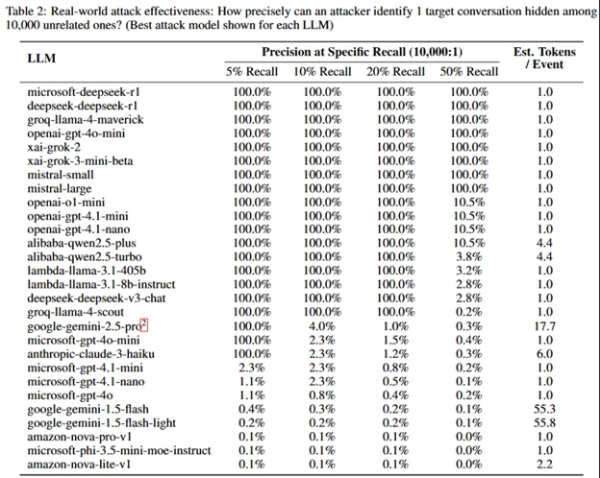
A causa da vazamento de informações é que os modelos geram a resposta à solicitação passo a passo, um token de cada vez, utilizando o token anterior como contexto para determinar a próxima palavra ou frase mais provável. Assim, para cada token, um pacote de rede separado é enviado e o atraso entre os pacotes corresponde ao atraso entre a determinação do próximo token pelo modelo.
No TLS, se não houver compressão de dados, o tamanho do texto cifrado é igual ao tamanho do texto não cifrado mais uma constante. Ao criar um modelo que correlacione os conjuntos de tokens desejados com o tamanho dos pacotes e os atrasos entre seus envios, é possível determinar com boa precisão a presença dos tópicos desejados no tráfego. No curso da pesquisa, foram preparados três modelos de aprendizado de máquina semelhantes, baseados nas arquiteturas de redes neurais LightGBM, Bi-LSTM e BERT. Para cada modelo, foram realizados experimentos para identificar o tópico desejado analisando apenas o tamanho dos pacotes, apenas os atrasos entre os pacotes e ambos os critérios.
Para reduzir a eficácia da análise passiva dos temas das consultas, os desenvolvedores de serviços de IA são aconselhados a anexar preenchimento adicional aleatório, bufferizar a transmissão de tokens ou executar a substituição de pacotes fictícios.
Fonte: opennet.ru
