

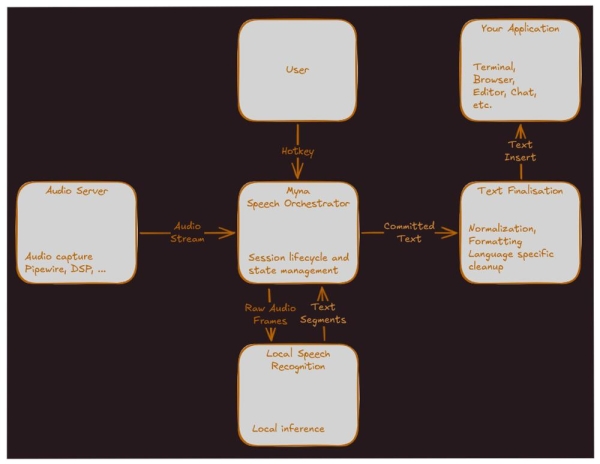
A Canonical apresentou o projeto Myna — um novo sistema de conversão de fala em texto para Ubuntu Desktop. O projeto visa a ditado embutido: o usuário pressiona uma tecla de atalho, fala e o texto reconhecido aparece no aplicativo ativo. O anúncio enfatiza que o Myna deve ser sentido como uma parte natural da área de trabalho do Ubuntu e deve funcionar levando em conta a privacidade do usuário. A lista de idiomas de entrada suportados no momento da publicação da notícia não foi divulgada.
O primeiro objetivo do projeto — Ubuntu 26.10. Neste estágio, a Canonical não está tentando criar um assistente de voz completo ou um sistema de controle da área de trabalho por voz. Os desenvolvedores deliberadamente limitaram o escopo da primeira versão ao ditado básico e confiável: pressionar a combinação de teclas, pronunciar o texto e obter o resultado no campo de entrada atual. O ambiente de teste inicial é o Ubuntu Desktop no Wayland com GNOME, mas a arquitetura está planejada para ser suficientemente aberta para suporte futuro a outros ambientes.
O Myna é projetado para reconhecimento de fala local. Após a instalação dos modelos necessários, uma conexão à internet não é necessária para o funcionamento do ditado; o microfone só deve ser utilizado após a ativação explícita pelo usuário, o áudio é processado na memória e depois descartado, e as gravações não são enviadas para serviços externos. A especificação do projeto também indica que a solução deve evitar salvar áudio por padrão e não deve mudar silenciosamente para um serviço em nuvem.
O código e a documentação do Myna estão publicados no repositório da Canonical em GitHub. O projeto é descrito como um aplicativo leve de fala para texto para Ubuntu Desktop e é distribuído sob a licença GPL-3.0. No entanto, o projeto está em estágio inicial: no repositório ainda não há lançamentos publicados e a especificação arquitetônica tem o status de Proposta.
Principais funções e características do Myna
Ditado push-to-talk. O usuário mantém pressionada uma tecla de atalho configurável, fala, e o sistema insere o texto reconhecido no campo de entrada selecionado. O ditado é concluído quando a tecla é solta.
Reconhecimento local de fala. O reconhecimento é realizado na máquina do usuário através de um stack local de inferência. Isso reduz a dependência da nuvem e permite funcionamento sem rede após a instalação dos modelos.
Processamento de áudio privado. O microfone é ativado apenas durante a sessão de ditado do usuário. O áudio não deve ser gravado no disco por padrão, sendo utilizado um buffer de memória limitado que é limpo após a conclusão da sessão.
Indicador visual de atividade. Durante a gravação e transcrição, o usuário deve ver um indicador de status claro. A especificação menciona estados como Gravando, Transcrevendo, Finalizando e Erro.
Inserção apenas de texto estável. Na primeira implementação, as hipóteses intermediárias de reconhecimento não devem ser inseridas diretamente no aplicativo. No campo de destino, apenas o texto final confirmado é enviado.
Pós-processamento de texto. A transcrição bruta pode passar por normalização, pontuação, capitalização, formatação e conversão de formas faladas para escritas, por exemplo, 'twenty two' → '22'.
Seleção do idioma de ditado. O sistema deve suportar um idioma de ditado configurável, com o idioma da interface do usuário como padrão, se um modelo adequado estiver disponível.
Perfis de qualidade do modelo. A especificação prevê diferentes perfis de modelos: uma versão leve com menor consumo de recursos, um perfil padrão equilibrado e uma versão de maior qualidade, mas mais pesada.
Operação segura com foco de entrada. O destino para a inserção de texto é escolhido no início da sessão. Se o foco da janela mudar durante o ditado, o sistema não deve enviar silenciosamente texto para outro aplicativo.
Bloqueio em campos protegidos. O ditado deve ser bloqueado em campos de senha, janelas de autenticação e outros locais protegidos, se o aplicativo ou toolkit permitir essa detecção.
Integração com Wayland/GNOME. A primeira versão é voltada para Wayland e GNOME. Para a inserção inicial de texto, o IBus é considerado, e no futuro está planejado um caminho mais nativo pelo Wayland através dos protocolos input-method/text-input.
Configurações do usuário. Na interface de configurações planejada, devem ser incluídas opções para ativar/desativar STT, escolher teclas de atalho, idioma de ditado, microfone, perfil do modelo, opções de pós-processamento e indicador de atividade.
Na primeira iteração, as funções que ficam fora do projeto são: despertar por meio da frase-chave, monitoramento constante em segundo plano, reconhecimento em nuvem, assistente de voz, comandos de voz, controle de desktop, tradução de fala, identificação do falante, detecção automática de idioma e histórico de ditados. Em outras palavras, a Canonical não começa com um "assistente de IA", mas com uma função mais prática: entrada de voz local para aplicativos comuns do Ubuntu.
Fonte: linux.org.ru
