

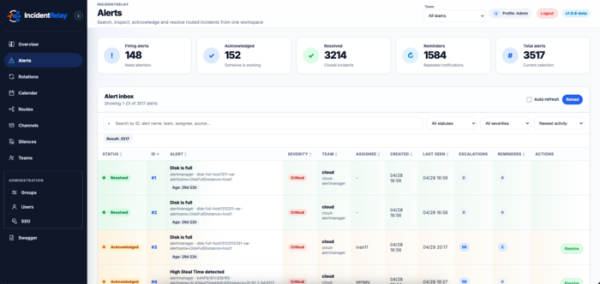
Após cinco meses de desenvolvimento, foi lançado o projeto IncidentRelay 1.1, que desenvolve um sistema aberto para a organização de turnos, roteamento de notificações e acompanhamento de incidentes, executável em um servidor próprio (self-hosted). O IncidentRelay 1.1 é marcado como a primeira versão estável (a ramificação 1.0 tinha status de versão beta). O projeto é voltado para equipes de SRE, DevOps e infraestrutura que necessitam de uma alternativa local para serviços SaaS de gestão de turnos (on-call management), aplicação de políticas de escalonamento e resposta a incidentes. O código do projeto é escrito em Python e é distribuído sob a licença MIT.
O IncidentRelay aceita eventos de sistemas de monitoramento, correlaciona-os com o serviço, equipe e rotação, e depois entrega as notificações aos atendentes responsáveis ou equipes. O sistema implementa cronogramas de turnos, rotações, redefinições de turnos, confirmação de recebimento de incidentes, estados ACK/Resolve, lembretes, escalonamentos, substituições temporárias de atendentes, determinação de horários de manutenção programada e supressão de alertas ruidosos.
A principal vantagem do projeto é o controle total sobre a infraestrutura e a lógica de roteamento. O IncidentRelay é implantado em seu próprio ambiente, trabalha com seu próprio banco de dados e permite uma separação clara entre as rotas de entrada, equipes, rotações e canais de entrega. Os tokens de entrada pertencem às rotas, e não aos canais, por isso é mais fácil entender qual fonte externa tem permissão para enviar eventos para uma equipe específica.
No IncidentRelay, é suportada a recepção de eventos do Prometheus Alertmanager, Grafana Alerting, Zabbix, Sentry, LibreNMS, RMON, AWS SNS/CloudWatch e webhook variados. Para o envio de notificações, são disponibilizados canais como Mattermost, Slack, Telegram, Discord, Microsoft Teams, email, webhooks, push de navegador/PWA e provedores de chamadas de voz. No Mattermost e Telegram, as notificações podem conter ações para confirmação e resolução de problemas, o que permite lidar com o incidente sem precisar acessar um interface separado.
O projeto pode ser executado via Docker Compose, pacote RPM para distribuições semelhantes ao Red Hat, manualmente através do systemd, além de no Kubernetes com a ajuda do Helm chart. Para pequenas instalações, é possível usar SQLite; para sistemas de produção e maior carga, recomenda-se PostgreSQL.
A nova versão oferece as seguintes alterações:
- Adicionadas rotações de plantão em múltiplos níveis com restrições de tempo, prioridades de camadas e consideração de substituições temporárias;
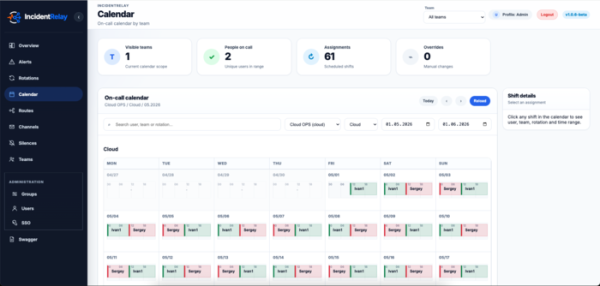
- Foi adicionado um calendário de plantão, CalDAV e assinaturas ICS para calendários externos;
- Implementadas políticas de escalonamento de incidentes com cadeias de escalonamento em várias etapas;
- Adicionados grupos de alertas, agrupamento de eventos, notificações adiadas e combinação manual de alertas relacionados;
- Adicionadas janelas para manutenções programadas e alertas 'silenciosos';
- Adicionada a possibilidade de adicionar comentários aos alertas;
- Adicionados prioridades de incidentes (P1-P5) e aumento automático de prioridade conforme o nível de importância;
- Implementado catálogo de serviços, dependências de serviços, SLI/SLO, histórico de impacto no funcionamento dos sistemas (Service Impact History) e serviços empresariais (Business Services);
- Introduzido o Explain Trace para análise de roteamento: por que o alerta entrou ou não na equipe, foi agrupado, suprimido ou enviado para um canal específico;
- Adicionadas verificações (Heartbeats/dead-man-switch) para watchdog, backup, ETL e outras tarefas onde a ausência do sinal esperado é um problema.
Fonte: opennet.ru
