

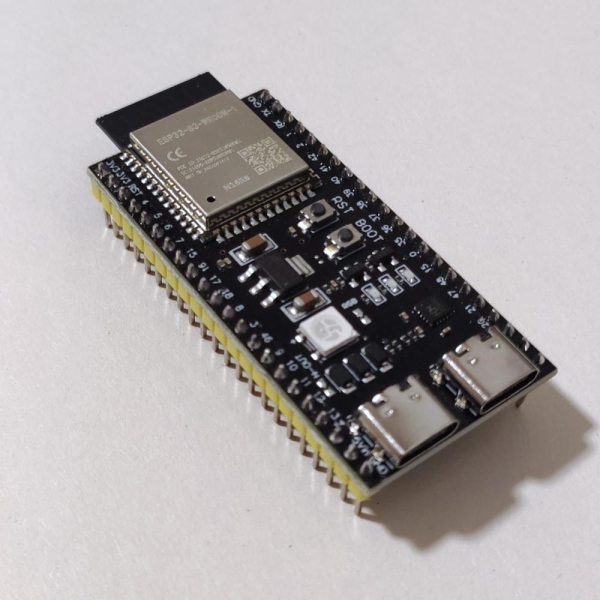
O desenvolvedor Vyacheslav Serbov, que atua sob o pseudônimo slvDev, demonstrou desenvolveu uma geração de texto completamente local no microcontrolador ESP32-S3. O modelo de linguagem criado por ele contém 28,9 milhões de parâmetros e gera cerca de 9,9 tokens por segundo, sem acessar um servidor ou outros recursos computacionais externos. As histórias curtas geradas são exibidas em um OLED conectado.
Projeto esp32-ai testado no módulo ESP32-S3 N16R8, que possui 512 KB de SRAM embutida, 8 MB de PSRAM e 16 MB de memória flash. O modelo quantizado para quatro bits ocupa 14,9 MB. O repositório contém o código-fonte do ambiente de execução em C, ferramentas de treinamento e quantização do modelo, firmware, testes e scripts para carregá-lo na placa.
Os 28,9 milhões de parâmetros reivindicados não devem ser comparados diretamente ao número de parâmetros dos LLMs de desktop convencionais. De acordo com o relatório detalhado do desenvolvedor, o modelo consiste em um núcleo computacional denso de aproximadamente 559 mil parâmetros, uma camada de saída de 3,1 milhões de parâmetros e uma tabela de representações vetoriais em camadas de cerca de 25 milhões de parâmetros. É esta última que fornece a maior parte do tamanho formal do modelo, mas não é processada inteiramente ao gerar cada token.
Para hospedagem do modelo, três níveis de memória são utilizados. Os dados mais frequentemente utilizados estão na SRAM interna, a camada de saída, o cache KV e os buffers temporários estão na PSRAM, enquanto a tabela de 25 milhões permanece na memória flash e está acessível via mapeamento no espaço de endereço. Para cada token, apenas cerca de seis linhas são lidas, totalizando aproximadamente 450 bytes.
Esse dispositivo é baseado na tecnologia Per-Layer Embeddings, aplicada pelo Google no Gemma 3n. De acordo com a documentação do Google, os parâmetros PLE podem ser armazenados fora da memória de trabalho do modelo e adicionados ao processo de saída conforme os diferentes camadas são processadas. No esp32-ai, essa abordagem foi transferida para a hierarquia de memória do microcontrolador, onde a SRAM rápida é particularmente limitada.
A primeira versão funcional do ambiente de execução escrito em C fornecia apenas 0,57 tokens por segundo. Após a colocação da camada de saída na PSRAM, a transição para ativações de oito bits, a distribuição de cálculos entre os dois núcleos Xtensa LX7 e outras otimizações, a latência foi reduzida para 94,9 ms por etapa do modelo. A velocidade medida final alcançou 9,88 tokens por segundo, levando em conta todo o processo de geração. O principal limite agora é a largura de banda da PSRAM ao ler a camada de saída.
O modelo foi treinado em um conjunto de dados sintético TinyStories, consistindo em histórias simples em inglês com vocabulário limitado. Portanto, ele é capaz de continuar frases e compor pequenas histórias coerentes, mas não é destinado a responder perguntas, executar instruções, programar ou reproduzir conhecimentos factuais. O desenvolvedor vê o trabalho principalmente como uma demonstração da colocação eficaz do modelo na memória de um microcontrolador, e não como um chatbot autônomo pronto para uso.
Na documentação atual, o autor enfatiza que o esp32-ai é um desenvolvimento autônomo. Os projetos llama2.c de Andrei Karpaty e o lançamento anterior do modelo de 260 mil parâmetros no ESP32-S3 são citados apenas como referências e exemplos de trabalhos anteriores: o código, os pontos de verificação e a metodologia não foram diretamente extraídos deles. O código-fonte do esp32-ai é distribuído sob a licença MIT.
Fonte: linux.org.ru
