

Olá, Habr!
No outono do ano passado, ocorreu no Kaggle uma competição de classificação de desenhos feitos à mão chamada Quick Draw Doodle Recognition, na qual, entre outros, participou a equipe de R. , e . Não vamos descrever a competição em detalhes, isso já foi feito na .
Desta vez, não conseguimos conquistar medalhas, mas adquirimos muita experiência valiosa, por isso gostaria de compartilhar com a comunidade algumas das coisas mais interessantes e úteis no Kaggle e no trabalho diário. Entre os tópicos abordados estão: a vida difícil sem OpenCV, parsing de JSON (nestes exemplos, a integração de código em C++ em scripts ou pacotes em R é discutida através do Rcpp), parametrização de scripts e dockerização da solução final. Todo o código da mensagem está disponível em um formato executável na .
Conteúdo:
1. Carregamento eficiente de dados de CSV para o banco de dados MonetDB
Os dados nesta competição não são fornecidos como imagens prontas, mas na forma de 340 arquivos CSV (um arquivo para cada classe), contendo JSONs com coordenadas de pontos. Conectando esses pontos com linhas, obtemos a imagem final com dimensão de 256x256 pixels. Também para cada registro, é fornecido um rótulo indicando se a imagem foi reconhecida corretamente pelo classificador utilizado na coleta do dataset, um código de duas letras do país de residência do autor do desenho, um identificador único, um carimbo de data/hora e o nome da classe, que coincide com o nome do arquivo. A versão simplificada dos dados originais pesa 7,4 GB em um arquivo compactado e cerca de 20 GB após descompactação; os dados completos após a descompactação ocupam 240 GB. Os organizadores garantiram que ambas as versões reproduzem os mesmos desenhos, ou seja, a versão completa é redundante. De qualquer forma, armazenar 50 milhões de imagens em arquivos gráficos ou como matrizes de imediato foi reconhecido como não rentável, e decidimos mesclar todos os arquivos CSV do arquivo train_simplified.zip em um banco de dados com a posterior geração de imagens do tamanho necessário "on-the-fly" para cada batch.
Como SGBD, escolhemos o já bem estabelecido MonetDB, ou seja, a implementação para R na forma de pacote . O pacote inclui a versão embutida do servidor de banco de dados e permite iniciar o servidor diretamente da sessão R e trabalhar com ele. A criação do banco de dados e a conexão são realizadas em um único comando:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Precisamos criar duas tabelas: uma para todos os dados, e outra para informações auxiliares sobre os arquivos carregados (útil se algo der errado e o processo precisar ser retomado após o carregamento de vários arquivos):
Criação de tabelas
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
A maneira mais rápida de carregar dados no banco de dados foi através da cópia direta de arquivos CSV usando SQL — o comando COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT, onde tablename — nome da tabela e path — caminho para o arquivo. Ao trabalhar com o arquivo compactado, descobrimos que a implementação embutida unzip em R não funcionava corretamente com vários arquivos do arquivo compactado, portanto usamos o sistema unzip (usando o parâmetro getOption("unzip")).
A função para gravação no banco de dados
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
Caso seja necessário transformar a tabela antes de gravá-la no banco de dados, basta passar como argumento preprocess função que irá transformar os dados.
Código para o carregamento sequencial dos dados no banco:
Gravação de dados no banco
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
O tempo de carregamento dos dados pode variar dependendo das características de velocidade do dispositivo utilizado. No nosso caso, a leitura e gravação dentro de um mesmo SSD ou de um pen drive (arquivo de origem) para o SSD (banco de dados) leva menos de 10 minutos.
Alguns segundos adicionais são necessários para criar uma coluna com uma etiqueta de classe inteira e uma coluna de índice (ORDERED INDEX) com os números das linhas, que será utilizada para selecionar as observações ao criar os lotes:
Criação de colunas adicionais e índice
message("Gerar rótulos")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Gerar números das linhas")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
Para resolver a tarefa de formar um lote "em tempo real", precisávamos alcançar a máxima velocidade na extração de linhas aleatórias da tabela doodles. Para isso, utilizamos 3 truques. O primeiro consistia em reduzir a dimensionalidade do tipo que armazena o ID da observação. No conjunto de dados original, para armazenar o ID, é necessário o tipo bigint, mas a quantidade de observações permite acomodar seus identificadores, equivalentes ao número ordinal, em um tipo int. A busca, nesse caso, ocorre de forma significativamente mais rápida. O segundo truque foi o uso de ORDERED INDEX — essa solução foi alcançada empiricamente, analisando todas as opções disponíveis . O terceiro consistia no uso de consultas parametrizadas. A essência do método é executar o comando PREPARE uma única vez, seguido do uso da expressão preparada na criação de uma série de consultas do mesmo tipo, mas, na prática, o ganho em comparação com a simples SELECT ficou na faixa do erro estatístico.
O processo de carregamento de dados consome no máximo 450 MB de RAM. Ou seja, a abordagem descrita permite manipular conjuntos de dados pesando dezenas de gigabytes praticamente em qualquer hardware de baixo custo, incluindo algumas placas únicas, o que é bastante impressionante.
Resta medir a velocidade de extração de dados (aleatórios) e avaliar a escalabilidade ao selecionar lotes de diferentes tamanhos:
Benchmark do banco de dados
library(ggplot2)

set.seed(0)
# Conexão ao banco de dados
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Função para preparar a consulta no lado do servidor
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Função para extrair dados
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Realização da medição
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Parâmetros do benchmark
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("tempo médio, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 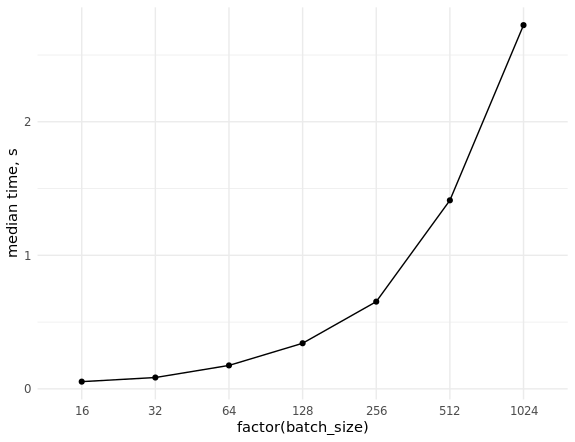
2. Preparação dos batches
Todo o processo de preparação dos batches consiste nas seguintes etapas:
- Análise de vários JSONs que contêm vetores de strings com coordenadas dos pontos.
- Desenho de linhas coloridas com base nas coordenadas dos pontos em uma imagem do tamanho desejado (por exemplo, 256×256 ou 128×128).
- Transformação das imagens obtidas em um tensor.
No âmbito da competição entre kernels em Python, a tarefa foi resolvida principalmente por meio de OpenCV. Uma das alternativas mais simples e evidentes em R seria a seguinte:
Implementação da transformação de JSON em tensor em R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Analisando JSON
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Remove o arquivo temporário ao final da função
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Gráfico vazio
  plot.new()
  # Tamanho da janela do gráfico
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Cores das linhas
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Convertendo a imagem em uma matriz 3D
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Unindo matrizes 3D de imagens em uma matriz 4D como um tensor
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
O desenho é realizado por meio de funções padrão do R, salvando em um PNG temporário, que é armazenado na RAM (em Linux, os diretórios temporários do R estão no diretório /tmp, montado na RAM). Em seguida, esse arquivo é lido como uma matriz tridimensional com números no intervalo de 0 a 1. Isso é importante, pois um BMP mais comum seria lido como uma matriz raw com códigos hexadecimais de cores.
Vamos testar o resultado:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 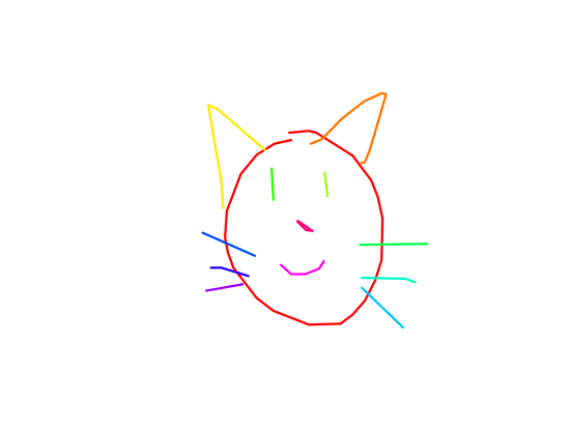
O lote será formado da seguinte maneira:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=Lista de 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Esta implementação nos pareceu subótima, pois a formação de grandes lotes leva um tempo excessivo, e decidimos aproveitar a experiência de colegas, utilizando uma poderosa biblioteca OpenCV. Naquele momento, não havia pacote disponível para R (e ainda não há), então uma implementação mínima do funcionalismo necessário foi escrita em C++ com integração ao código em R através de Rcpp.
Para resolver a tarefa, foram utilizados os seguintes pacotes e bibliotecas:
OpenCV para trabalhar com imagens e desenhar linhas. Utilizaram-se bibliotecas e cabeçalhos do sistema previamente instalados, além de linkage dinâmico.
xtensor para trabalhar com matrizes multidimensionais e tensores. Usamos os arquivos de cabeçalho incluídos no pacote R homônimo. A biblioteca permite a manipulação de matrizes multidimensionais, tanto na ordem row major quanto na ordem column major.
ndjson para parsing de JSON. Esta biblioteca é utilizada em xtensor automaticamente quando disponível no projeto.
RcppThread para organizar o processamento multithread de vetores a partir de JSONs. Utilizamos os arquivos de cabeçalho fornecidos por este pacote. Diferente de muitos mais populares, RcppParallel o pacote, entre outras coisas, se destaca por ter um mecanismo embutido de interrupção de loops (interrupt).
Vale ressaltar que xtensor se mostrou uma verdadeira descoberta: além de ter uma ampla funcionalidade e alto desempenho, seus desenvolvedores eram bastante receptivos e respondiam de forma rápida e detalhada às perguntas que surgiam. Com a ajuda deles, conseguimos implementar transformações de matrizes OpenCV em tensores xtensor, assim como uma maneira de combinar tensores 3D de imagens em um tensor 4D de dimensões adequadas (o batch em si).
Materiais para estudar Rcpp, xtensor e RcppThread
Para compilar arquivos que utilizam arquivos de sistema e linkagem dinâmica com bibliotecas instaladas no sistema, utilizamos o mecanismo de plugins implementado no pacote Rcpp. Para encontrar caminhos e flags automaticamente, usamos a popular ferramenta linux pkg-config.
Implementação do plugin Rcpp para usar a biblioteca OpenCV
Rcpp::registerPlugin("opencv", function() {
  # Possíveis nomes do pacote
  pkg_config_name <- c("opencv", "opencv4")
  # Arquivo binário da ferramenta pkg-config
  pkg_config_bin <- Sys.which("pkg-config")
  # Verificação da presença da ferramenta no sistema
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Verificação da presença do arquivo de configuração do OpenCV para pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("Configuração do OpenCV para o pkg-config não encontrada", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
Como resultado do funcionamento do plugin durante a compilação, os seguintes valores serão preenchidos:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
O código para realização da análise JSON e formação de um lote para transmissão ao modelo está sob o spoiler. Primeiramente, adicionamos o diretório local do projeto para procurar arquivos de cabeçalho (necessário para ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implementação da conversão de JSON em tensor em C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Este código deve ser colocado em um arquivo src/cv_xt.cpp e compilado com o comando Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); também será necessário nlohmann/json.hpp do . O código é dividido em várias funções:
to_xt— função template para converter uma matriz de imagem (cv::Mat) em tensorxt::xtensor;parse_json— função que analisa a string JSON, extrai coordenadas de pontos, empacotando-as em um vetor;ocv_draw_lines— a partir do vetor de pontos obtido, desenha linhas coloridas;processo— combina as funções mencionadas acima e também adiciona a capacidade de escalonar a imagem obtida;cpp_process_json_str— um wrapper em torno da funçãoprocesso, que exporta o resultado para um objeto R (array multidimensional);cpp_process_json_vector— um wrapper em torno da funçãocpp_process_json_str, que permite processar um vetor de strings em modo multithread.
Para desenhar linhas coloridas, foi usada a modelo de cor HSV com posterior conversão para RGB. Vamos testar o resultado:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 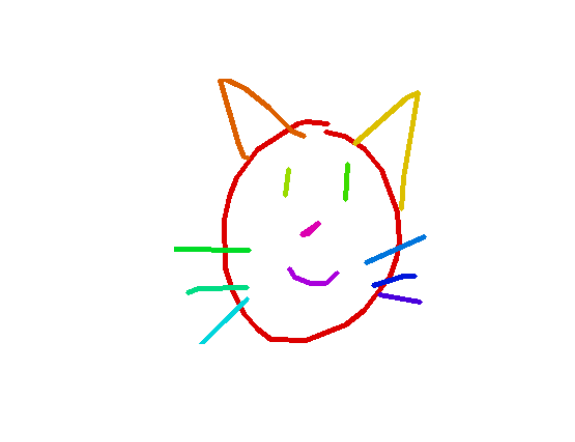
Comparação da velocidade de execução das implementações em R e C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Parâmetros do benchmark
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/sec` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Realizando a medição
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data, scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/sec` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>     <dbl>   <bch:tm> <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("tempo médio, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 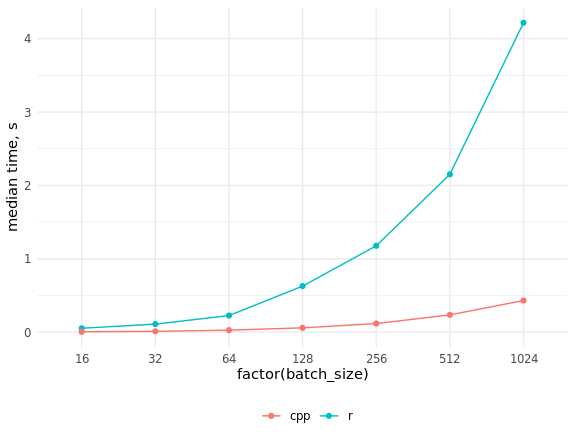
Como podemos ver, o ganho de velocidade foi muito significativo, e alcançar o código em C++ por meio da paralelização do código em R não parece ser possível.
3. Iteradores para descarregar lotes do banco de dados
R tem uma merecida reputação como uma linguagem para processamento de dados que cabem na RAM, enquanto o Python é mais caracterizado pelo processamento iterativo de dados, permitindo implementar facilmente cálculos fora do núcleo (cálculos que utilizam memória externa). Um exemplo clássico e relevante para nós no contexto da tarefa descrita são as redes neurais profundas, treinadas pelo método de descida do gradiente, aproximando o gradiente em cada etapa com um pequeno lote de observações, ou mini-batch.
Frameworks de aprendizado profundo escritos em Python possuem classes especiais que implementam iteradores sobre dados: tabelas, imagens em pastas, formatos binários e assim por diante. Podem ser utilizadas opções prontas ou podemos escrever as nossas próprias para tarefas específicas. No R, podemos aproveitar todas as possibilidades da biblioteca do Python keras com seus diversos backends através do pacote homônimo, que por sua vez funciona sobre o pacote reticulate. Este último merece um artigo considerável; ele não apenas permite executar código Python a partir do R, mas também garante a transferência de objetos entre sessões R e Python, realizando automaticamente todas as conversões de tipos necessárias.
Eliminamos a necessidade de armazenar todos os dados na RAM usando o MonetDBLite, todo o trabalho de "rede neural" será feito pelo código original em Python, e nos resta apenas escrever um iterador para os dados, uma vez que não existe uma versão pronta para essa situação nem no R nem no Python. As exigências para ele são basicamente duas: deve retornar lotes em um ciclo infinito e manter seu estado entre as iterações (a última, no R, é implementada de forma simples utilizando closures). Anteriormente, era necessário dentro do iterador transformar explicitamente arrays do R em arrays numpy, mas a versão atual do pacote keras faz isso automaticamente.
O iterador para os dados de treinamento e validação ficou assim:
Iterador para dados de treinamento e validação
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
A função recebe como entrada uma variável com a conexão ao banco de dados, os números das linhas usadas, o número de classes, o tamanho do lote, a escala (scale = 1 corresponde à renderização de imagens de 256x256 pixels, scale = 0.5 — 128x128 pixels), e um indicador de cores (color = FALSE define a renderização em tons de cinza, ao usar cor = TRUE cada traço é desenhado com uma nova cor) e um indicador de pré-processamento para redes pré-treinadas no imagenet. O último é necessário para escalonar os valores dos pixels do intervalo [0, 1] para o intervalo [-1, 1], que foi usado durante o treinamento fornecido junto com keras modelos.
A função externa contém uma verificação dos tipos de argumentos, uma tabela data.table com números de linhas aleatoriamente embaralhados de samples_index e números de batches, um contador e o número máximo de batches, bem como uma expressão SQL para extrair dados do banco de dados. Além disso, definimos um análogo rápido da função interna keras::to_categorical(). Usamos quase todos os dados para treinamento, deixando meio por cento para validação, portanto, o tamanho da época foi limitado pelo parâmetro steps_per_epoch na chamada keras::fit_generator(), e a condição if (i > max_i) só se ativou para o iterador de validação.
Na função interna ocorre a seleção de índices de linhas para o próximo batch, extração de registros do banco de dados com aumento do contador de batches, parsing de JSONs (função cpp_process_json_vector(), escrita em C++) e criação de arrays correspondentes às imagens. Em seguida, vetores one-hot com rótulos de classes, arrays com valores de pixels e rótulos são combinados em uma lista, que é o valor de retorno. Para acelerar o trabalho, foi utilizado a criação de índices nas tabelas data.table e modificação por referência — sem esses "truques" do pacote data.table é bastante difícil imaginar um trabalho eficiente com volumes significativos de dados em R.
Os resultados das medições de velocidade em um Core i5 de notebook são os seguintes:
Benchmark do iterador
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Índices para o conjunto de treinamento
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Índices para o conjunto de validação
val_ind <- ind[-train_ind]
rm(ind)
# Coeficiente de escala
scale <- 0.5

# Realizando a medição
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Parâmetros do benchmark
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("tempo mediano, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 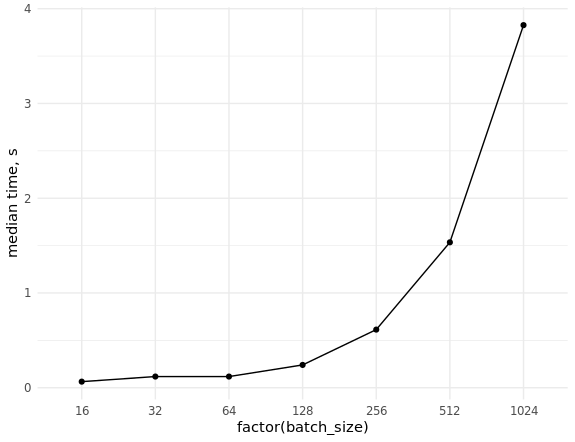
Se houver uma quantidade suficiente de RAM, é possível acelerar significativamente o banco de dados movendo-o para essa mesma RAM (para a nossa tarefa, 32 GB é suficiente). No Linux, por padrão, é montada uma partição /dev/shm, ocupando até metade do volume da RAM. É possível dedicar ainda mais, editando /etc/fstab, para que se obtenha uma entrada do tipo tmpfs /dev/shm tmpfs defaults,size=25g 0 0. É importante reiniciar e verificar o resultado, executando o comando df -h.
O iterador para os dados de teste parece muito mais simples, uma vez que o conjunto de dados de teste cabe completamente na RAM:
Iterador para dados de teste
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Escolha da arquitetura do modelo
A primeira das arquiteturas utilizadas foi , cujas características foram analisadas em uma mensagem. Ela está incluída na entrega padrão keras e, consequentemente, está disponível no pacote homônimo para R. Mas ao tentar usá-la com imagens de canal único, surgiu algo curioso: o tensor de entrada deve sempre ter a dimensão (batch, altura, largura, 3), ou seja, o número de canais não pode ser alterado. No Python, não há essa limitação, então aceleramos e escrevemos nossa própria implementação dessa arquitetura, seguindo o artigo original (sem dropout, que está na versão do keras):
Arquitetura mobilenet v1
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
As desvantagens dessa abordagem são óbvias. Queremos testar muitos modelos, mas não queremos reescrever cada arquitetura manualmente. Além disso, não temos a possibilidade de usar os pesos dos modelos pré-treinados no imagenet. Como de costume, o estudo da documentação ajudou. A função get_config() permite obter a descrição do modelo em um formato editável (base_model_conf$layers — uma lista normal de tipo R, e a função from_config() realiza a transformação inversa em um objeto modelo:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Agora não é difícil escrever uma função universal para obter qualquer um dos modelos fornecidos com pesos treinados no imagenet ou sem eles: keras Função para carregar arquiteturas prontas
get_model <- function(name = "mobilenet_v2", input_shape = NULL, weights = "imagenet", pooling = "avg", num_classes = NULL, optimizer = keras::optimizer_adam(lr = 0.002), loss = "categorical_crossentropy", metrics = NULL, color = TRUE, compile = FALSE) { # Verificação dos argumentos checkmate::assert_string(name) checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3) checkmate::assert_count(num_classes) checkmate::assert_flag(color) checkmate::assert_flag(compile)# Obtendo objeto do pacote keras model_fun <- get0(paste0("application_", name), envir = asNamespace("keras")) # Verificação da existência do objeto no pacote if (is.null(model_fun)) { stop("Modelo ", shQuote(name), " não encontrado.", call. = FALSE) }base_model <- model_fun( input_shape = input_shape, include_top = FALSE, weights = weights, pooling = pooling )# Se a imagem não for colorida, mudar a dimensionalidade da entrada if (!color) { base_model_conf <- keras::get_config(base_model) base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L base_model <- keras::from_config(base_model_conf) }predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax") model <- keras::keras_model( inputs = base_model$input, outputs = predictions )if (compile) { keras::compile( object = model, optimizer = optimizer, loss = loss, metrics = metrics ) }return(model) }
Ao usar imagens de canal único, os pesos pré-treinados não são utilizados. Isso poderia ser corrigido: com a ajuda da funçãoget_weights() para obter os pesos do modelo como uma lista de arrays do R, alterar a dimensionalidade do primeiro elemento dessa lista (pegando algum canal de cor ou média de todos os três), e depois carregar os pesos de volta no modelo com a função set_weights() . Nós não adicionamos essa funcionalidade, pois nesse ponto já estava claro que era mais produtivo trabalhar com imagens coloridas.. Nós não adicionamos essa funcionalidade, pois nesta etapa já estava claro que era mais produtivo trabalhar com imagens coloridas.
A maior parte dos experimentos foi realizada usando as versões 1 e 2 do mobilenet, assim como o resnet34. Neste concurso, arquiteturas mais modernas, como o SE-ResNeXt, se destacaram. Infelizmente, não tínhamos implementações prontas à nossa disposição e ainda não escrevemos as nossas próprias (mas vamos fazer isso sem falta).
5. Parametrização dos scripts
Para conveniência, todo o código para iniciar o treinamento foi organizado em um único script, parametrizado através de da seguinte forma:
doc <- '
Uso:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [options]

Opções:
  -h --help                   Mostra esta mensagem.
  -l --list-models            Lista os modelos disponíveis.
  -m --model=          Nome do modelo da rede neural [padrão: mobilenet_v2].
  -b --batch-size=      Tamanho do lote [padrão: 32].
  -s --scale-factor=   Fator de escala [padrão: 0.5].
  -c --color                  Usa linhas coloridas [padrão: FALSE].
  -d --db-dir=          Caminho para o diretório do banco de dados [padrão: Sys.getenv("db_dir")].
  -r --validate-ratio= Proporção da amostra de validação [padrão: 0.995].
  -n --n-gpu=         Número de GPUs [padrão: 1].
'
args <- docopt::docopt(doc)
Pacote docopt representa uma implementação para R. Com isso, os scripts são executados através de comandos simples como Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db ou ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, se o arquivo train_nn.R for executável (este comando iniciará o treinamento do modelo resnet50 em imagens coloridas de 128x128 pixels, e o banco de dados deve estar na pasta /home/andrey/doodle_db). É possível adicionar a taxa de aprendizado, o tipo de otimizador e quaisquer outros parâmetros configuráveis. Durante a preparação da publicação, descobrimos que a arquitetura mobilenet_v2 da versão atual keras não pode ser utilizada devido a alterações não consideradas no pacote R – aguardamos que isso seja corrigido.
Essa abordagem permitiu acelerar significativamente os experimentos com diferentes modelos em comparação com o lançamento mais tradicional de scripts no RStudio (como uma possível alternativa, mencionamos o pacote ). Mas a principal vantagem é a capacidade de gerenciar facilmente a execução dos scripts no Docker ou simplesmente em um servidor, sem precisar instalar o RStudio para isso.
6. Dockerização dos scripts
Usamos o Docker com o objetivo de garantir a portabilidade do ambiente para o treinamento de modelos entre os membros da equipe e para a implantação rápida na nuvem. Para começar a familiarização com essa ferramenta relativamente incomum para programadores R, podemos consultar uma série de publicações ou um .
O Docker permite tanto criar suas próprias imagens 'do zero', quanto usar outras imagens como base para a criação das suas. Ao analisar as opções disponíveis, concluímos que a instalação de drivers NVIDIA, CUDA+cuDNN e bibliotecas Python é uma parte bastante extensa da imagem, e decidimos usar a imagem oficial como base. tensorflow/tensorflow:1.12.0-gpu, adicionando os pacotes R necessários.
O arquivo Docker resultante ficou assim:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
Para conveniência, os pacotes utilizados foram colocados em variáveis; a maior parte dos scripts escritos é copiada para dentro dos containers durante a construção. Também mudamos o shell para /bin/bash para facilitar o uso do conteúdo /etc/os-release. Isso evitou a necessidade de especificar a versão do sistema operacional no código.
Além disso, foi escrito um pequeno script bash que permite iniciar o container com diferentes comandos. Por exemplo, esses podem ser scripts para treinar redes neurais, previamente colocados dentro do container, ou um shell para depuração e monitoramento do funcionamento do container:
Script para iniciar o container
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Se este script bash for executado sem parâmetros, um script será chamado dentro do contêiner com valores padrão; se o primeiro argumento posicional for 'bash', o contêiner será iniciado em modo interativo com o shell de comando. Em todos os outros casos, ocorre a substituição dos valores dos argumentos posicionais: train_nn.R CMD="Rscript /app/train_nn.R $@" Vale ressaltar que os diretórios com os dados de entrada e o banco de dados, assim como o diretório para salvar os modelos treinados, são montados dentro do contêiner a partir do sistema host, o que permite acessar os resultados dos scripts sem manobras adicionais..
7. Uso de múltiplas GPUs no Google Cloud
Uma das características da competição foram os dados bastante ruidosos (veja a imagem em destaque, emprestada de @Leigh.plt do Slack ODS). Para lidar com isso, batches grandes ajudam, e após experimentos em um PC com 1 GPU, decidimos explorar o treinamento de modelos em várias GPUs na nuvem. Utilizamos Google Cloud (
um bom guia sobre os fundamentos do funcionamentodev/shm O maior interesse reside no trecho de código que se encarrega do uso de várias GPUs. Primeiro, o modelo é criado na CPU usando um gerenciador de contexto, exatamente como no Python:.
with(tensorflow::tf$device("/cpu:0"), { model_cpu <- get_model( name = model_name, input_shape = input_shape, weights = weights, metrics =(top_3_categorical_accuracy, compile = FALSE ) })
Em seguida, o modelo não compilado (isso é importante) é copiado para o número definido de GPUs disponíveis, e só depois disso é que é compilado:model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu) keras::compile( object = model, optimizer = keras::optimizer_adam(lr = 0.0004), loss = "categorical_crossentropy", metrics = c(top_3_categorical_accuracy) )
A técnica clássica de congelar todas as camadas, exceto a última, treinar a última camada, descongelar e re-treinar o modelo como um todo para várias GPUs não pôde ser implementada.Acompanhamos o treinamento sem usar
tensorboard tensorboard, limitando-se ao registro de logs e salvando modelos com nomes informativos após cada época:
Callbacks
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. Em vez de conclusão
Várias questões que enfrentamos ainda não conseguimos resolver:
- em keras não há uma função pronta para buscar automaticamente a taxa de aprendizado ideal (analógica ao
lr_finderna biblioteca fast.ai); com algum esforço, é possível portar implementações de terceiros para R, como ; - consequentemente ao ponto anterior, não conseguimos encontrar a taxa de aprendizado correta ao usar várias GPUs;
- falta arquiteturas modernas de redes neurais, especialmente aquelas pré-treinadas no imagenet;
- não há política de one cycle e taxas de aprendizado discriminativas (cosine annealing foi solicitado por nós, , obrigado ).
O que conseguimos extrair de útil dessa competição:
- Em hardware relativamente fraco, pode-se trabalhar sem dor com volumes de dados consideravelmente maiores que o tamanho da RAM. O pacote data.table economiza memória através da modificação in-place de tabelas, evitando assim sua cópia, e quando usado corretamente, quase sempre demonstra a maior velocidade entre todas as ferramentas conhecidas para linguagens de script. Salvar dados em um banco de dados permite, em muitos casos, não precisar se preocupar em inserir todo o conjunto de dados na RAM.
- Funções lentas em R podem ser substituídas por rápidas em C++ usando o pacote Rcpp. Se além disso utilizarmos RcppThread ou RcppParallel, obtemos implementações multiplataforma e multithread, portanto, o código em nível R não precisa ser paralelizado.
- O pacote Rcpp pode ser utilizado sem conhecimentos profundos de C++, o mínimo necessário está exposto . Arquivos de cabeçalho para várias bibliotecas C++ de alto nível como xtensor estão disponíveis no CRAN, assim forma-se uma infraestrutura para a realização de projetos que integram código de alto desempenho em C++ ao R. Um conforto adicional é a realce de sintaxe e um analisador estático de código em C++ no RStudio.
- docopt permite executar scripts autossuficientes com parâmetros. Isso é conveniente para uso em servidor remoto, inclusive sob Docker. Realizar experimentos de horas com treinamento de redes neurais em RStudio não é prático, e instalar a IDE no servidor nem sempre é justificável.
- O Docker garante a portabilidade do código e a reprodutibilidade dos resultados entre desenvolvedores com diferentes versões de sistemas operacionais e bibliotecas, além da facilidade de execução em servidores. É possível iniciar todo o pipeline para treinamento com apenas um comando.
- O Google Cloud é uma forma econômica de experimentar em hardware caro, mas é necessário escolher as configurações com cuidado.
- Medir a velocidade de execução de trechos específicos de código é muito útil, especialmente ao combinar R e C++, e com o pacote bench — é ainda muito fácil.
No geral, essa experiência foi muito útil e continuamos trabalhando para resolver algumas das questões levantadas.
Fonte: habr.com
