

Introdução
Neste artigo, vou falar sobre o conhecido algoritmo de Huffman e sua aplicação na compressão de dados.
Como resultado, escreveremos um simples compactador. Já houve uma , mas sem uma implementação prática. O material teórico do post atual é baseado nas aulas de informática da escola e no livro de Robert Lafore "Data Structures and Algorithms in Java". Então, tudo sob a categoria!
Um pouco de reflexão
Em um arquivo de texto comum, um símbolo é codificado em 8 bits (codificação ASCII) ou 16 (codificação Unicode). Vamos considerar a codificação ASCII. Para exemplo, pegamos a string s1 = "SUSIE SAYS IT IS EASYn". No total, a string tem 22 símbolos, naturalmente, incluindo espaços e o símbolo de nova linha - 'n'. O arquivo contendo essa string terá 22*8 = 176 bits. A questão que surge imediatamente é: é racional usar todos os 8 bits para codificar 1 símbolo? Afinal, não usamos todos os símbolos da codificação ASCII. Mesmo que usássemos, seria mais racional dar ao símbolo mais comum - S - o código mais curto possível, e para a letra mais rara - T (ou U, ou 'n') - um código mais longo. Isso é o que o algoritmo de Huffman propõe: encontrar a codificação otimizada, na qual o arquivo terá o menor tamanho. É bastante normal que diferentes símbolos tenham comprimentos de código diferentes - é isso que fundamenta o algoritmo.
Codificação
Por que não dar ao símbolo 'S' um código, por exemplo, com comprimento de 1 bit: 0 ou 1. Vamos supor que seja 1. Então, para o segundo símbolo mais frequente - ' ' (espaço) - daríamos 0. Imagine que você começa a decodificar sua mensagem - a string codificada s1 - e vê que o código começa com 1. Então, o que fazer: é o símbolo S ou é algum outro símbolo, como A? Portanto, surge uma regra importante:
Nenhum código deve ser um prefixo de outro
Essa regra é fundamental no algoritmo. Portanto, a criação do código começa com uma tabela de frequências, que indica a frequência (número de ocorrências) de cada símbolo:
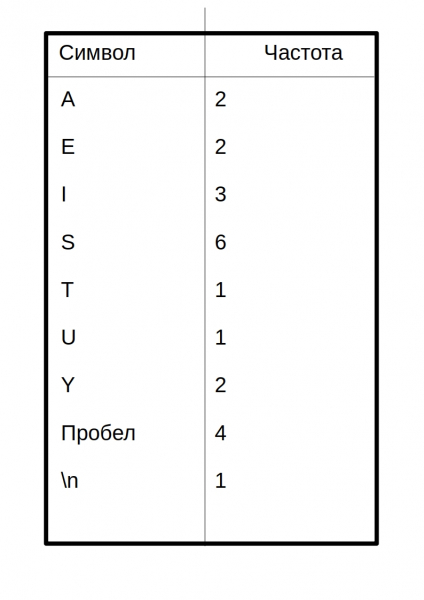 Os símbolos com o maior número de ocorrências devem ser codificados com o menor número possível de bits. Vou mostrar um exemplo de uma das possíveis tabelas de códigos:
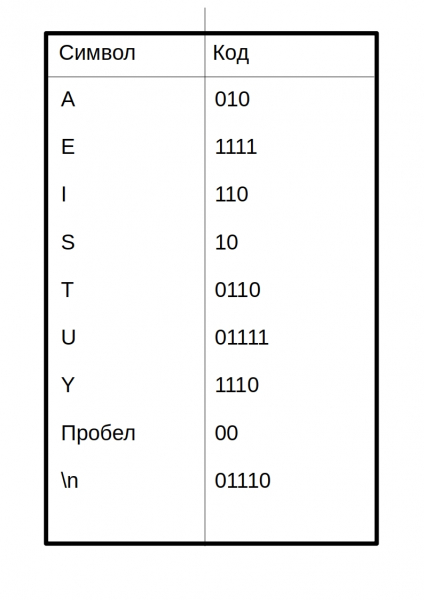 Assim, a mensagem codificada ficará assim:
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 Eu separei o código de cada símbolo por um espaço. Na verdade, em um arquivo compactado, isso não será assim!
Surge a pergunta: como esse novato criou o código para gerar uma tabela de códigos? É sobre isso que falaremos a seguir.
Construção da árvore de Huffman
Aqui entram em cena as árvores binárias de busca. Não se preocupe, não precisaremos dos métodos de busca, inserção e exclusão. Aqui está a estrutura da árvore em Java:
public class Node {
    private int frequencia;
    private char letra;
    private Node filhoEsquerdo;
    private Node filhoDireito;
    ...
}
class BinaryTree {
    private Node raiz;

    public BinaryTree() {
        raiz = new Node();
    }
    public BinaryTree(Node raiz) {
        this.raiz = raiz;
    }
    ...
}
Este não é o código completo, o código completo estará abaixo.
Aqui está o próprio algoritmo de construção da árvore:
- Criar um objeto Node para cada símbolo da mensagem (string s1). No nosso caso, teremos 9 nós (objetos Node). Cada nó consiste em dois campos de dados: símbolo e frequência.
- Criar um objeto Árvore (BinaryTree) para cada um dos nós Node. O nó se torna a raiz da árvore.
- Inserir essas árvores em uma fila de prioridade. Quanto menor a frequência, maior a prioridade. Assim, ao extrair, sempre escolhe-se a árvore de menor frequência.
Em seguida, precisamos fazer o seguinte de forma cíclica:
- Extrair duas árvores da fila de prioridade e fazer delas os filhos de um novo nó (um nó recém-criado sem letra). A frequência do novo nó é igual à soma das frequências das duas árvores-filhas.
- Para esse nó, criar uma árvore com a raiz neste nó. Inserir essa árvore de volta na fila de prioridade. (Como a árvore tem uma nova frequência, provavelmente ela ocupará uma nova posição na fila.)
- Continuar executando os passos 1 e 2 até que reste apenas uma árvore na fila — a árvore de Huffman.
Vamos analisar esse algoritmo na string s1:
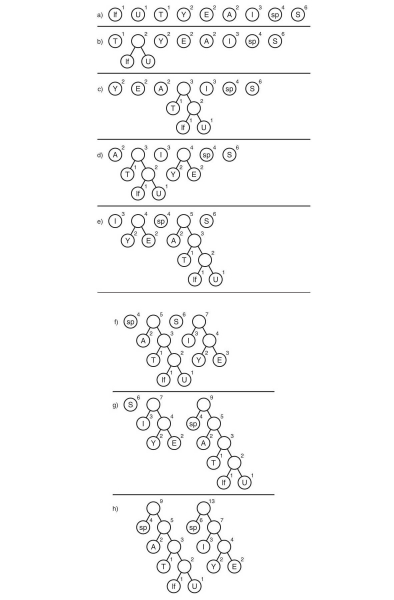
Aqui, o símbolo "lf" (linefeed) representa a mudança para uma nova linha, "sp" (space) — é um espaço.
E depois?
Obtivemos a árvore de Huffman. Ok. E o que fazer com isso? Nem de graça vão querer. A seguir, precisamos rastrear todos os possíveis caminhos da raiz até as folhas da árvore. Vamos concordar em designar uma aresta como 0 se ela levar ao filho esquerdo e 1 — se for ao direito. Estritamente falando, nessas designações, o código do símbolo é o caminho da raiz da árvore até a folha que contém esse símbolo.
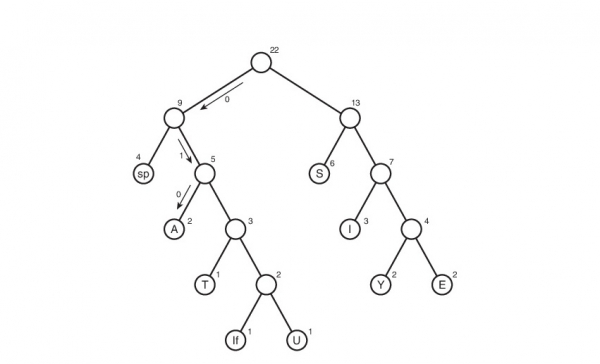
Dessa forma, obtemos a tabela de códigos. Observe que, se analisarmos essa tabela, podemos concluir sobre o "peso" de cada símbolo — que é o comprimento do seu código. Sendo assim, o arquivo original em formato compactado pesará: 2 * 3 + 2 * 4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 bits. No início, ele pesava 176 bits. Portanto, reduzimos seu tamanho em 176/65 = 2,7 vezes! Mas isso é uma utopia. Tal coeficiente dificilmente será alcançado. Por quê? Vamos abordar isso um pouco mais adiante.
Decodificação
Bem, parece que só resta o mais simples — a decodificação. Acho que muitos de vocês já perceberam que não é possível criar um arquivo compactado sem quaisquer indícios de como ele foi codificado — não conseguiremos decodificá-lo! Sim, eu tive dificuldade em aceitar isso, mas teremos que criar um arquivo de texto table.txt com a tabela de compressão:
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
Gravando a tabela no formato 'símbolo'"código do símbolo". Por que 01110 sem símbolo? Na verdade, ele tem um símbolo, apenas as ferramentas Java que utilizei ao gravar no arquivo convertem o caractere de nova linha — 'n' — em uma quebra de linha (por mais estranho que isso possa parecer). Portanto, a linha em branco acima representa o símbolo para o código 01110. Para o código 00, o símbolo é um espaço no início da linha. Deixe-me já dizer que essa forma de armazenar a tabela pode ser a mais irracional para nosso coeficiente. Mas ela é simples de entender e implementar. Ficarei feliz em ouvir suas recomendações nos comentários sobre otimização.
Com essa tabela, decodificar é muito simples. Lembremos da regra que seguimos ao criar a codificação:
Nenhum código deve ser um prefixo de outro
É aqui que ela desempenha um papel facilitador. Lemos bit a bit de forma sequencial e, assim que a string d resultante, composta pelos bits lidos, corresponder à codificação correspondente ao símbolo character, sabemos imediatamente que o símbolo character foi codificado (e somente ele!). Em seguida, gravamos character na string de decodificação (a string que contém a mensagem decodificada), redefinimos a string d e continuamos a ler o arquivo codificado.
Implementação
Chegou a hora de humilhar meu código e escrever um compactador. Vamos chamá-lo de Compressor.
Começaremos do começo. Primeira coisa que faremos é escrever a classe Node:
classe pública Node {
    private int frequence; // frequência
    private char letter; // letra
    private Node leftChild; // filho esquerdo
    private Node rightChild; // filho direito

    public Node(char letter, int frequence) { // construtor
        this.letter = letter;
        this.frequence = frequence;
    }

    public Node() {} // sobrecarga do construtor para nós anônimos (ver acima na seção sobre a construção da árvore de Huffman)
    public void addChild(Node newNode) { // adicionar filho
        if (leftChild == null) // se o esquerdo estiver vazio => o direito também estará => adiciona ao esquerdo
            leftChild = newNode;
        else {
            if (leftChild.getFrequence() <= newNode.getFrequence()) // no geral, filho esquerdo
                rightChild = newNode; // se tornará aquele com menor frequência
            else {
                rightChild = leftChild;
                leftChild = newNode;
            }
        }

        frequence += newNode.getFrequence(); // frequência total
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public int getFrequence() {
        return frequence;
    }

    public char getLetter() {
        return letter;
    }

    public boolean isLeaf() { // verificação de folha
        return leftChild == null && rightChild == null;
    }
}
Agora a árvore:
classe BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }

    public BinaryTree(Node root) {
        this.root = root;
    }

    public int getFrequence() {
        return root.getFrequence();
    }

    public Node getRoot() {
        return root;
    }
}
Fila de prioridade:
import java.util.ArrayList; // sim, a fila será baseada em uma lista

classe PriorityQueue {
    private ArrayList data; // lista da fila
    private int nElems; // número de elementos na fila

    public PriorityQueue() {
        data = new ArrayList();
        nElems = 0;
    }

    public void insert(BinaryTree newTree) { // inserção
        if (nElems == 0)
            data.add(newTree);
        else {
            for (int i = 0; i  newTree.getFrequence()) { // se a frequência da árvore inserida for menor
                    data.add(i, newTree); // do que a atual, deslocamos todas as árvores à direita para uma posição
                    break; // então colocamos a nova árvore na posição da atual
                }
                if (i == nElems - 1)
                    data.add(newTree);
            }
        }
        nElems++; // aumentamos o número de elementos em 1
    }

    public BinaryTree remove() { // remoção da fila
        BinaryTree tmp = data.get(0); // copiamos o elemento removido
        data.remove(0); // de fato, removemos
        nElems--; // diminuímos o número de elementos em 1
        return tmp; // retornamos o elemento removido (o elemento com menor frequência)
    }
}
Classe que cria a árvore de Huffman:
public class HuffmanTree {
    private final byte ENCODING_TABLE_SIZE = 127; // tamanho da tabela de codificação
    private String myString; // mensagem
    private BinaryTree huffmanTree; // árvore de Huffman
    private int[] freqArray; // tabela de frequência
    private String[] encodingArray; // tabela de codificação

    //----------------constructor----------------------
    public HuffmanTree(String newString) {
        myString = newString;

        freqArray = new int[ENCODING_TABLE_SIZE];
        fillFrequenceArray();

        huffmanTree = getHuffmanTree();

        encodingArray = new String[ENCODING_TABLE_SIZE];
        fillEncodingArray(huffmanTree.getRoot(), "", "");
    }

    //--------------------frequence array------------------------
    private void fillFrequenceArray() {
        for (int i = 0; i < myString.length(); i++) {
            freqArray[(int)myString.charAt(i)]++;
        }
    }

    public int[] getFrequenceArray() {
        return freqArray;
    }

    //------------------------huffman tree creation------------------
    private BinaryTree getHuffmanTree() {
        PriorityQueue pq = new PriorityQueue();
        // algoritmo descrito acima
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) { // se o símbolo existe na string
                Node newNode = new Node((char) i, freqArray[i]); // então criar um Node para ele
                BinaryTree newTree = new BinaryTree(newNode); // e criar BinaryTree para o Node
                pq.insert(newTree); // inserir na fila
            }
        }

        while (true) {
            BinaryTree tree1 = pq.remove(); // extrair da fila a primeira árvore.

            try {
                BinaryTree tree2 = pq.remove(); // extrair da fila a segunda árvore

                Node newNode = new Node(); // criar um novo Node
                newNode.addChild(tree1.getRoot()); // fazer dele filhos das duas árvores extraídas
                newNode.addChild(tree2.getRoot());

                pq.insert(new BinaryTree(newNode);
            } catch (IndexOutOfBoundsException e) { // resta uma árvore na fila
                return tree1;
            }
        }
    }

    public BinaryTree getTree() {
        return huffmanTree;
    }

    //-------------------encoding array------------------
    void fillEncodingArray(Node node, String codeBefore, String direction) { // preencher a tabela de codificação
        if (node.isLeaf()) {
            encodingArray[(int)node.getLetter()] = codeBefore + direction;
        } else {
            fillEncodingArray(node.getLeftChild(), codeBefore + direction, "0");
            fillEncodingArray(node.getRightChild(), codeBefore + direction, "1");
        }
    }

    String[] getEncodingArray() {
        return encodingArray;
    }

    public void displayEncodingArray() { // para depuração
        fillEncodingArray(huffmanTree.getRoot(), "", "");

        System.out.println("======================Tabela de codificação====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            }
        }
        System.out.println("========================================================");
    }
    //-----------------------------------------------------
    String getOriginalString() {
        return myString;
    }
}
Classe que contém a codificação/decodificação:
public class HuffmanOperator {
    private final byte ENCODING_TABLE_SIZE = 127; //tamanho da tabela
    private HuffmanTree mainHuffmanTree; //árvore de Huffman (usada apenas para compressão)
    private String myString; //mensagem original
    private int[] freqArray; //tabela de frequência
    private String[] encodingArray; //tabela de codificação
    private double ratio; //coeficiente de compressão


    public HuffmanOperator(HuffmanTree MainHuffmanTree) { //para compressão
        this.mainHuffmanTree = MainHuffmanTree;

        myString = mainHuffmanTree.getOriginalString();

        encodingArray = mainHuffmanTree.getEncodingArray();

        freqArray = mainHuffmanTree.getFrequenceArray();
    }

    public HuffmanOperator() {} //para extração;

    //---------------------------------------compressão-----------------------------------------------------------
    private String getCompressedString() {
        String compressed = "";
        String intermidiate = ""; //string intermediária (sem zeros adicionais)
        //System.out.println("=============================Compressão=======================");
        //displayEncodingArray();
        for (int i = 0; i
        //precisamos adicionar zeros ao final (podem ser 1, não faz diferença)
        byte counter = 0; //número de zeros adicionados ao final (1 byte é suficiente: 0 <= counter < 8 < 127)
        for (int length = intermidiate.length(), delta = 8 - length % 8;
                counter < delta ; counter++) { //delta - quantidade de zeros adicionados
            intermidiate += "0";
        }

        //concatenar a quantidade de zeros adicionais na representação binária e a string intermediária
        compressed = String.format("%8s", Integer.toBinaryString(counter & 0xff)).replace(" ", "0") + intermidiate;

        //coeficiente idealizado
        setCompressionRatio();
        //System.out.println("===============================================================");
        return compressed;
    }

    private void setCompressionRatio() { //calcular coeficiente idealizado
        double sumA = 0, sumB = 0; //A - a soma original
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                sumA += 8 * freqArray[i];
                sumB += encodingArray[i].length() * freqArray[i];
            }
        }
        ratio = sumA / sumB;
    }

    public byte[] getBytedMsg() { //compressão final
        StringBuilder compressedString = new StringBuilder(getCompressedString());
        byte[] compressedBytes = new byte[compressedString.length() / 8];
        for (int i = 0; i < compressedBytes.length; i++) {
                compressedBytes[i] = (byte) Integer.parseInt(compressedString.substring(i * 8, (i + 1) * 8), 2);
        }
        return compressedBytes;
    }
    //---------------------------------------fim da compressão----------------------------------------------------------------
    //------------------------------------------------------------extração-----------------------------------------------------
    public String extract(String compressed, String[] newEncodingArray) {
        String decompressed = "";
        String current = "";
        String delta = "";
        encodingArray = newEncodingArray;

        //displayEncodingArray();
        //obter a quantidade de zeros inseridos
        for (int i = 0; i < 8; i++)
            delta += compressed.charAt(i);
        int ADDED_ZEROES = Integer.parseInt(delta, 2);

        for (int i = 8, l = compressed.length() - ADDED_ZEROES; i < l; i++) {
            //i = 8, pois o primeiro byte contém a quantidade de zeros inseridos
            current += compressed.charAt(i);
            for (int j = 0; j < ENCODING_TABLE_SIZE; j++) {
                if (current.equals(encodingArray[j])) { //se coincidir
                    decompressed += (char)j; //então adicionamos o elemento
                    current = ""; //e resetamos a string atual
                }
            }
        }

        return decompressed;
    }

    public String getEncodingTable() {
        String enc = "";
        for (int i = 0; i < encodingArray.length; i++) {
            if (freqArray[i] != 0)
                enc += (char)i + encodingArray[i] + 'n';
        }
        return enc;
    }

    public double getCompressionRatio() {
        return ratio;
    }


    public void displayEncodingArray() { //para depuração
        System.out.println("======================Tabela de codificação====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            //if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            //}
        }
        System.out.println("========================================================");
    }
}
Classe que facilita a gravação em arquivo:
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
    	try (PrintWriter pw = new PrintWriter(outputFile)) {
    		pw.write(msg);
    	} catch (FileNotFoundException e) {
    		System.out.println("Caminho inválido ou o arquivo não existe!");
    	}
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
Classe que facilita a leitura de arquivo:
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
	private FileInputStream fileInputStream;
	private BufferedReader fileBufferedReader;

	public FileInputHelper(File file) throws IOException {
		fileInputStream = new FileInputStream(file);
		fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
	}


    public byte readByte() throws IOException {
    	int cur = fileInputStream.read();
    	if (cur == -1) //se o arquivo terminou
    		throw new EOFException();
    	return (byte)cur;
    }

    public String readLine() throws IOException {
    	return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException{
    	fileInputStream.close();
    }
}
E, a classe principal:
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try { // indicando a instrução com argumentos de linha de comando
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            		&& (args[2].equals("--table") || args[2].equals("-t"))) {
            	extract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Formato de entrada de argumentos incorreto ");
            System.out.println("Leia Readme.txt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Caminho inválido ou arquivo inexistente!");
            return;
        } catch (MalformedInputException e) {
        	System.out.println("A codificação atual do arquivo não é suportada");
        	return;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        	fo.writeBytes(operator.getBytedMsg());
        }
        // criar arquivo com tabela de codificação:

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        	fo.writeString(operator.getEncodingTable());
        }

        System.out.println("Caminho do arquivo comprimido: " + compressedFile.getAbsolutePath());
        System.out.println("Caminho da tabela de codificação " + table.getAbsolutePath());
        System.out.println("Sem a tabela, o arquivo não poderá ser extraído!");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) / (double) 100; // coeficiente idealizado
        double realRatio = Math.round((double) inputFile.length()
        		/ ((double) compressedFile.length() + (double) table.length()) * 100) / (double)100; // coeficiente real

        System.out.println("O coeficiente idealizado de compressão é " + idealRatio);
        System.out.println("O coeficiente de compressão considerando a tabela de codificação " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        	 tableFile = new File(tablePath),
        	 extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        // ler arquivo comprimido
        // !!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!! verifique aqui:
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        	byte b;
        	while (true) {
        		b = fi.readByte(); // método retorna EOFException
        		compressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        	}
        } catch (EOFException e) {

        }

        // --------------------

        // ler tabela de codificação:
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        	fi.readLine(); // pular a primeira linha vazia
        	encodingArray[(byte)'n'] = fi.readLine(); // ler código para 'n'
        	while (true) {
        		String s = fi.readLine();
        		if (s == null)
        			throw new EOFException();
        		encodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());
        	}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        // extrair:
		try (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
			fo.writeString(operator.extract(compressed, encodingArray));
		}

		System.out.println("Caminho do arquivo extraído " + extractedFile.getAbsolutePath());
    }
}
Você terá que escrever o arquivo de instruções readme.txt você mesmo 🙂
Conclusão
Acho que isso é tudo o que eu queria dizer. Se você tiver algo a dizer sobre minha incompetência em melhorias no código, algoritmo ou qualquer otimização, fique à vontade para escrever. Se eu não expliquei algo suficientemente, também escreva. Ficarei feliz em ouvir você nos comentários!
P.S.
Sim, eu ainda estou aqui, pois não me esqueci do coeficiente. Para a string s1, a tabela de codificação pesa 48 bytes — muito mais do que o arquivo original, e não se esqueceu dos zeros adicionais (o número de zeros adicionados é 7) => o coeficiente de compressão será menor que um: 176/(65 + 48*8 + 7)=0.38. Se você também percebeu isso, então só não olhe para o rosto, você é bom nisso. Sim, essa implementação será extremamente ineficiente para arquivos pequenos. Mas o que acontece com arquivos grandes? O tamanho do arquivo excede em muito o tamanho da tabela de codificação. É aqui que o algoritmo funciona como deveria! Por exemplo, para o compressor fornece um coeficiente real (não idealizado) igual a 1.46 — quase uma vez e meia! E sim, supondo que o arquivo esteja em inglês.
Fonte: habr.com
