

O que pode levar uma grande empresa como a Lamoda, com um processo afinado e dezenas de serviços interconectados, a mudar substancialmente sua abordagem? A motivação pode ser bastante variada: desde razões legislativas até o desejo inerente de todos os programadores de experimentar.
Mas isso não significa que não se pode esperar um benefício adicional. O que exatamente pode ser ganho ao implementar uma API orientada a eventos no Kafka, será explicado por Sergey Zaika (). Sobre os percalços e descobertas interessantes também haverá com certeza — não pode haver experimento sem eles.
Aviso Legal: Este artigo é baseado em materiais da reunião que Sergey conduziu em novembro de 2018 no HighLoad++. A experiência prática da Lamoda com Kafka atraiu ouvintes tanto quanto outras palestras da programação. Parece-nos um excelente exemplo de que sempre é possível e necessário encontrar pessoas com interesses semelhantes, e os organizadores do HighLoad++ continuarão se esforçando para criar uma atmosfera propícia a isso.
Sobre o processo
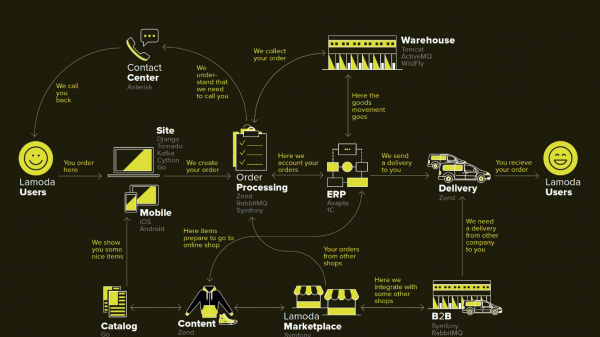
Lamoda é uma grande plataforma de e-commerce, que possui seu próprio call center, serviço de entrega (e muitas parcerias), estúdio fotográfico, um enorme armazém e tudo isso funciona com seu próprio software. Existem dezenas de formas de pagamento, parceiros B2B que podem acessar parte ou todos esses serviços e querem saber informações atualizadas sobre seus produtos. Além disso, a Lamoda opera em três países além da Rússia e lá tudo é um pouco diferente. No total, provavelmente existem mais de cem maneiras de configurar um novo pedido que deve ser processado de maneira específica. Tudo isso funciona com a ajuda de dezenas de serviços que se comunicam de maneiras às vezes não tão evidentes. Existe também um sistema central, cuja principal responsabilidade são os status dos pedidos. Chamamos isso de BOB, e eu trabalho com ele.
Ferramenta de Reembolso com API orientada a eventos
A expressão orientada a eventos está bastante desgastada, mas mais adiante vamos definir claramente o que isso significa. Começarei com o contexto em que decidimos experimentar a abordagem da API orientada a eventos no Kafka.
Em qualquer loja, além dos pedidos pelos quais os clientes pagam, existem momentos em que a loja precisa devolver o dinheiro, porque o produto não atendeu ao cliente. Esse processo relativamente curto: verificamos informações, se necessário, e transferimos o dinheiro.
Contudo, o processo de devolução tornou-se mais complicado devido a mudanças na legislação, e tivemos que implementar um microserviço separado para isso.
Nossa motivação:
- Lei FZ-54 — em resumo, a lei exige que se informe à Receita sobre cada transação monetária, seja devolução ou recebimento, em um SLA bastante curto de alguns minutos. Nós, como e-commerce, realizamos um número considerável de operações. Tecnologicamente, isso significa uma nova responsabilidade (e, portanto, um novo serviço) e ajustes em todos os sistemas envolvidos.
- BOB split — é um projeto interno da empresa para livrar o BOB de um grande número de responsabilidades não essenciais e reduzir sua complexidade geral.
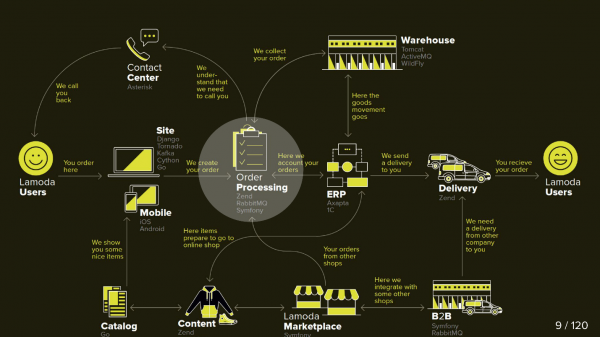
Neste diagrama estão desenhados os principais sistemas da Lamoda. Atualmente, a maioria deles é mais como um conjunto de 5-10 microserviços em torno de um monolito em diminuição.Eles estão crescendo lentamente, mas tentamos torná-los menores, pois fazer o deploy de um fragmento isolado no meio é assustador — não podemos permitir que ele falhe. Todas as trocas (as setas) precisamos garantir e considerar que qualquer uma delas pode ficar indisponível.
O BOB também possui muitas trocas: sistemas de pagamento, entrega, notificações etc.
Tecnicamente, o BOB é:
- ~150k linhas de código + ~100k linhas de testes;
- php7.2 + Zend 1 & Symfony Components 3;
- >100 APIs & ~50 integrações externas;
- 4 países com suas próprias lógicas de negócio.
Fazer o deploy do BOB é caro e doloroso, a quantidade de código e as tarefas que ele resolve são tantas que ninguém consegue ter tudo isso em mente ao mesmo tempo. Em suma, há muitas razões para simplificá-lo.
Processo de devolução
Inicialmente, o processo envolve dois sistemas: BOB e Payment. Agora, surgem mais dois:
- Fiscalization Service, que lidará com as questões de fiscalização e comunicação com serviços externos.
- Refund Tool, que simplesmente extrai novas trocas para não inflar o BOB.
Agora o processo é assim:
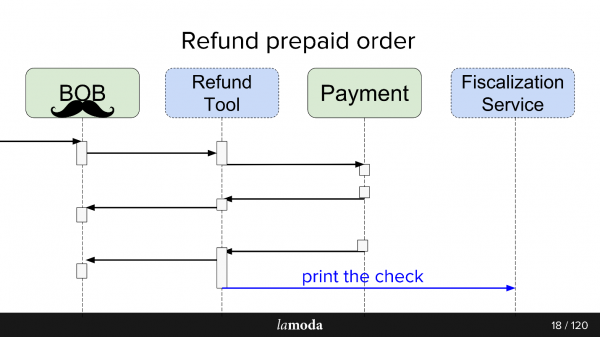
- O BOB recebe uma solicitação de devolução de dinheiro.
- O BOB comunica isso ao Refund Tool.
- Refund Tool diz ao Payment: 'Devolva o dinheiro'.
- Payment devolve o dinheiro.
- Refund Tool e BOB sincronizam os status entre si, pois ambos ainda precisam disso. Ainda não estamos prontos para mudar completamente para o Refund Tool, uma vez que o BOB possui UI, relatórios para contabilidade e muitas informações que não podem ser transferidas tão facilmente. Precisamos nos manter em duas plataformas.
- A solicitação para fiscalização é enviada.
No final, criamos um barramento de eventos baseado no Kafka, onde tudo se conecta. Uhul, agora temos um único ponto de falha (sarcasmo).
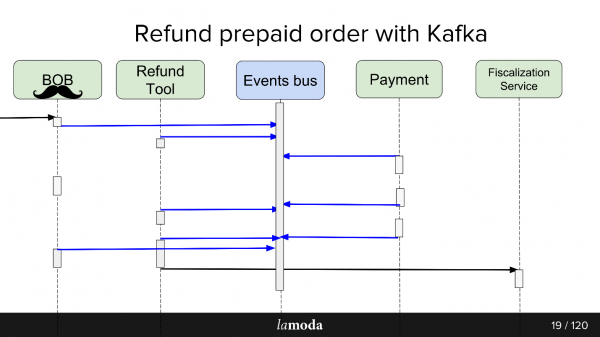
As vantagens e desvantagens são bem evidentes. Criamos um barramento, então agora todos os serviços dependem dele. Isso simplifica o design, mas traz um ponto único de falha para o sistema. Se o Kafka falhar, o processo para.
O que é API orientada a eventos
Uma boa resposta para essa pergunta está na palestra de Martin Fowler (GOTO 2017) .
Resumidamente, o que fizemos:
- Encapsulamos todas as trocas assíncronas através de armazenamento de eventos. Em vez de informar pela rede cada consumidor interessado sobre a alteração de status, escrevemos em um repositório centralizado um evento sobre a mudança de estado, e os consumidores interessados no tópico leem tudo o que aparece dali.
- Um evento, neste caso, é uma notificação (notificações) de que algo mudou em algum lugar. Por exemplo, o status de um pedido mudou. O consumidor que precisa de dados adicionais relacionados à mudança de status e que não estão na notificação pode verificar o estado por conta própria.
- A versão máxima é o event sourcing completo, transferência de estado, onde o evento contém todas as informações necessárias para o processamento: de onde e para qual status mudaram, como exatamente os dados mudaram, etc. A questão é apenas sobre a viabilidade e a quantidade de informações que você pode se dar ao luxo de armazenar.
No âmbito do lançamento da Refund Tool, utilizamos a terceira opção. Isso simplificou o processamento de eventos, pois não é necessário obter informações detalhadas, além de eliminar o cenário em que cada novo evento gera um pico de requisições de get de esclarecimento dos consumidores.
O serviço Refund Tool não é sobrecarregado, portanto, o Kafka lá é mais um experimento do que uma necessidade. Não acho que, se o serviço de reembolso se tornasse um projeto de alta carga, os negócios ficariam satisfeitos.
Troca assíncrona AS IS
Para trocas assíncronas, o departamento de PHP geralmente usa RabbitMQ. Reunimos dados para a requisição, colocamos na fila, e o consumidor do mesmo serviço leu e enviou (ou não enviou). Para a própria API, a Lamoda usa ativamente o Swagger. Projetamos a API, descrevemos-a no Swagger, geramos o código do cliente e do servidor. Também usamos um JSON RPC 2.0 ligeiramente expandido.
Em alguns lugares, barramentos de esb são utilizados, outros vivem no activeMQ, mas, em geral, RabbitMQ — padrão.
Exchange assíncrono TO BE
Ao projetar a troca através do events-bus, traça-se uma analogia. Descrevemos de forma semelhante a futura troca de dados através das descrições da estrutura do evento. O formato yaml, a geração de código teve que ser feita manualmente, o gerador segundo a especificação cria DTO e ensina clientes e servidores a trabalhar com eles. A geração ocorre em duas linguagens — golang e php. Isso permite manter as bibliotecas consistentes. O gerador foi escrito em golang, pelo que recebeu o nome de gogi.
Event-sourcing no Kafka é algo típico. Há uma solução da versão enterprise principal do Kafka Confluent, há , solução dos nossos "irmãos" no domínio da área Zalando. Nossa motivação para começar com vanilla Kafka — é manter a solução gratuita, até decidirmos se vamos usá-la de forma ampla, além de nos deixar espaço para manobra e melhorias: queremos suporte ao nosso JSON RPC 2.0, geradores para duas linguagens e veremos o que mais.
Ironicamente, mesmo em um caso tão feliz, quando existe uma empresa aproximadamente análoga à Zalando, que fez uma solução semelhante, não podemos utilizá-la de forma eficaz.
Arquitetonicamente, no lançamento o padrão é o seguinte: lemos diretamente do Kafka, mas escrevemos apenas através do events-bus. Para leitura no Kafka há muito pronto: corretores, balanceadores e está mais ou menos pronto para escalabilidade horizontal, isso queríamos preservar. Para gravação, desejamos envolvê-la através de um Gateway aka Events-bus, e é por isso.
Events-bus
Ou ônibus de eventos. Este é simplesmente um gateway http stateless, que assume vários papéis importantes:
- Validação de produção — verificamos se os eventos estão de acordo com nossa especificação.
- Sistema mestre de eventos, ou seja, é o único sistema na empresa que responde à pergunta de quais eventos com quais estruturas são considerados válidos. A validação inclui apenas tipos de dados e enums para uma especificação rigorosa do conteúdo.
- Função hash para sharding — a estrutura da mensagem Kafka é key-value e com base no hash da key calcula-se onde colocar isso.
Por que
Trabalhamos em uma grande empresa com um processo bem estabelecido. Por que mudar algo? Este é um experimento, e esperamos obter várias vantagens.
1:n+1 trocas (um para muitos)
Com Kafka, é muito fácil conectar novos consumidores à API.
Suponha que você tenha um diretório que precisa ser mantido atualizado em vários sistemas ao mesmo tempo (incluindo novos). Antigamente, inventávamos um bundle que implementava o set-API, e informávamos à master system os endereços dos consumidores. Agora, a master system envia atualizações para um tópico, e todos os interessados leem. Um novo sistema surgiu - o inscrevemos no tópico. Sim, também é um bundle, mas mais simples.
No caso da refund-tool, que é uma parte do BOB, é conveniente manter sua sincronização através do Kafka. O Payment informa que o dinheiro foi devolvido: BOB e RT souberam disso, mudaram seus status, e o Fiscalization Service foi informado e emitiu o recibo.
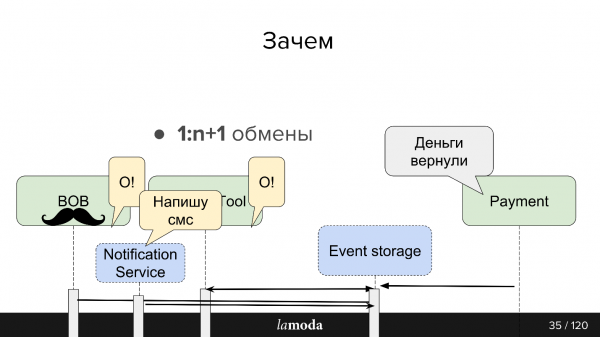
Temos planos de criar um serviço de Notificações único, que notificaria o cliente sobre atualizações de seu pedido/devoluções. Atualmente, essa responsabilidade está espalhada por vários sistemas. Será suficiente ensinar o Notifications Service a capturar informações relevantes do Kafka e reagir a elas (e desativar essas notificações nos outros sistemas). Nenhum novo intercâmbio direto será necessário.
Orientado a dados
As informações entre os sistemas estão se tornando transparentes, não importa quão "complexo" seja seu enterprise ou quão volumoso seja seu backlog. Na Lamoda, há um departamento de Análise de Dados que coleta dados dos sistemas e os transforma em uma forma reutilizável, tanto para negócios quanto para sistemas inteligentes. O Kafka permite fornecer rapidamente muitos dados e manter esse fluxo informativo atualizado.
Log de replicação
As mensagens não desaparecem após a leitura, como no RabbitMQ. Quando um evento contém informações suficientes para processamento, temos um histórico das últimas alterações do objeto e, se desejado, a possibilidade de aplicar essas mudanças.
O tempo de armazenamento do log de replicação depende da intensidade de gravação nesse tópico; o Kafka permite ajustar flexivelmente os limites de tempo de armazenamento e volume de dados. Para tópicos intensivos, é importante que todos os consumidores consigam ler as informações antes que elas desapareçam, mesmo no caso de uma breve inatividade. Normalmente, conseguimos armazenar dados por unidades de dias, o que é mais que suficiente para o suporte.
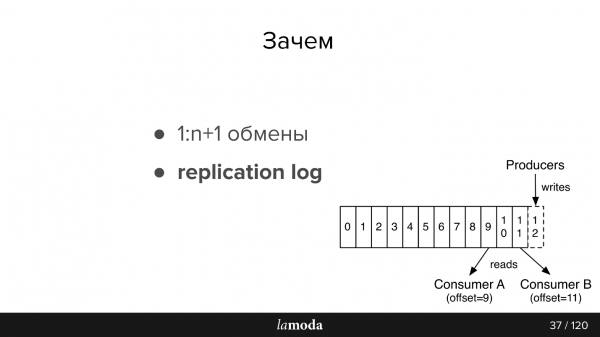
Agora um pequeno resumo da documentação, para aqueles que não estão familiarizados com o Kafka (a imagem também é da documentação)
No AMQP, existem filas: escrevemos mensagens em uma fila para o consumidor. Geralmente, uma fila é processada por um único sistema com a mesma lógica de negócios. Se precisar notificar vários sistemas, podemos ensinar o aplicativo a escrever em várias filas ou configurar um exchange com um mecanismo de fanout, que o clona automaticamente.
No Kafka, existe uma abstração semelhante tópico, onde você escreve mensagens, mas elas não desaparecem após a leitura. Por padrão, ao conectar-se ao Kafka, você recebe todas as mensagens e pode optar por salvar a posição onde parou. Ou seja, você lê de forma sequencial, pode não marcar a mensagem como lida, mas salva o ID de onde depois continuará a leitura. O ID onde você parou é chamado de offset, e o mecanismo é o commit offset.
Assim, podemos implementar diferentes lógicas. Por exemplo, temos o BOB existente em 4 instâncias para diferentes países - a Lamoda está na Rússia, Cazaquistão, Ucrânia e Bielorrússia. Como são implementadas separadamente, possuem algumas configurações próprias e sua lógica de negócios específica. Indicamos na mensagem para qual país ela se refere. Cada consumidor do BOB em cada país lê com diferentes groupId, e, se a mensagem não for relevante, ignora, ou seja, comita automaticamente o offset +1. Se o mesmo tópico for lido pelo nosso Payment Service, ele faz isso com um grupo separado, e, portanto, os offsets não se cruzam.
Requisitos para eventos:
- Completude dos dados. Gostaríamos que o evento contivesse dados suficientes para ser processado.
- Integridade. Delegamos ao Events-bus a verificação de que o evento é consistente e que ele pode ser processado.
- A ordem é importante. No caso de retornos, somos forçados a trabalhar com o histórico. Com notificações, a ordem não importa, se forem notificações homogêneas, o email será o mesmo independentemente de qual pedido chegou primeiro. No caso de um retorno, há um processo bem definido; se a ordem for alterada, surgirão exceções, o reembolso não será criado ou processado - nos encontraremos em outro status.
- Consistência. Temos um repositório e agora, em vez de API, estamos criando eventos. Precisamos de uma maneira de transmitir rapidamente e de forma barata informações sobre novos eventos e sobre alterações em eventos existentes para nossos serviços. Isso é alcançado por meio de uma especificação comum em um repositório git separado e geradores de código. Portanto, clientes e servidores em diferentes serviços estão sincronizados.
Kafka na Lamoda
Temos três instalações do Kafka:
- Logs;
- P&D;
- Eventos-bus.
Hoje, falaremos apenas sobre o último item. No events-bus, nossas instalações não são muito grandes — temos 3 brokers (servidores) e apenas 27 tópicos. Geralmente, um tópico representa um processo. Mas esse é um detalhe sutil e agora o abordaremos.
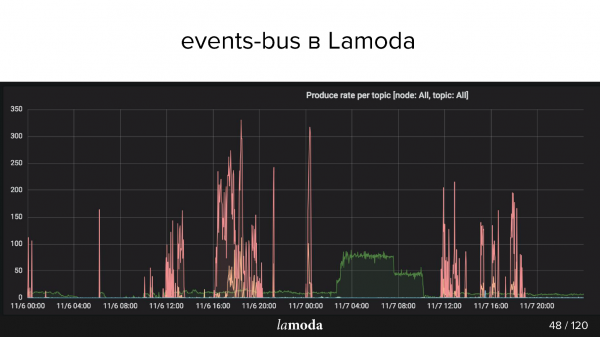
Acima está o gráfico de rps. O processo de reembolsos é marcado pela linha turquesa (sim, aquela que está na eixo X), enquanto que a linha rosa representa o processo de atualização de conteúdo.
O catálogo da Lamoda contém milhões de produtos, e os dados estão sempre sendo atualizados. Algumas coleções saem de moda, novas são lançadas, e novos modelos aparecem constantemente no catálogo. Tentamos prever o que será interessante para nossos clientes amanhã, por isso, constantemente compramos novas peças, tiramos fotos e atualizamos a vitrine.
Os picos rosas representam atualizações de produtos, ou seja, mudanças nos itens. É visível que a equipe estava fotografando, fotografando, e então, de repente! — carregou um lote de eventos.
Casos de uso do Lamoda Events
A arquitetura que construímos é utilizada para as seguintes operações:
- Monitoramento de status de devoluções: call-to-action e rastreamento de status de todos os sistemas envolvidos. Pagamento, status, fiscalização, notificações. Aqui testamos uma abordagem, criamos ferramentas, coletamos todos os bugs, escrevemos documentação e ensinamos aos colegas como usá-la.
- Atualização de ficha de produto: configuração, metadados, características. Uma sistema lê (que exibe), e vários escrevem.
- Email, push e sms: o pedido foi coletado, o pedido chegou, a devolução foi aceita, etc., temos muitos deles.
- Estoque, atualização de inventário — atualização quantitativa de itens, apenas números: entrada no estoque, devolução. É necessário que todos os sistemas relacionados à reserva de produtos operem com dados o mais atualizados possível. Atualmente, o sistema de atualização de estoque é bastante complexo, e o Kafka permitirá simplificá-lo.
- Análise de Dados (departamento de P&D), ferramentas de ML, análise, estatísticas. Queremos que as informações sejam transparentes — para isso, Kafka é uma boa opção.
Agora a parte mais interessante sobre os erros e descobertas que ocorreram ao longo de seis meses.
Problemas de design
Suponha que queremos criar algo novo — por exemplo, transferir todo o processo de entrega para o Kafka. Atualmente, parte do processo é realizada no Order Processing no BOB. Atrás da passagem do pedido para o serviço de entrega, o deslocamento para o armazém intermediário, e o demais, está um modelo de status. Existem todo um monólito, até dois, além de um monte de APIs dedicadas à entrega. Eles sabem muito mais sobre a entrega.
Parece que essas são áreas semelhantes, mas para Order Processing no BOB e para o sistema de entrega, os status diferem. Por exemplo, algumas empresas de courier não enviam status intermediários, apenas finais: "entregue" ou "perdido". Outras, ao contrário, reportam detalhadamente o deslocamento do produto. Cada uma tem suas regras de validação: para alguns, um e-mail válido significa que será processado; para outros, é inválido, mas o pedido ainda será processado porque há um telefone para contato, e alguns dirão que tal pedido não será processado.
Fluxo de dados
No caso do Kafka, surge a questão da organização do fluxo de dados. Essa tarefa está relacionada à escolha de uma estratégia em vários pontos, vamos passar por todos eles.
Em um tópico ou em diferentes?
Temos uma especificação do evento. No BOB, escrevemos que um determinado pedido deve ser entregue e especificamos: número do pedido, seu conteúdo, alguns SKUs e códigos de barras, etc. Quando o produto chega ao armazém, a entrega poderá receber status, timestamps e tudo o que for necessário. Mas depois queremos no BOB receber atualizações sobre esses dados. Surge o processo de retorno dos dados da entrega. É o mesmo evento? Ou é uma troca separada que merece um tópico separado?
Provavelmente, eles serão bastante semelhantes, e a tentação de fazer um tópico único não é infundada, porque um tópico separado significa consumidores separados, configurações separadas, geração separada de tudo isso. Mas não é certo.
Novo campo ou novo evento?
Mas se usarmos os mesmos eventos, surge outro problema. Por exemplo, nem todos os sistemas de entrega podem gerar um DTO que consiga gerar o BOB. Nós enviamos o id para eles, mas eles não os mantêm, pois não são necessários, e do ponto de vista do início do processo do event-bus, esse campo é obrigatório.
Se estabelecermos uma regra obrigatória para o event-bus, seremos forçados a colocar regras adicionais de validação no BOB ou no manipulador do evento inicial. A validação começa a se espalhar pelo serviço — isso não é muito conveniente.
Outro problema é a tentação do desenvolvimento incremental. Nos dizem que precisamos adicionar algo ao evento e, se pensarmos bem, isso deveria ser um evento separado. Mas em nosso esquema, um evento separado é um tópico separado. Um tópico separado significa todo o processo que descrevi acima. O desenvolvedor é tentado a simplesmente adicionar mais um campo ao esquema JSON e regenerar.
No caso dos reembolsos, chegamos a um evento de eventos em seis meses. Tínhamos um meta-evento chamado atualização de reembolso, que continha um campo tipo, descrevendo o que na verdade essa atualização envolve. A partir disso, tivemos "excelentes" switchers com validadores que diziam como validar esse evento com esse tipo.
Versionamento de eventos
Para validar mensagens no Kafka, pode-se usar , mas era necessário planejar isso desde o início e usar o Confluent. No nosso caso com o versionamento, temos que ser cautelosos. Nem sempre será possível reler mensagens do log de replicação, porque o modelo "saiu". Principalmente, tentamos construir versões que fossem compatíveis com versões anteriores: por exemplo, tornar um campo temporariamente opcional. Se as diferenças forem muito grandes, começamos a escrever em um novo tópico, e os clientes são migrados quando terminam de ler o antigo.
Garantia de ordem de leitura das partitions
Os tópicos dentro do Kafka são divididos em partitions. Isso não é muito importante enquanto projetamos entidades e trocas, mas é crucial quando decidimos como consumir e escalar.
Normalmente, você escreve em Kafka um tópico. Por padrão, é utilizado um único partition, e todas as mensagens desse tópico vão para ele. O consumidor, por sua vez, lê essas mensagens de forma sequencial. Agora, suponha que seja necessário expandir o sistema para que duas diferentes mensagens sejam lidas por dois consumidores distintos. Se você, por exemplo, enviar um SMS, pode dizer ao Kafka para criar um partition adicional, e o Kafka começará a dividir as mensagens em duas partes - metade aqui, metade ali.
Como o Kafka as divide? Cada mensagem tem um corpo (onde armazenamos JSON) e possui uma chave. A essa chave, é possível aplicar uma função hash, que determinará em qual partition a mensagem irá.
No nosso caso com os reembolsos, isso é importante, pois se pegarmos dois partitions, há a chance de que um consumidor paralelo processe o segundo evento antes do primeiro, o que pode causar problemas. A função hash garante que mensagens com a mesma chave caiam na mesma partition.
Eventos vs comandos
Esse é mais um problema com o qual nos deparamos. Um evento é algo que aconteceu: dizemos que algo ocorreu (something_happened), por exemplo, um item foi cancelado ou um reembolso foi feito. Se esses eventos forem ouvidos, então, ao "item cancelado", a entidade de reembolso será criada, e "um reembolso ocorreu" será registrado em algum lugar nas configurações.
Mas geralmente, ao projetar eventos, você não quer escrevê-los em vão — você espera que alguém os leia. Há uma grande tentação de não escrever something_happened (item_canceled, refund_refunded), mas algo como something_should_be_done. Por exemplo, item pronto para devolução.
Por um lado, isso sugere como o evento será utilizado. Por outro lado, isso parece muito menos com um nome normal de evento. Além disso, já não estamos longe do comando do_something. Mas você não tem garantia de que esse evento foi lido por alguém; e se foi lido, foi lido com sucesso; e se foi lido com sucesso, alguém fez algo, e isso algo ocorreu com sucesso. No momento em que o evento se torna um do_something, é necessária uma retroalimentação, e isso é um problema.
Na troca assíncrona no RabbitMQ, quando você lê a mensagem e faz uma chamada http, você tem uma resposta — ao menos, que a mensagem foi aceita. Quando você grava no Kafka, há uma mensagem indicando que você escreveu no Kafka, mas você não sabe como foi processada.
Portanto, no nosso caso, tivemos que introduzir um evento de resposta e configurar a monitorização para que, se um certo número de eventos falhar, um igual deve ser recebido após um determinado tempo. Se isso não acontecer, parece que algo deu errado. Por exemplo, se enviarmos o evento 'item_ready_to_refund', esperamos que o reembolso seja gerado, que o dinheiro seja devolvido ao cliente e que receba o evento 'money_refunded'. Mas isso não é garantido, portanto, precisamos de monitoramento.
Nuances
Há um problema bastante óbvio: se você lê a partir do tópico de forma sequencial, e há uma mensagem problemática, o consumidor falha e você não consegue avançar. Você precisa parar todos os consumidores, confirmar o offset adiante, para continuar a leitura.
Nós já sabíamos disso, planejamos para isso e mesmo assim aconteceu. E isso ocorreu porque o evento era válido do ponto de vista do events-bus, o evento era válido do ponto de vista do validador da aplicação, mas não era válido do ponto de vista do PostgreSQL, pois em um sistema temos MySQL com UNSIGNED INT, e no sistema recém desenvolvido temos apenas PostgreSQL com INT. Seu tamanho é um pouco menor e o Id não cabia. Symfony falhou com uma exceção. Claro que pegamos a exceção, pois previmos isso e pretendíamos confirmar esse offset, mas antes queríamos incrementar o contador de problemas, já que a mensagem foi processada com falha. Os contadores neste projeto também estão no banco, e o Symfony já havia fechado a comunicação com o banco, e uma segunda exceção matou todo o processo sem chances de confirmar o offset.
O serviço ficou fora do ar por um tempo — felizmente, com o Kafka isso não é tão assustador, pois as mensagens permanecem. Quando o trabalho for restabelecido, elas poderão ser lidas novamente. Isso é conveniente.
O Kafka tem a possibilidade de ajustar um offset arbitrário através de ferramentas. Mas, para fazer isso, é necessário parar todos os consumidores — no nosso caso, preparar uma versão separada, que não terá consumidores, releituras. Assim, com as ferramentas do Kafka, pode-se mover o offset, e a mensagem será processada.
Outra nuance — log de replicação vs rdkafka.so — está relacionado com a especificidade do nosso projeto. Temos PHP, e no PHP, geralmente, todas as bibliotecas se comunicam com o Kafka através do repositório rdkafka.so, e depois vem alguma camada. Pode ser que sejam apenas nossas dificuldades pessoais, mas descobri que simplesmente reler um pedaço que já foi lido não é tão simples. Em resumo, tivemos problemas de programação.
Voltando às peculiaridades do trabalho com partitions, está escrito diretamente na documentação consumers >= topic partitions. Mas eu soube disso muito depois do que gostaria. Se você quer escalar e ter dois consumidores, precisa de pelo menos duas partitions. Ou seja, se você teve uma partition, na qual acumularam-se 20 mil mensagens, e fez uma nova, o número de mensagens não vai se igualar tão cedo. Portanto, para ter dois consumidores paralelos, é necessário entender sobre partitions.
Monitoramento
Acredito que, pela forma como monitoramos, ficará ainda mais claro quais problemas existem na abordagem atual.
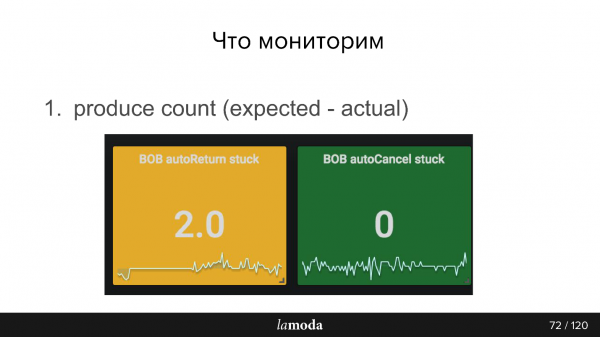
Por exemplo, contamos quantos produtos na base mudaram de status recentemente e, consequentemente, esses eventos deveriam ter ocorrido, e enviamos esse número para o nosso sistema de monitoramento. Depois, do Kafka, recebemos um segundo número, referente a quantos eventos foram realmente registrados. É evidente que a diferença entre esses dois números deve ser sempre zero.
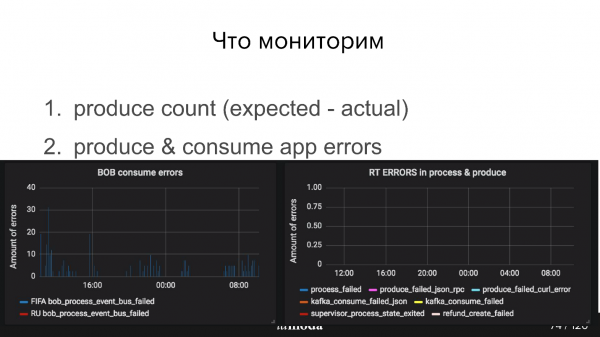
Além disso, é necessário monitorar como está o produtor, se o events-bus recebeu as mensagens e como está o consumidor. Por exemplo, nos gráficos abaixo, o Refund Tool está bem, mas o BOB claramente tem alguns problemas (picos azuis).
Já mencionei o consumer-group lag. Grosso modo, é o número de mensagens não lidas. No geral, nossos consumidores funcionam rapidamente, portanto o lag geralmente é 0, mas às vezes pode haver um pico temporário. O Kafka consegue isso facilmente, mas precisa-se definir um certo intervalo.
Há um projeto , que lhe dará mais informações sobre o Kafka. Ele simplesmente fornece através da API, pelo consumer-group, o status de como essa grupo se encontra. Além de OK e Failed, há um warning, e você poderá saber que seus consumidores não estão acompanhando o ritmo de produção — não conseguem ler o que está sendo escrito. O sistema é bastante inteligente e fácil de usar.
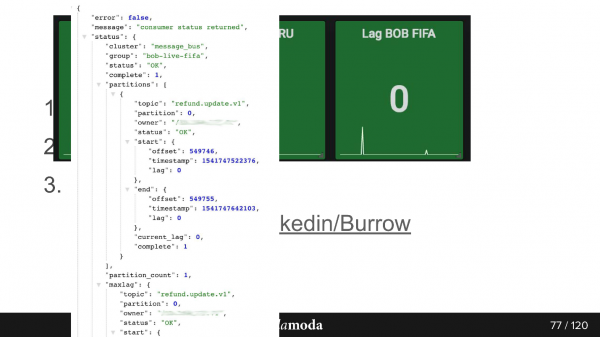
Assim é a resposta pela API. Aqui está o grupo bob-live-fifa, partition refund.update.v1, status OK, lag 0 — o último offset final correspondente é tal.
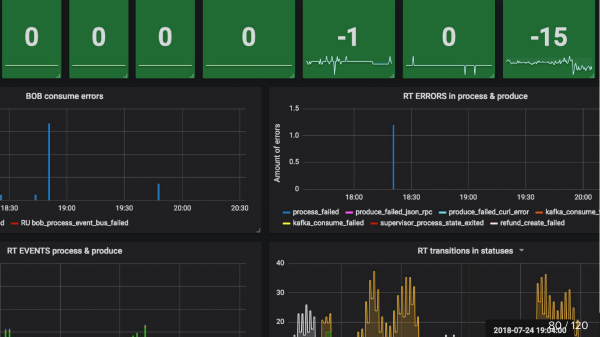
Monitoramento updated_at SLA (stuck) Eu já mencionei. Por exemplo, o produto mudou para o status de que está pronto para devolução. Nós configuramos um Cron que diz que se, em 5 minutos, esse objeto não mudar para um retorno (nós processamos reembolsos rapidamente através de sistemas de pagamento), então algo claramente deu errado, e isso é definitivamente um caso para o suporte. Portanto, simplesmente pegamos o Cron que lê essas situações, e se elas forem maiores que 0, envia um alerta.
Em resumo, usar eventos é conveniente quando:
- a informação é necessária para vários sistemas;
- o resultado do processamento não é importante;
- há poucos eventos ou eventos pequenos.
Aparentemente, o artigo tem um tema bastante específico - API assíncrono no Kafka, mas em relação a ele há várias recomendações imediatas.
Primeiro, o próximo não precisamos esperar até novembro, já em abril terá sua versão em São Petersburgo, e em junho falaremos sobre altas cargas em Novosibirsk.
Em segundo lugar, o autor da apresentação, Sergey Zaika, faz parte do Comitê de Programa da nossa nova conferência sobre gestão do conhecimento. A conferência é de um dia, ocorrerá em 26 de abril, mas seu programa é muito rico.
E também em maio teremos e (com DevOpsConf incluído) - lá ainda é possível sugerir seu tema, compartilhar sua experiência e lamentar suas dificuldades.
Fonte: habr.com
