

Anúncio
Colegas, no meio do verão, planejo lançar mais um ciclo de artigos sobre o design de sistemas de atendimento em massa: “Experimento VTrade” — uma tentativa de desenvolver uma estrutura para sistemas de negociação. O ciclo abordará a teoria e a prática da construção de uma bolsa de valores, leilão e loja. No final do artigo, convido todos a votarem nos temas que mais lhes interessam.
Este é o artigo final do ciclo sobre aplicativos reativos distribuídos em Erlang/Elixir. No pode-se encontrar as bases teóricas da arquitetura reativa. ilustra os principais padrões e mecanismos de construção de sistemas dessa natureza.
Hoje, abordaremos questões sobre o desenvolvimento da base de código e dos projetos como um todo.
Organização de serviços
Na vida real, ao desenvolver um serviço, muitas vezes é necessário combinar vários padrões de interação em um único controlador. Por exemplo, o serviço de usuários, que lida com a gestão de perfis dos usuários do projeto, deve responder a solicitações req-resp e informar sobre atualizações de perfis através de pub-sub. Este caso é bastante simples: para mensageria, existe um controlador que implementa a lógica do serviço e publica atualizações.
A situação se complica quando precisamos implementar um serviço distribuído tolerante a falhas. Suponhamos que os requisitos para os usuários mudaram:
- agora, o serviço deve processar solicitações em 5 nós do cluster,
- ter a capacidade de executar tarefas em segundo plano,
- e também ser capaz de gerenciar dinamicamente listas de assinatura para atualizações de perfis.
Observação: A questão da consistência de armazenamento e replicação de dados não será abordada. Suponha que essas questões tenham sido resolvidas anteriormente e que já exista um camada de armazenamento confiável e escalável no sistema, e os manipuladores disponham de mecanismos para interagir com ela.
A descrição formal do serviço de usuários se tornou mais complexa. Do ponto de vista do programador, devido ao uso de mensageria, as mudanças são mínimas. Para atender ao primeiro requisito, precisamos configurar o balanceamento no ponto de troca req-resp.
A exigência de processamento de tarefas em segundo plano surge frequentemente. Em users, isso pode incluir verificações de documentos dos usuários, processamento de multimídia carregada ou sincronização de dados com redes sociais. Essas tarefas precisam ser distribuídas de alguma forma dentro do cluster e monitoradas durante a execução. Portanto, temos duas opções de solução: usar o modelo de distribuição de tarefas do artigo anterior ou, se não for adequado, escrever um planejador de tarefas personalizado que gerencie o pool de processadores da forma que precisamos.
O ponto 3 requer a expansão do modelo pub-sub. Para sua implementação, após criar o ponto de troca pub-sub, precisamos ativar adicionalmente o controlador desse ponto no contexto do nosso serviço. Assim, como se estivéssemos transferindo a lógica de assinatura e desinscrição da camada de messaging para a implementação de users.
No final, a decomposição da tarefa revelou que, para atender aos requisitos, precisamos lançar 5 instâncias do serviço em diferentes nós e criar uma entidade adicional – um controlador pub-sub responsável pela assinatura.
Para iniciar 5 processadores, não é necessárias modificações no código do serviço. A única ação adicional é configurar as regras de balanceamento no ponto de troca, o que discutiremos um pouco mais tarde.
Além disso, surgiu uma complexidade adicional: o controlador pub-sub e o planejador de tarefas personalizado devem operar em uma única instância. Novamente, o serviço de messaging, como elemento fundamental, deve fornecer um mecanismo para a escolha do líder.
Escolha do líder
Em sistemas distribuídos, a escolha do líder é o procedimento de nomeação de um único processo responsável pelo planejamento do processamento distribuído de alguma carga.
Em sistemas que não são propensos à centralização, encontram-se algoritmos universais e algoritmos baseados em consenso, como o paxos ou raft.
Uma vez que o messaging é um broker e um elemento central, ele está ciente de todos os controladores do serviço – candidatos a líderes. O messaging pode nomear um líder sem a necessidade de votação.
Todos os serviços, após iniciar e se conectar ao ponto de troca, recebem uma mensagem do sistema #'$leader'{exchange = ?EXCHANGE, pid = LeaderPid, servers = Servers}. No caso de LeaderPid corresponder ao pid do processo atual, ele é nomeado líder, e a lista Servers inclui todos os nós e suas configurações.
No momento da chegada de um novo nó e da desativação de um nó ativo no cluster, todos os controladores do serviço recebem #'$slave_up'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} e #'$slave_down'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} respectivamente.
Assim, todos os componentes estão cientes de todas as mudanças, e em cada momento, há garantidamente um líder no cluster.
Intermediários
Para implementar processos de processamento distribuídos complexos e em tarefas de otimização de uma arquitetura já existente, é conveniente usar intermediários.
Para não alterar o código dos serviços e resolver, por exemplo, tarefas de processamento adicional, roteamento ou registro de mensagens, pode-se inserir um manipulador proxy antes do serviço, que realizará todo o trabalho adicional.
Um exemplo clássico de otimização pub-sub é um aplicativo distribuído com um núcleo de negócios que gera eventos de atualização, como alterações nos preços do mercado, e uma camada de acesso — N servidores que fornecem uma API websocket para clientes web.
Se a abordagem for direta, o atendimento ao cliente se apresenta da seguinte forma:
- o cliente estabelece conexões com a plataforma. No lado do servidor, onde o tráfego é encerrado, um processo é iniciado para atender essa conexão.
- no contexto do processo de atendimento, ocorre a autorização e a inscrição para atualizações. O processo chama o método subscribe para os tópicos.
- após a geração de um evento no núcleo, ele é entregue aos processos que atendem as conexões.
Vamos imaginar que temos 50.000 assinantes no tópico "news". Os assinantes estão distribuídos uniformemente entre 5 servidores. Assim, cada atualização, ao chegar no ponto de troca, será replicada 50.000 vezes: 10.000 vezes em cada servidor, de acordo com o número de assinantes nele. Uma estratégia não muito eficiente, certo?
Para melhorar a situação, vamos introduzir um proxy que tenha o mesmo nome que o ponto de troca. O registrador de nomes globais deve ser capaz de retornar o processo mais próximo pelo nome, isso é importante.
Vamos iniciar esse proxy nos servidores da camada de acesso, e todos os nossos processos que atendem a API websocket se inscreverão nele, e não no ponto de troca pub-sub original no núcleo. O proxy se inscreve no núcleo apenas em caso de uma inscrição única e replica a mensagem recebida para todos os seus assinantes.
Como resultado, entre o núcleo e os servidores de acesso, serão enviadas 5 mensagens, em vez de 50.000.
Roteamento e balanceamento
Req-Resp
Na implementação atual de messaging, existem 7 estratégias de distribuição de solicitações:
padrão. A solicitação é enviada a todos os controladores.round-robin. Realiza a distribuição cíclica de solicitações entre os controladores.consenso. Os controladores que gerenciam o serviço são divididos em líder e seguidores. As solicitações são enviadas somente ao líder.consenso & round-robin. Há um líder no grupo, mas as solicitações são distribuídas entre todos os membros.sticky. Uma função hash é calculada e vinculada a um manipulador específico. Solicitações subsequentes com essa assinatura são direcionadas ao mesmo manipulador.sticky-fun. Durante a inicialização do ponto de troca, uma função adicional para calcular o hash é passada parastickybalanceamento.função. Semelhante ao sticky-fun, mas permite redirecionar, rejeitar ou pré-processar.
A estratégia de distribuição é definida na inicialização do ponto de troca.
Além do balanceamento, o messaging permite etiquetar entidades. Vamos considerar os tipos de etiquetas no sistema:
- Etiqueta de conexão. Permite entender por qual conexão os eventos chegaram. Usado quando o processo do controlador se conecta a um ponto de troca, mas com diferentes chaves de roteamento.
- Etiqueta de serviço. Permite agrupar manipuladores para um único serviço e expandir as capacidades de roteamento e balanceamento. Para o padrão req-resp, o roteamento é linear. Enviamos uma solicitação para o ponto de troca, que então a encaminha para o serviço. Mas se precisamos dividir os manipuladores em grupos lógicos, essa divisão é feita através de etiquetas. Ao especificar uma etiqueta, a solicitação será direcionada a um grupo específico de controladores.
- Etiqueta de solicitação. Permite distinguir as respostas. Como nosso sistema é assíncrono, para processar as respostas do serviço, precisamos ser capazes de especificar um RequestTag ao enviar a solicitação. Isso nos permitirá entender qual resposta de qual solicitação chegou até nós.
Pub-sub
Para pub-sub, tudo é um pouco mais simples. Temos um ponto de troca onde as mensagens são publicadas. O ponto de troca distribui mensagens entre os assinantes que se inscreveram nas chaves de roteamento desejadas (pode-se dizer que isso é análogo a tópicos).
Escalabilidade e resistência a falhas
A escalabilidade do sistema como um todo depende do grau de escalabilidade das camadas e componentes do sistema:
- Os serviços são escaláveis adicionando nós adicionais com manipuladores desse serviço ao cluster. Durante a operação experiente, é possível escolher a política de balanceamento ideal.
- O serviço de messaging em um cluster separado, em geral, é escalável seja movendo pontos de troca excessivamente carregados para nós separados no cluster, ou adicionando processos de proxy nas áreas de carga intensa do cluster.
- A escalabilidade de todo o sistema como uma característica depende da flexibilidade da arquitetura e da capacidade de unir clusters individuais em uma entidade lógica comum.
A simplicidade e a rapidez da escalabilidade muitas vezes determinam o sucesso do projeto. O messaging na implementação atual cresce junto com o aplicativo. Mesmo se precisarmos de um cluster com 50-60 máquinas, podemos recorrer à federação. Infelizmente, o tema da federação está além do escopo deste artigo.
Redundância
Ao discutir o balanceamento de carga, já falamos sobre a reserva de controladores de serviços. No entanto, o messaging também deve ser reservado. Em caso de falha de um nó ou máquina, o messaging deve se recuperar automaticamente, e isso deve ocorrer em um curto espaço de tempo.
Em meus projetos, eu uso nós adicionais que assumem a carga em caso de falha. Em Erlang, existe uma implementação padrão do modo distribuído para aplicações OTP. O modo distribuído, na verdade, realiza a recuperação em caso de falha iniciando a aplicação que falhou em outro nó previamente iniciado. O processo é transparente; após a falha, a aplicação é automaticamente transferida para o nó de failover. Você pode ler mais sobre essa funcionalidade. .
Desempenho
Vamos tentar, ao menos de maneira aproximada, comparar o desempenho do rabbitmq com o nosso messaging personalizado.
Eu encontrei dos testes do rabbitmq pela equipe do openstack.
Na seção 6.14.1.2.1.2.2 do documento original, é apresentado o resultado do RPC CAST:
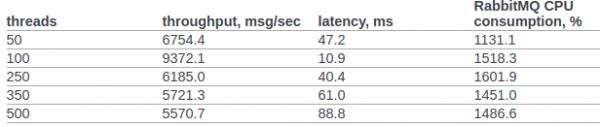
Preliminarmente, não faremos nenhuma configuração adicional no núcleo do SO ou na VM Erlang. As condições para os testes são:
- erl opts: +A1 +sbtu.
- O teste em um único nó Erlang é executado em um laptop com um antigo i7 em versão móvel.
- Os testes em cluster são realizados em servidores com rede de 10G.
- O código funciona em contêineres Docker. A rede está em modo NAT.
Código do teste:
req_resp_bench(_) ->
  W = perftest:comprehensive(10000,
    fun() ->
      messaging:request(?EXCHANGE, default, ping, self()),
      receive
        #'$msg'{message = pong} -> ok
      after 5000 ->
        throw(timeout)
      end
    end
  ),
  true = lists:any(fun(E) -> E >= 30000 end, W),
  ok.
Cenário 1: O teste é executado em um laptop com um velho i7 de versão móvel. O teste, o messaging e o serviço são executados em um único nó dentro de um contêiner Docker:
Ciclos sequenciais de 10000 em ~0 segundos (26987 ciclos/s)
Ciclos sequenciais de 20000 em ~1 segundo (26915 ciclos/s)
Ciclos sequenciais de 100000 em ~4 segundos (26957 ciclos/s)
Ciclos paralelos de 2 100000 em ~2 segundos (44240 ciclos/s)
Ciclos paralelos de 4 100000 em ~2 segundos (53459 ciclos/s)
Ciclos paralelos de 10 100000 em ~2 segundos (52283 ciclos/s)
Ciclos paralelos de 100 100000 em ~3 segundos (49317 ciclos/s)
Cenário 2: 3 nós executados em máquinas diferentes sob Docker (NAT).
Ciclos sequenciais de 10000 em ~1 segundo (8684 ciclos/s)
Ciclos sequenciais de 20000 em ~2 segundos (8424 ciclos/s)
Ciclos sequenciais de 100000 em ~12 segundos (8655 ciclos/s)
Ciclos paralelos de 2 100000 em ~7 segundos (15160 ciclos/s)
Ciclos paralelos de 4 100000 em ~5 segundos (19133 ciclos/s)
Ciclos paralelos de 10 100000 em ~4 segundos (24399 ciclos/s)
Ciclos paralelos de 100 100000 em ~3 segundos (34517 ciclos/s)
Em todos os casos, a utilização da CPU não ultrapassou 250%
Resultados
Espero que este ciclo não pareça um derramamento de consciência e que minha experiência traga benefícios reais tanto para pesquisadores de sistemas distribuídos quanto para profissionais que estão apenas começando a construir arquiteturas distribuídas para seus sistemas de negócios e que olham com interesse para Erlang/Elixir, mas duvidam se vale a pena...
Foto
Apenas usuários registrados podem participar da pesquisa. , por favor.
Quais tópicos devo abordar mais detalhadamente no ciclo 'Experimento VTrade'?
Teoria: Mercados, ordens e períodos de validade: DAY, GTD, GTC, IOC, FOK, MOO, MOC, LOO, LOC
Livro de ordens. Teoria e prática da implementação do livro com agrupamentos
Visualização de negociações: Ticks, barras, resoluções. Como armazenar e como compor
Backoffice. Planejamento e desenvolvimento. Controle de funcionários e investigação de incidentes
API. Vamos entender quais interfaces são necessárias e como implementá-las
Armazenamento de informações: PostgreSQL, Timescale, Tarantool em sistemas de negociação
Reatividade em sistemas de negociação
Outro. Escreverei nos comentários
6 usuários votaram. 4 usuários se abstiveram.
Fonte: habr.com
