

Neste post, gostaríamos de compartilhar uma maneira interessante de lidar com a configuração de um sistema distribuído.
A configuração é representada diretamente na linguagem Scala de maneira tipada e segura. Uma implementação de exemplo é descrita em detalhes. Vários aspectos da proposta são discutidos, incluindo a influência no processo de desenvolvimento geral.
()
Introdução
Construir sistemas distribuídos robustos requer o uso de configurações corretas e coerentes em todos os nós. Uma solução típica é utilizar uma descrição de implantação textual (terraform, ansible ou algo semelhante) e arquivos de configuração gerados automaticamente (geralmente, dedicados para cada nó/cargo). Também gostaríamos de usar os mesmos protocolos das mesmas versões em cada nó comunicante (caso contrário, poderíamos experimentar problemas de incompatibilidade). No mundo JVM, isso significa que pelo menos a biblioteca de mensagens deve ser da mesma versão em todos os nós comunicantes.
E quanto aos testes do sistema? Claro, devemos ter testes unitários para todos os componentes antes de chegarmos aos testes de integração. Para poder extrapolar os resultados dos testes em tempo de execução, devemos garantir que as versões de todas as bibliotecas sejam mantidas idênticas nos ambientes de execução e teste.
Ao executar testes de integração, muitas vezes é muito mais fácil ter o mesmo classpath em todos os nós. Precisamos apenas garantir que o mesmo classpath seja usado na implantação. (É possível usar classpaths diferentes em nós diferentes, mas é mais difícil representar essa configuração e implantá-la corretamente.) Portanto, para manter as coisas simples, consideraremos apenas classpaths idênticos em todos os nós.
A configuração tende a evoluir junto com o software. Normalmente, usamos versões para identificar várias
etapas da evolução do software. Parece razoável cobrir a configuração sob gerenciamento de versão e identificar diferentes configurações com alguns rótulos. Se houver apenas uma configuração em produção, podemos usar uma única versão como identificador. Às vezes, podemos ter múltiplos ambientes de produção. E para cada ambiente, podemos precisar de um ramo separado de configuração. Assim, as configurações podem ser rotuladas com ramo e versão para identificar exclusivamente diferentes configurações. Cada rótulo de ramo e versão corresponde a uma única combinação de nós distribuídos, portas, recursos externos, versões de bibliotecas classpath em cada nó. Aqui, cobriremos apenas o ramo único e identificaremos configurações por uma versão decimal de três componentes (1.2.3), da mesma forma que outros artefatos.
Em ambientes modernos, os arquivos de configuração não são mais modificados manualmente. Normalmente, geramos
arquivos de configuração no momento da implantação e depois. Portanto, alguém poderia perguntar por que ainda usamos formato de texto para arquivos de configuração? Uma opção viável é colocar a configuração dentro de uma unidade de compilação e beneficiar-se da validação de configuração em tempo de compilação.
Neste post, examinaremos a ideia de manter a configuração no artefato compilado.
Configuração compilável
Nesta seção, discutiremos um exemplo de configuração estática. Dois serviços simples — serviço de eco e o cliente do serviço de eco estão sendo configurados e implementados. Em seguida, dois sistemas distribuídos diferentes com ambos os serviços são instanciados. Um é para uma configuração de nodo único e outro para uma configuração de dois nós.
Um sistema distribuído típico consiste em alguns nós. Os nós poderiam ser identificados usando algum tipo:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
ou apenas
case class NodeId(hostName: String)ou até mesmo
object Singleton
type NodeId = Singleton.type
Esses nós desempenham várias funções, executam alguns serviços e devem ser capazes de se comunicar com os outros nós por meio de conexões TCP/HTTP.
Para a conexão TCP, é necessário pelo menos um número de porta. Também queremos garantir que o cliente e o servidor estejam usando o mesmo protocolo. Para modelar uma conexão entre nodos, vamos declarar a seguinte classe:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])onde Porta é apenas um Int dentro da faixa permitida:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Tipos refinados
Veja biblioteca. Em resumo, permite adicionar restrições de tempo de compilação a outros tipos. Neste caso Int só é permitido ter valores de 16 bits que podem representar o número da porta. Não há exigência de usar essa biblioteca para esse método de configuração. Parece apenas se encaixar muito bem.
Para o HTTP (REST), também pode ser necessário um caminho do serviço:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Tipo fantasma
Para identificar o protocolo durante a compilação, estamos usando o recurso do Scala de declarar argumento de tipo Protocol que não é utilizado na classe. É um chamado tipo fantasma. Em tempo de execução, raramente precisamos de uma instância do identificador de protocolo, por isso não o armazenamos. Durante a compilação, esse tipo fantasma fornece segurança de tipo adicional. Não podemos passar a porta com um protocolo incorreto.
Um dos protocolos mais amplamente utilizados é o REST API com a serialização Json:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]onde RequestMessage é o tipo base das mensagens que o cliente pode enviar ao servidor e ResponseMessage é a mensagem de resposta do servidor. Claro, podemos criar outras descrições de protocolo que especifiquem o protocolo de comunicação com a precisão desejada.
Para os propósitos deste post, usaremos uma versão mais simples do protocolo:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]Neste protocolo, a mensagem de solicitação é anexada à URL e a mensagem de resposta é retornada como uma string simples.
Uma configuração de serviço pode ser descrita pelo nome do serviço, uma coleção de portas e algumas dependências. Existem algumas maneiras possíveis de representar todos esses elementos no Scala (por exemplo, HList, tipos de dados algébricos). Para os propósitos deste post, usaremos o Cake Pattern e representaremos peças combináveis (módulos) como traits. (O Cake Pattern não é uma exigência para esse método de configuração compilável. É apenas uma possível implementação da ideia.)
As dependências podem ser representadas usando o Cake Pattern como endpoints de outros nós:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
O serviço de eco só precisa de uma porta configurada. E declaramos que essa porta suporta o protocolo de eco. Note que não precisamos especificar uma porta particular neste momento, porque o trait permite a declaração de métodos abstratos. Se usarmos métodos abstratos, o compilador exigirá uma implementação em uma instância de configuração. Aqui fornecemos a implementação (8081) e ela será usada como o valor padrão se a pulamos em uma configuração concreta.
Podemos declarar uma dependência na configuração do cliente do serviço de eco:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
A dependência tem o mesmo tipo que o echoService. Em particular, exige o mesmo protocolo. Portanto, podemos ter certeza de que se conectarmos essas duas dependências, elas funcionarão corretamente.
Implementação dos serviços
Um serviço precisa de uma função para iniciar e desligar suavemente. (A capacidade de desligar um serviço é crítica para os testes.) Novamente, existem algumas opções para especificar tal função para uma configuração dada (por exemplo, poderíamos usar classes de tipo). Para este post, usaremos novamente o Padrão Cake. Podemos representar um serviço usando cats.Resource que já fornece delimitação e liberação de recursos. Para adquirir um recurso, devemos fornecer uma configuração e algum contexto de tempo de execução. Portanto, a função de início do serviço pode parecer com:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
onde
Config— tipo de configuração que é necessária para este iniciador de serviçoAddressResolver— um objeto em tempo de execução que tem a capacidade de obter endereços reais de outros nós (continue lendo para detalhes).
os outros tipos vêm de cats:
F[_]— tipo de efeito (No caso mais simplesF[A]poderia ser apenas() => A. Neste post, usaremoscats.IO.)Reader[A,B]— é mais ou menos um sinônimo para uma funçãoA => Bcats.Resource— tem maneiras de adquirir e liberarTimer— permite dormir/medir tempoContextShift— análogo aExecutionContextApplicative— wrapper de funções em efeito (quase um monad) (podemos eventualmente substituí-lo por algo diferente)
Usando essa interface, podemos implementar alguns serviços. Por exemplo, um serviço que não faz nada:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Veja para implementações de outros serviços — ,
e .)
Um nó é um único objeto que executa alguns serviços (iniciar uma cadeia de recursos é habilitado pelo Padrão Cake):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Observe que no nó especificamos o tipo exato de configuração que é necessária para esse nó. O compilador não nos deixará construir o objeto (Cake) com um tipo insuficiente, porque cada traço de serviço declara uma restrição sobre o Config tipo. Também não conseguiremos iniciar o nó sem fornecer uma configuração completa.
Resolução de endereço do nó
Para estabelecer uma conexão, precisamos de um endereço real do host para cada nó. Esse endereço pode ser conhecido mais tarde do que outras partes da configuração. Portanto, precisamos de uma maneira de fornecer um mapeamento entre o id do nó e seu endereço real. Esse mapeamento é uma função:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Existem algumas maneiras possíveis de implementar tal função.
- Se soubermos os endereços reais antes da implantação, durante a instanciação dos hosts do nó, então podemos gerar código Scala com os endereços reais e executar a compilação depois (que realiza verificações em tempo de compilação e, em seguida, executa a suíte de testes de integração). Nesse caso, nossa função de mapeamento é conhecida estaticamente e pode ser simplificada para algo como um
Map[NodeId, NodeAddress]. - Às vezes, obtemos endereços reais apenas em um ponto posterior, quando o nó é realmente iniciado, ou não temos endereços de nós que ainda não foram iniciados. Nesse caso, poderíamos ter um serviço de descoberta que é iniciado antes de todos os outros nós e cada nó pode anunciar seu endereço nesse serviço e assinar dependências.
- Se pudermos modificar
/etc/hosts, podemos usar nomes de host predefinidos (comomy-project-main-nodeeecho-backend) e apenas associar esse nome ao endereço IP no momento da implantação.
Neste post, não cobrimos esses casos em mais detalhes. Na verdade, em nosso exemplo simplificado, todos os nós terão o mesmo endereço IP — 127.0.0.1.
Neste post, consideraremos dois layouts de sistemas distribuídos:
- Layout de único nó, onde todos os serviços estão colocados em um único nó.
- Layout de dois nós, onde o serviço e o cliente estão em nós diferentes.
A configuração para um é a seguinte:
Configuração de único nó
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identificador do único nó
  \/\/ configuração do servidor
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Especificação de porta de serviço segura em tipo. *\/\n  override def portNumber: PortNumber = 8088\n
  \/\/ configuração do cliente

  \/** Usaremos o serviço fornecido pelo mesmo host. *\/\n  def echoServiceDependency = echoService\n
  override def testMessage: UrlPathElement = "hello"\n
  def pollInterval: FiniteDuration = 1.second\n
  \/\/ configuração do controlador de ciclo de vida\n  def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0,5 segundos adicionais para que haja 10 requisições, não 9.\n}
Aqui criamos uma configuração única que estende tanto a configuração do servidor quanto a do cliente. Também configuramos um controlador de ciclo de vida que normalmente encerrará o cliente e o servidor após vida útil o intervalo passar.
O mesmo conjunto de implementações e configurações de serviços pode ser usado para criar um layout de sistema com dois nós separados. Precisamos apenas criar com os serviços apropriados:
Configuração de dois nós
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! especificação da dependência\n    def echoServiceDependency = NodeServerConfig.echoService\n
    def pollInterval: FiniteDuration = 1.second\n
    def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0,5 segundos adicionais para que haja 10 requisições, não 9.\n
    def testMessage: String = "dolly"\n  }
Veja como especificamos a dependência. Mencionamos o serviço fornecido pelo outro nó como uma dependência do nó atual. O tipo de dependência é verificado porque contém um tipo fantasma que descreve o protocolo. E, em tempo de execução, teremos o ID do nó correto. Este é um dos aspectos importantes da abordagem de configuração proposta. Ele nos proporciona a capacidade de definir a porta apenas uma vez e garantir que estamos referenciando a porta correta.
Implementação de dois nós
Para esta configuração, usamos exatamente as mesmas implementações de serviços. Nenhuma alteração. No entanto, criamos duas implementações de nós diferentes que contêm conjuntos diferentes de serviços:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
O primeiro nó implementa o servidor e apenas precisa da configuração do lado do servidor. O segundo nó implementa o cliente e precisa de outra parte da configuração. Ambos os nós requerem alguma especificação de vida útil. Para fins deste post, o nó de serviço terá uma vida útil infinita que pode ser encerrada usando SIGTERM, enquanto o cliente de eco será encerrado após o tempo configurado. Veja a para detalhes.
Processo geral de desenvolvimento
Vamos ver como essa abordagem muda a forma como trabalhamos com configuração.
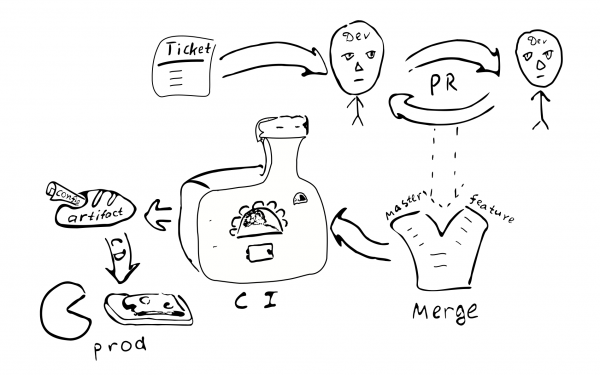
A configuração como código será compilada e produzirá um artefato. Parece razoável separar o artefato de configuração de outros artefatos de código. Muitas vezes, podemos ter uma infinidade de configurações na mesma base de código. E, claro, podemos ter várias versões de diferentes ramificações de configuração. Em uma configuração, podemos selecionar versões específicas de bibliotecas e isso permanecerá constante sempre que implantarmos essa configuração.
Uma mudança de configuração se torna uma mudança de código. Portanto, deve ser coberta pelo mesmo processo de garantia de qualidade:
Ticket -> PR -> revisão -> mesclagem -> integração contínua -> implantação contínua
As seguintes consequências do método são:
- A configuração é coerente para uma instância de sistema particular. Parece que não há como ter uma conexão incorreta entre os nós.
- Não é fácil alterar a configuração apenas em um nó. Parece irracional fazer login e mudar alguns arquivos de texto. Assim, a derivação de configuração se torna menos provável.
- Mudanças pequenas na configuração não são fáceis de fazer.
- A maioria das mudanças de configuração seguirá o mesmo processo de desenvolvimento e passará por alguma revisão.
Precisamos de um repositório separado para a configuração de produção? A configuração de produção pode conter informações sensíveis que gostaríamos de manter fora do alcance de muitas pessoas. Portanto, pode valer a pena manter um repositório separado com acesso restrito que conterá a configuração de produção. Podemos dividir a configuração em duas partes — uma que contém a maioria dos parâmetros abertos da produção e outra que contém a parte secreta da configuração. Isso permitiria acesso à maioria dos desenvolvedores à vasta maioria dos parâmetros, enquanto restringe o acesso a coisas realmente sensíveis. É fácil conseguir isso usando características intermediárias com valores padrão de parâmetro.
Variações
Vamos ver os prós e contras da abordagem proposta em comparação com as outras técnicas de gerenciamento de configuração.
Primeiramente, listaremos algumas alternativas para os diferentes aspectos da maneira proposta de lidar com configuração:
- Arquivo de texto na máquina alvo.
- Armazenamento centralizado de chave-valor (como
etcd/zookeeper). - Componentes de subprocesso que podem ser reconfigurados/reiniciados sem reiniciar o processo.
- Configuração fora do artefato e do controle de versão.
O arquivo de texto oferece alguma flexibilidade em termos de correções pontuais. Um administrador de sistema pode fazer login no nó alvo, fazer uma alteração e simplesmente reiniciar o serviço. Isso pode não ser tão bom para sistemas maiores. Nenhuma evidência da mudança é deixada para trás. A mudança não é revisada por outra pessoa. Pode ser difícil descobrir o que causou a mudança. Não foi testada. Sob a perspectiva de um sistema distribuído, um administrador pode simplesmente esquecer de atualizar a configuração em um dos outros nós.
(A propósito, se eventualmente houver a necessidade de começar a usar arquivos de configuração de texto, só teremos que adicionar um parser + validador que possa produzir o mesmo Config tipo e isso seria suficiente para começar a usar configurações de texto. Isso também mostra que a complexidade da configuração em tempo de compilação é um pouco menor que a complexidade das configurações baseadas em texto, porque na versão baseada em texto precisamos de algum código adicional.)
O armazenamento centralizado de chave-valor é um bom mecanismo para distribuir parâmetros meta de aplicativo. Aqui precisamos pensar sobre o que consideramos ser valores de configuração e o que é apenas dados. Dada uma função C => A => B geralmente chamamos valores que mudam raramente de C «configuração», enquanto dados frequentemente alterados A são apenas dados de entrada. A configuração deve ser fornecida à função antes dos dados. A. Dada essa ideia, podemos dizer que a frequência esperada de mudanças pode ser usada para distinguir dados de configuração de apenas dados. Além disso, os dados geralmente vêm de uma fonte (usuário) e a configuração vem de uma fonte diferente (administrador). Lidar com parâmetros que podem ser alterados após a inicialização do processo leva a um aumento da complexidade da aplicação. Para tais parâmetros, teremos que lidar com seu mecanismo de entrega, análise e validação, além do manuseio de valores incorretos. Portanto, para reduzir a complexidade do programa, é melhor diminuirmos o número de parâmetros que podem mudar em tempo de execução (ou até eliminá-los completamente).
Do ponto de vista deste post, devemos fazer uma distinção entre parâmetros estáticos e dinâmicos. Se a lógica do serviço requer uma alteração rara de alguns parâmetros em tempo de execução, podemos chamá-los de parâmetros dinâmicos. Caso contrário, eles são estáticos e podem ser configurados usando a abordagem proposta. Para a reconfiguração dinâmica, podem ser necessárias outras abordagens. Por exemplo, partes do sistema podem ser reiniciadas com novos parâmetros de configuração de maneira similar ao reinício de processos separados de um sistema distribuído.
(Na minha humilde opinião, devemos evitar a reconfiguração em tempo de execução, pois isso aumenta a complexidade do sistema.
Pode ser mais direto confiar no suporte do SO para reiniciar processos. No entanto, isso pode nem sempre ser possível.)
Um aspecto importante do uso de configuração estática, que às vezes faz com que as pessoas considerem a configuração dinâmica (sem outros motivos), é o tempo de inatividade do serviço durante a atualização de configuração. De fato, se tivermos que fazer alterações na configuração estática, precisamos reiniciar o sistema para que novos valores se tornem eficazes. Os requisitos de tempo de inatividade variam para diferentes sistemas, então pode não ser tão crítico. Se for crítico, precisaremos planejar com antecedência qualquer reinício do sistema. Por exemplo, poderíamos implementar . Neste cenário, sempre que precisamos reiniciar o sistema, iniciamos uma nova instância do sistema em paralelo e depois mudamos o ELB para ela, enquanto deixamos o sistema antigo completar o atendimento das conexões existentes.
E quanto a manter a configuração dentro de um artefato versionado ou fora dele? Manter a configuração dentro de um artefato significa, na maioria dos casos, que essa configuração passou pelo mesmo processo de garantia de qualidade que outros artefatos. Assim, pode-se ter certeza de que a configuração é de boa qualidade e confiável. Por outro lado, a configuração em um arquivo separado significa que não há rastros de quem e por que fez alterações nesse arquivo. Isso é importante? Acreditamos que, para a maioria dos sistemas de produção, é melhor ter uma configuração estável e de alta qualidade.
A versão do artefato permite descobrir quando foi criado, quais valores contém, quais recursos estão ativados/desativados, quem foi responsável por cada alteração na configuração. Isso pode exigir algum esforço para manter a configuração dentro de um artefato e é uma escolha de design a ser feita.
Prós & cons
Aqui gostaríamos de destacar algumas vantagens e discutir algumas desvantagens da abordagem proposta.
Vantagens
Características da configuração compilável de um sistema distribuído completo:
- Verificação estática da configuração. Isso proporciona um alto nível de confiança de que a configuração está correta, dadas as restrições de tipo.
- Linguagem rica de configuração. Tipicamente, outras abordagens de configuração são limitadas a, no máximo, substituição de variáveis.
Usando Scala, pode-se utilizar uma ampla gama de recursos de linguagem para melhorar a configuração. Por exemplo, podemos usar traits para fornecer valores padrão, objetos para definir diferentes escopos, podemos nos referir avals definidos apenas uma vez no escopo externo (DRY). É possível usar sequências literais ou instâncias de certas classes (Seq,Map, etc.). - DSL. O Scala oferece um suporte decente para escritores de DSL. Pode-se usar esses recursos para estabelecer uma linguagem de configuração mais conveniente e amigável ao usuário final, de modo que a configuração final seja, pelo menos, legível para os usuários do domínio.
- Integridade e coerência entre nós. Um dos benefícios de ter a configuração de todo o sistema distribuído em um só lugar é que todos os valores são definidos estritamente uma vez e, em seguida, reutilizados em todos os lugares onde precisamos deles. Além disso, declarações de porta seguras garantem que, em todas as configurações possíveis corretas, os nós do sistema falem a mesma língua. Há dependências explícitas entre nós, o que dificulta esquecer de fornecer alguns serviços.
- Alta qualidade das mudanças. A abordagem geral de passar mudanças de configuração através do processo normal de PR estabelece altos padrões de qualidade também na configuração.
- Mudanças de configuração simultâneas. Sempre que fazemos alterações na configuração, a implantação automática garante que todos os nós sejam atualizados.
- Simplificação da aplicação. A aplicação não precisa analisar e validar a configuração e lidar com valores de configuração incorretos. Isso simplifica a aplicação como um todo. (Algum aumento de complexidade está na própria configuração, mas é uma troca consciente em direção à segurança.) É bastante simples voltar à configuração comum — basta adicionar as peças que estão faltando. É mais fácil começar com configuração compilada e adiar a implementação de peças adicionais para um momento posterior.
- Configuração versionada. Devido ao fato de que as mudanças de configuração seguem o mesmo processo de desenvolvimento, como resultado, obtemos um artefato com versão única. Isso nos permite retornar à configuração se necessário. Podemos até implantar uma configuração que foi usada há um ano e ela funcionará exatamente da mesma maneira. Configurações estáveis melhoram a previsibilidade e a confiabilidade do sistema distribuído. A configuração é fixada em tempo de compilação e não pode ser facilmente alterada em um sistema de produção.
- Modularidade. O framework proposto é modular e os módulos podem ser combinados de várias maneiras para
suportar diferentes configurações (configurações/disposições). Em particular, é possível ter uma configuração de node único de pequena escala e uma configuração multi-node de grande escala. É razoável ter múltiplas configurações de produção. - Testes. Para fins de teste, pode-se implementar um serviço simulado e usá-lo como uma dependência de forma segura em termos de tipo. Vários layouts de teste diferentes, com várias partes substituídas por simulações, poderiam ser mantidos simultaneamente.
- Teste de integração. Às vezes, em sistemas distribuídos, é difícil executar testes de integração. Usando a abordagem descrita para configuração segura em termos de tipo de todo o sistema distribuído, podemos executar todas as partes distribuídas em um único servidor de forma controlada. É fácil emular a situação
quando um dos serviços se torna indisponível.
Desvantagens
A abordagem de configuração compilada é diferente da configuração «normal» e pode não atender a todas as necessidades. Aqui estão algumas das desvantagens da configuração compilada:
- Configuração estática. Pode não ser adequada para todas as aplicações. Em alguns casos, há a necessidade de corrigir rapidamente a configuração em produção, contornando todas as medidas de segurança. Essa abordagem torna isso mais difícil. A compilação e a reimplantação são necessárias após qualquer mudança na configuração. Essa é uma característica e uma carga.
- Geração de configuração. Quando a configuração é gerada por uma ferramenta de automação, essa abordagem requer a compilação subsequente (que pode, por sua vez, falhar). Pode exigir um esforço adicional para integrar essa etapa adicional no sistema de construção.
- Instrumentos. Existem muitas ferramentas em uso hoje que dependem de configurações baseadas em texto. Algumas delas
não serão aplicáveis quando a configuração for compilada. - Uma mudança de mentalidade é necessária. Desenvolvedores e DevOps estão familiarizados com arquivos de configuração de texto. A ideia de compilar a configuração pode parecer estranha para eles.
- Antes de introduzir a configuração compilável, é necessário um processo de desenvolvimento de software de alta qualidade.
Existem algumas limitações do exemplo implementado:
- Se fornecer configurações extras que não são exigidas pela implementação do nó, o compilador não nos ajudará a detectar a implementação ausente. Isso pode ser abordado usando
HListou ADTs (classes de caso) para configuração de nós em vez de traits e Cake Pattern. - Precisamos fornecer algum código inicial no arquivo de configuração: (
pacote,importar,objetodeclarações;
sobrepor def‘s para parâmetros que têm valores padrão). Isso pode ser parcialmente abordado usando um DSL. - Neste post, não abordamos a reconfiguração dinâmica de clusters de nós similares.
Conclusão
Neste post, discutimos a ideia de representar a configuração diretamente no código-fonte de maneira segura em termos de tipo. A abordagem pode ser utilizada em muitas aplicações como substituto para configurações baseadas em xml e outros textos. Apesar de nosso exemplo ter sido implementado em Scala, ele também pode ser traduzido para outras linguagens compiláveis (como Kotlin, C#, Swift, etc.). Alguém poderia experimentar essa abordagem em um novo projeto e, caso não se encaixe bem, retornar ao modo tradicional.
Claro, a configuração compilável requer um processo de desenvolvimento de alta qualidade. Em troca, promete fornecer uma configuração robusta de qualidade igualmente alta.
Essa abordagem pode ser estendida de várias maneiras:
- Pode-se usar macros para realizar a validação da configuração e falhar em tempo de compilação em caso de falhas em restrições da lógica de negócios.
- Um DSL pode ser implementado para representar a configuração de uma maneira amigável ao usuário do domínio.
- Gerenciamento dinâmico de recursos com ajustes automáticos na configuração. Por exemplo, ao ajustarmos o número de nós do cluster, podemos querer (1) que os nós obtenham uma configuração ligeiramente modificada; (2) o gerenciador do cluster receba novas informações dos nós.
Obrigado
Gostaria de agradecer a Andrey Saksonov, Pavel Popov, Anton Nehaev pelo feedback inspirador sobre o rascunho deste post, que me ajudou a torná-lo mais claro.
Fonte: habr.com
