

Olá, eu sou Sergey Ylantsev, desenvolvendo na Yandex.Cloud. Anteriormente, eu liderei o desenvolvimento do balanceador L7 do portal Yandex — meus colegas brincam que, independentemente do que eu faça, acaba sendo um balanceador. Vou contar aos leitores do Habr como gerenciar a carga na plataforma de nuvem, qual ferramenta ideal imaginamos para alcançar esse objetivo e como estamos avançando na construção dessa ferramenta.
Para começar, vamos introduzir alguns termos:
- VIP (Virtual IP) — endereço IP do balanceador
- Servidor, backend, instância — máquina virtual com um aplicativo em execução
- RIP (Real IP) — endereço IP do servidor
- Healthcheck — verificação de prontidão do servidor
- Zona de disponibilidade, Availability Zone, AZ — infraestrutura isolada em um data center
- Região — combinação de diferentes AZ
Os balanceadores de carga resolvem três tarefas principais: realizam o balanceamento em si, melhoram a resiliência do serviço e facilitam sua escalabilidade. A resiliência é garantida pela gerência automática do tráfego: o balanceador monitora o status do aplicativo e exclui da balanceação as instâncias que não passaram pela verificação de vida. A escalabilidade é alcançada pela distribuição uniforme da carga entre as instâncias, bem como pela atualização da lista de instâncias em tempo real. Se o balanceamento não for suficientemente uniforme, algumas instâncias receberão uma carga que excede seu limite operacional, tornando o serviço menos confiável.
Os balanceadores de carga costumam ser classificados pelo nível do protocolo do modelo OSI no qual operam. O balanceador de nuvem opera no nível TCP, que corresponde ao quarto nível, L4.
Vamos passar para a visão geral da arquitetura do balanceador de nuvem. Vamos aumentar gradualmente o nível de detalhamento. Dividimos os componentes do balanceador em três classes. A classe config plane é responsável pela interação com o usuário e mantém o estado desejado do sistema. A control plane armazena o estado atual do sistema e gerencia as instâncias da classe data plane, que são responsáveis diretamente pela entrega do tráfego dos clientes para suas instâncias.
Data plane
O tráfego chega a dispositivos caros chamados roteadores de borda. Para aumentar a resistência a falhas, vários desses dispositivos operam simultaneamente em um único data center. Em seguida, o tráfego chega aos balanceadores, que anunciam um endereço IP anycast a todas as zonas de disponibilidade (AZ) via BGP para os clientes.
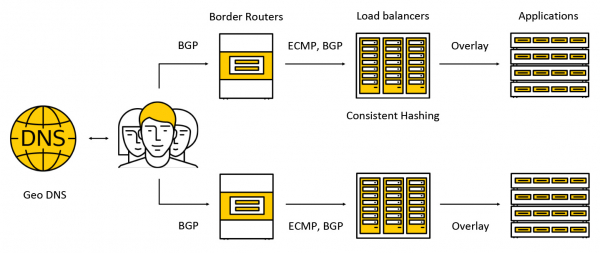
O tráfego é transmitido por ECMP — uma estratégia de roteamento na qual pode haver várias rotas igualmente boas para o destino (neste caso, o endereço IP de destino) e os pacotes podem ser enviados por qualquer uma delas. Também suportamos a operação em várias zonas de disponibilidade da seguinte maneira: anunciamos o endereço em cada uma das zonas, e o tráfego chega à mais próxima, sem sair dela. No próximo post, vamos analisar em detalhe o que acontece com o tráfego.
Config plane
O componente chave do config plane é a API, através da qual são realizadas as operações principais com os balanceadores: criação, remoção, modificação dos instâncias, obtenção dos resultados de healthchecks, etc. Por um lado, é uma API REST, e por outro, frequentemente usamos o framework gRPC na Nuvem, por isso 'traduzimos' REST para gRPC e, em seguida, usamos apenas gRPC. Qualquer requisição resulta na criação de uma série de tarefas assíncronas idempotentes, que são executadas em um pool comum de trabalhadores do Yandex.Cloud. As tarefas são escritas de forma que podem ser suspensas a qualquer momento e, em seguida, reiniciadas. Isso garante escalabilidade, repetibilidade e registro das operações.
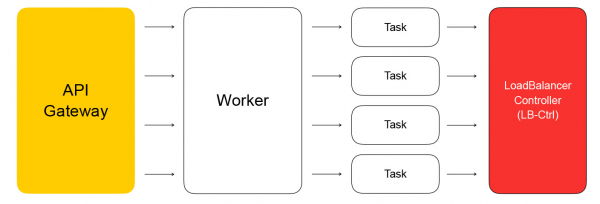
Assim, a tarefa da API fará uma requisição ao serviço controlador dos balanceadores, que foi escrito em Go. Ele pode adicionar e remover balanceadores, alterar o conjunto de backends e configurações.
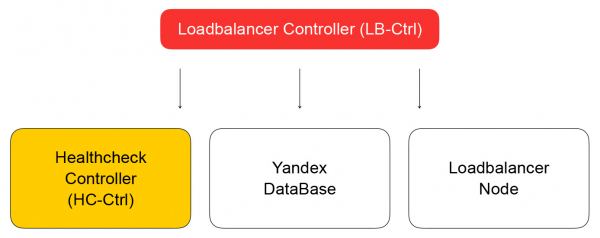
O serviço armazena seu estado no Yandex Database — um banco de dados gerenciado e distribuído, que em breve você também poderá utilizar. No Yandex.Cloud, como já mencionamos, é aplicada a conceito de dog food: se nós mesmos utilizamos nossos serviços, nossos clientes também irão aproveitá-los com prazer. O Yandex Database é um exemplo da realização desse conceito. Armazenamos todos os nossos dados no YDB, e não precisamos nos preocupar com a manutenção e escalabilidade do banco: esses problemas são resolvidos para nós, nós usamos o banco como um serviço.
Voltamos ao controlador de balanceamento. Sua tarefa é salvar informações sobre o balanceador, enviar a tarefa de verificação de prontidão da máquina virtual ao controlador de healthcheck.
Controlador de healthcheck
Ele recebe solicitações para alterar as regras de verificação, as salva no YDB, distribui as tarefas para os nodes de healthcheck e agrega os resultados, que são então salvos na base de dados e enviados ao controlador de balanceamento. Este, por sua vez, envia uma solicitação para alterar a composição do cluster no data plane para o loadbalancer-node, sobre o qual falarei a seguir.
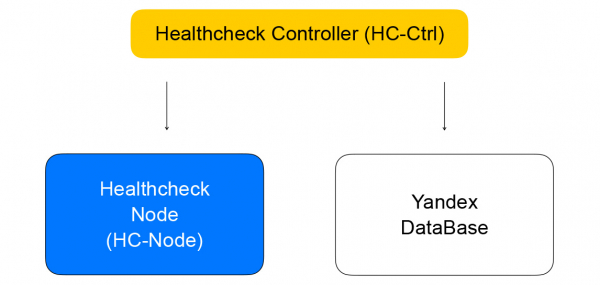
Vamos falar mais sobre as healthchecks. Elas podem ser divididas em várias classes. As verificações têm diferentes critérios de sucesso. As verificações TCP precisam estabelecer uma conexão com sucesso dentro de um tempo fixo. As verificações HTTP exigem tanto a conexão bem-sucedida quanto a obtenção de uma resposta com o código de status 200.
As verificações também diferem por classe de ação — podem ser ativas ou passivas. As verificações passivas apenas monitoram o que acontece com o tráfego, sem tomar nenhuma ação especial. Isso não funciona muito bem no L4, pois depende da lógica dos protocolos de níveis superiores: no L4 não há informações sobre quanto tempo a operação levou e se o fechamento da conexão foi bom ou ruim. As verificações ativas exigem que o balanceador envie solicitações para cada instância do servidor.
A maior parte dos balanceadores de carga realiza verificações de "ping" por conta própria. Nós, na Nuvem, decidimos separar essas partes do sistema para aumentar a escalabilidade. Essa abordagem nos permitirá aumentar o número de balanceadores, mantendo a quantidade de solicitações de healthcheck ao serviço. As verificações são realizadas por nodes de healthcheck separados, onde os alvos das verificações são shardados e replicados. Não podemos realizar verificações de um único host, pois ele pode falhar. Nesse caso, não obteremos o estado das instâncias validadas por ele. Realizamos verificações de qualquer uma das instâncias com pelo menos três nodes de healthcheck. Os alvos das verificações são shardados entre os nodes usando algoritmos de hash consistente.
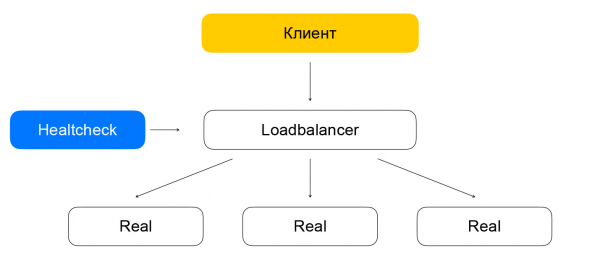
A separação entre balanceamento e healthcheck pode causar problemas. Se o healthcheck do nó faz solicitações para a instância, contornando o balanceador (que no momento não está lidando com o tráfego), surge uma situação curiosa: o recurso parece estar vivo, mas o tráfego não chega até ele. Resolvemos esse problema da seguinte maneira: garantimos que o tráfego de healthcheck passe pelos balanceadores. Em outras palavras, o esquema de movimentação de pacotes com tráfego de clientes e de healthchecks difere minimamente: em ambos os casos, os pacotes chegarão aos balanceadores, que os entregarão aos recursos alvo.
A diferença é que os clientes fazem solicitações ao VIP, enquanto os healthchecks se dirigem a cada RIP separado. Aqui surge um problema interessante: damos aos nossos usuários a possibilidade de criar recursos em redes IP cinzas. Vamos imaginar que há dois proprietários de nuvens diferentes, que esconderam seus serviços atrás de balanceadores. Cada um deles possui recursos na sub-rede 10.0.0.1/24, com endereços idênticos. Precisamos ser capazes de diferenciá-los de alguma forma, e aqui é necessário mergulhar na estrutura da rede virtual da Yandex.Cloud. Melhor saber os detalhes em , o que importa para nós agora é que a rede é multicamada e possui túneis que podem ser diferenciados pelo id da sub-rede.
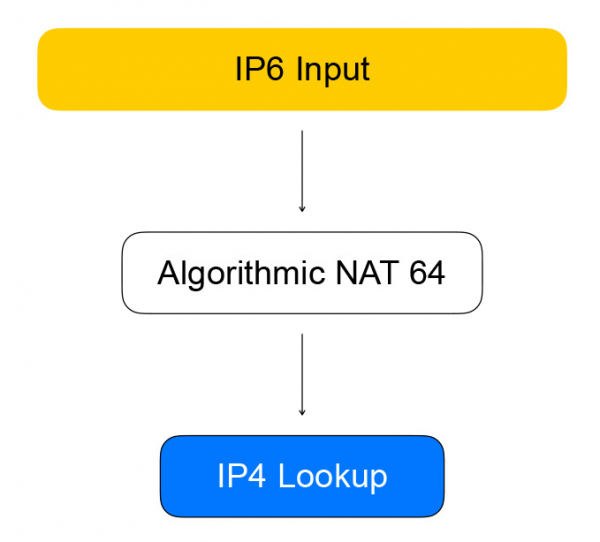
Os nós de healthcheck se conectam aos balanceadores usando chamados endereços quasi-IPv6. Um quasi-endereço é um endereço IPv6, dentro do qual está codificado um endereço IPv4 e o id da sub-rede do usuário. O tráfego chega ao balanceador, ele extrai o endereço IPv4 do recurso, substitui o IPv6 pelo IPv4 e envia o pacote para a rede do usuário.
O tráfego de retorno segue o mesmo caminho: o balanceador vê que o destino é uma rede cinza de healthcheckers e converte o IPv4 em IPv6.
VPP — o coração do data plane
O balanceador é implementado com a tecnologia Vector Packet Processing (VPP) — um framework da Cisco para processamento de pacotes de tráfego de rede. No nosso caso, o framework funciona sobre a biblioteca de gerenciamento de dispositivos de rede em espaço de usuário — Data Plane Development Kit (DPDK). Isso garante alta performance na processamento de pacotes: no núcleo, ocorrem muito menos interrupções, não há alternância de contexto entre kernel space e user space.
O VPP vai além e extrai ainda mais desempenho do sistema ao agrupar pacotes em lotes. O aumento de desempenho ocorre devido ao uso agressivo dos caches de processadores modernos. Tanto os caches de dados (os pacotes são processados "em vetores", com dados próximos uns dos outros) quanto os caches de instruções são utilizados: no VPP, o processamento de pacotes segue um gráfico cujos nós contêm funções que realizam uma única tarefa.
Por exemplo, o processamento de pacotes IP no VPP ocorre na seguinte ordem: primeiro, no nó de análise, há a análise dos cabeçalhos dos pacotes e, em seguida, eles são enviados para um nó que reencaminha os pacotes de acordo com as tabelas de roteamento.
Um pouco de hardcore. Os autores do VPP não fazem concessões no uso dos caches do processador, portanto, o código típico de processamento de vetores de pacotes contém vetorização manual: há um loop de processamento em que a situação "temos quatro pacotes na fila" é tratada, seguido do mesmo para dois e, em seguida, para um. Instruções de prefetch são frequentemente usadas para carregar dados nos caches a fim de acelerar o acesso a eles nas iterações seguintes.
n_left_from = frame->n_vectors;
while (n_left_from > 0)
{
    vlib_get_next_frame (vm, node, next_index, to_next, n_left_to_next);
    // ...
    while (n_left_from >= 4 && n_left_to_next >= 2)
    {
        // processando múltiplos pacotes ao mesmo tempo
        u32 next0 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        u32 next1 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        // ...
        /* Precarregar a próxima iteração. */
        {
            vlib_buffer_t *p2, *p3;

            p2 = vlib_get_buffer (vm, from[2]);
            p3 = vlib_get_buffer (vm, from[3]);

            vlib_prefetch_buffer_header (p2, LOAD);
            vlib_prefetch_buffer_header (p3, LOAD);

            CLIB_PREFETCH (p2->data, CLIB_CACHE_LINE_BYTES, STORE);
            CLIB_PREFETCH (p3->data, CLIB_CACHE_LINE_BYTES, STORE);
        }
        // realmente processar os dados
        /* verificar enfileiramentos especulativos, talvez mudar o próximo quadro atual */
        vlib_validate_buffer_enqueue_x2 (vm, node, next_index,
                to_next, n_left_to_next,
                bi0, bi1, next0, next1);
    }

    while (n_left_from > 0 && n_left_to_next > 0)
    {
        // processando pacotes um a um
    }

    // lote processado
    vlib_put_next_frame (vm, node, next_index, n_left_to_next);
}
Assim, os Healthchecks se conectam ao VPP via IPv6, que os converte para IPv4. Isso é realizado por um nó gráfico que chamamos de NAT algorítmico. Para o tráfego de retorno (e a conversão de IPv6 para IPv4), existe o mesmo nó de NAT algorítmico.
O tráfego direto dos clientes do balanceador passa pelos nós do gráfico que realizam o balanceamento em si.
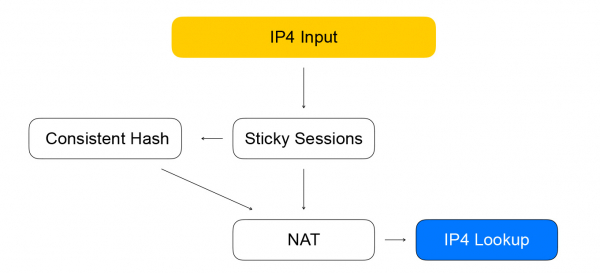
O primeiro nó — sessões persistentes. Ele armazena um hash do para sessões estabelecidas. O 5-tuple inclui o endereço e a porta do cliente, de onde a informação é transmitida, o endereço e as portas dos recursos disponíveis para a recepção de tráfego, bem como o protocolo de rede.
O hash do 5-tuple nos ajuda a realizar menos cálculos no nó subsequente de hashing consistente, além de lidar melhor com alterações na lista de recursos por trás do balanceador. Quando um pacote chega ao balanceador, para o qual não há sessão, ele é enviado para o nó de hashing consistente. É aqui que ocorre o balanceamento através do hashing consistente: escolhemos um recurso da lista de recursos 'vivos' disponíveis. Em seguida, os pacotes são enviados para o nó NAT, que realiza a substituição real do endereço de destino e reavalia os checksums. Como você pode ver, seguimos as regras do VPP — similar com similar, agrupando cálculos semelhantes para aumentar a eficiência dos caches do processador.
Hashing Consistente
Por que escolhemos exatamente isso e o que é isso, afinal? Primeiro, vamos considerar a tarefa anterior — selecionar um recurso de uma lista.
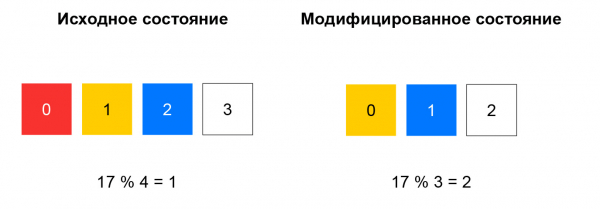
No hashing inconsistente, calcula-se o hash do pacote que entra, e o recurso é escolhido da lista com base no resto da divisão desse hash pelo número de recursos. Enquanto a lista permanecer inalterada, esse esquema funciona bem: sempre enviamos pacotes com o mesmo 5-tuple para a mesma instância. No entanto, se, por exemplo, algum recurso parar de responder aos healthchecks, a seleção mudará para uma parte significativa dos hashes. As conexões TCP do cliente se romperão: um pacote que anteriormente ia para a instância A pode começar a ir para a instância B, que não está familiarizada com a sessão para esse pacote.
O hashing consistente resolve o problema descrito. A maneira mais simples de explicar esse conceito é imaginar que você tem um anel, no qual distribui recursos com base no hash (por exemplo, por IP:porta). A escolha do recurso é a rotação da roda em um ângulo determinado pelo hash do pacote.
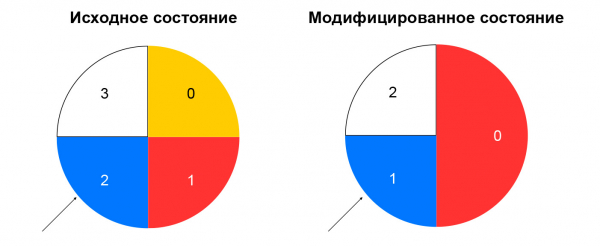
Dessa forma, minimiza-se a redistribuição de tráfego ao alterar a composição dos recursos. A remoção de um recurso afetará apenas a parte do anel de hashing consistente onde esse recurso estava localizado. A adição de um recurso também altera a distribuição, mas temos um nó de sessões sticky, que permite não alterar sessões já estabelecidas para novos recursos.
Analisamos o que acontece com o tráfego direto entre o balanceador e os recursos. Agora vamos entender o tráfego reverso. Ele segue o mesmo padrão que o tráfego de healthchecks — através de NAT algorítmico, ou seja, através de NAT 44 para o tráfego do cliente e NAT 46 para o tráfego de healthchecks. Mantemos nosso próprio esquema: unificamos o tráfego de healthchecks e o tráfego real dos usuários.
Node balanceador e componentes em conjunto
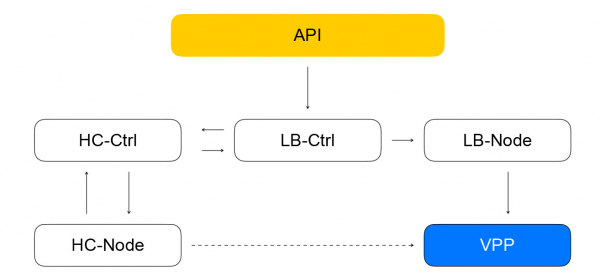
A composição dos balanceadores e recursos no VPP é reportada pelo serviço local — loadbalancer-node. Ele se inscreve para receber uma corrente de eventos do loadbalancer-controller, é capaz de construir a diferença entre o estado atual do VPP e o estado alvo recebido do controlador. Obtemos um sistema fechado: eventos da API chegam ao controlador do balanceador, que atribui tarefas ao controlador de healthchecks para verificar a ‘vitalidade’ dos recursos. Esse, por sua vez, atribui tarefas ao healthcheck-node e agrega os resultados, que são posteriormente enviados de volta ao controlador dos balanceadores. O loadbalancer-node se inscreve para eventos do controlador e altera o estado do VPP. Em tal sistema, cada serviço conhece apenas o necessário sobre os serviços vizinhos. O número de conexões é limitado, e temos a capacidade de operar e escalar independentemente diferentes segmentos.
Questões que conseguimos evitar
Todos os nossos serviços no plano de controle são escritos em Go e apresentam boas características de escalabilidade e confiabilidade. Em Go, há muitas bibliotecas open source para construção de sistemas distribuídos. Usamos ativamente GRPC, todos os componentes contêm uma implementação open source de descoberta de serviços — nossos serviços monitoram a funcionalidade uns dos outros, podem mudar sua composição dinamicamente, e conectamos isso com o balanceamento GRPC. Para métricas, também utilizamos uma solução open source. No plano de dados, obtivemos um desempenho satisfatório e grande reserva de recursos: não foi fácil montar um estande onde pudéssemos atingir o desempenho do VPP e não da placa de rede física.
Problemas e soluções
O que não funcionou muito bem? No Go, a gestão de memória é automática, mas vazamentos de memória ainda acontecem. A maneira mais simples de lidar com eles é executar goroutines e não se esquecer de finalizá-las. Conclusão: fique atento ao consumo de memória dos programas em Go. Um bom indicador costuma ser o número de goroutines. Há um lado positivo nesta história: é fácil obter dados de runtime em Go — sobre o consumo de memória, a quantidade de goroutines em execução e muitos outros parâmetros.
Além disso, Go pode não ser a melhor escolha para testes funcionais. Eles são bastante verbosos e a abordagem padrão de "executar tudo em CI em massa" não se aplica bem a eles. O fato é que os testes funcionais são mais exigentes em recursos, e enfrentam verdadeiros timeouts. Por causa disso, os testes podem falhar, pois o CPU está ocupado com os testes unitários. Conclusão: sempre que possível, execute os testes "pesados" separadamente dos testes unitários.
A arquitetura de eventos de microsserviços é mais complexa do que a de um monólito: pesquisar logs em dezenas de máquinas diferentes não é muito confortável. Conclusão: se você estiver fazendo microsserviços, pense imediatamente em rastreamento.
Nossos planos
Vamos lançar um balanceador interno, um balanceador IPv6, adicionar suporte a cenários Kubernetes, continuar shardizando nossos serviços (atualmente, apenas healthcheck-node e healthcheck-ctrl estão shardizados), adicionar novos healthchecks, além de implementar uma agregação inteligente de verificações. Estamos avaliando a possibilidade de tornar nossos serviços ainda mais independentes — para que eles se comuniquem não diretamente entre si, mas por meio de uma fila de mensagens. Recentemente, surgiu na Nuvem um serviço compatível com SQS. .
Recentemente, foi lançado publicamente o Yandex Load Balancer. Conheça o serviço, gerencie balanceadores de forma conveniente para você e aumente a resiliência dos seus projetos!
Fonte: habr.com
