

Introdução aos sistemas operacionais
Olá, Habr! Quero apresentar a vocês uma série de artigos traduzidos de uma literatura que considero interessante — OSTEP. Este material explora a fundo o funcionamento dos sistemas operacionais semelhantes ao Unix, particularmente — o trabalho com processos, vários escalonadores, memória e outros componentes que compõem um sistema operacional moderno. Você pode olhar o original de todo o material aqui . Peço que considerem que a tradução foi feita de forma não profissional (de maneira bastante livre), mas espero ter mantido o sentido geral.
Os trabalhos de laboratório sobre este assunto podem ser encontrados aqui:
Partes adicionais:
E você também pode acessar meu canal em =)
Introdução ao planejador
A essência do problema: Como desenvolver uma política de planejador
Como devem ser desenvolvidos os frameworks básicos de políticas do planejador? Quais devem ser as suposições-chave? Quais métricas são importantes? Quais técnicas básicas foram usadas em sistemas computacionais anteriores?
Suposições sobre a carga de trabalho
Antes de discutir possíveis políticas, vamos fazer algumas simplificações sobre os processos executados no sistema, que juntos são chamados de carga de trabalho. Definir a carga de trabalho como uma parte crítica na construção de políticas e quanto mais você souber sobre a carga, melhor será a política que você pode escrever.
Vamos fazer as seguintes suposições sobre os processos executados no sistema, que às vezes também são chamados de jobs (tarefas). Praticamente todas essas suposições não são realistas, mas são necessárias para desenvolver o raciocínio.
- Cada tarefa é executada pelo mesmo período de tempo,
- Todas as tarefas são iniciadas simultaneamente,
- A tarefa iniciada executa até sua conclusão,
- Todas as tarefas utilizam apenas a CPU,
- O tempo de execução de cada tarefa é conhecido.
Métricas do Planejador
Além de algumas suposições sobre a carga, também é necessário um certo instrumento de comparação de várias políticas de planejamento: as métricas do planejador. Métricas são apenas alguma medida de algo. Existe uma quantidade de métricas que podem ser usadas para comparar planejadores.
Por exemplo, vamos usar uma métrica chamada tempo de retorno (turnaround time). O tempo de retorno de uma tarefa é definido como a diferença entre o tempo de conclusão da tarefa e o tempo de chegada da tarefa ao sistema.
Tturnaround=Tcompletion−Tarrival
Como supomos que todas as tarefas chegaram ao mesmo tempo, então Ta=0 e assim Tt=Tc. Este valor naturalmente mudará quando alterarmos as suposições listadas acima.
Outra métrica é a justiça (fairness). Desempenho e justiça muitas vezes são características opostas no planejamento. Por exemplo, o planejador pode otimizar o desempenho, mas à custa da espera para que outras tarefas sejam iniciadas, diminuindo assim a justiça.
FIRST IN FIRST OUT (FIFO)
O algoritmo mais básico que podemos implementar chama-se FIFO ou primeiro a chegar, primeiro a ser atendido. Este algoritmo possui várias vantagens: é muito simples de implementar e atende a todas as nossas suposições, realizando o trabalho de forma bastante eficaz.
Vamos considerar um exemplo simples. Suponha que 3 tarefas foram designadas ao mesmo tempo. Mas imagine que a tarefa A chegou um pouco antes das demais, portanto ela estará no início da lista de execução, assim como a tarefa B em relação à tarefa C. Suponha que cada uma delas será executada por 10 segundos. Qual seria, nesse caso, o tempo médio de execução dessas tarefas?
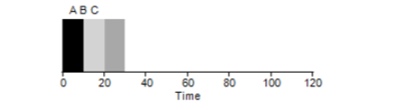
Calculando os valores — 10+20+30 e dividindo por 3, obtemos o tempo médio de execução do programa igual a 20 segundos.
Agora vamos tentar mudar nossas suposições. Em particular, a suposição 1, e assim não vamos mais considerar que cada tarefa leva o mesmo tempo para ser executada. Como se comportará o FIFO desta vez?
Como se vê, diferentes tempos de execução das tarefas afetam negativamente a produtividade do algoritmo FIFO. Suponha que a tarefa A será executada por 100 segundos, enquanto B e C ainda levarão 10 segundos cada.
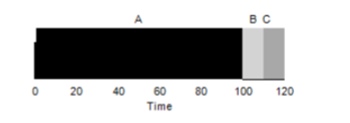
Como pode ser observado na figura, o tempo médio para o sistema será (100+110+120)/3=110. Esse efeito é chamado de efeito de comboio, quando alguns consumidores de curto prazo de um recurso ficam na fila atrás de um consumidor pesado. Isso é semelhante a uma fila no supermercado, onde um cliente à sua frente possui um carrinho cheio. A melhor solução para o problema é tentar mudar de caixa ou relaxar e respirar fundo.
Shortest Job First
É possível resolver essa situação com processos pesados? Claro. Outro tipo de escalonamento é chamadoShortest Job First (SJF). Seu algoritmo também é bastante primitivo — como o nome indica, as tarefas mais curtas serão executadas primeiro, uma após a outra.
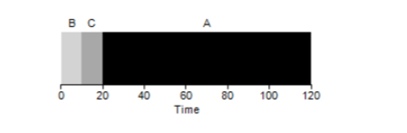
Neste exemplo, o resultado da execução dos mesmos processos será a melhora do tempo médio de retorno dos programas, que será igual a 50 em vez de 110, que é praticamente 2 vezes melhor.
Assim, de acordo com a suposição de que todas as tarefas chegam ao mesmo tempo, o algoritmo SJF parece ser o mais otimizado. No entanto, nossas suposições ainda não parecem realistas. Desta vez, mudaremos a suposição 2 e consideraremos que as tarefas podem chegar a qualquer momento, e não todas ao mesmo tempo. Quais problemas isso pode causar?
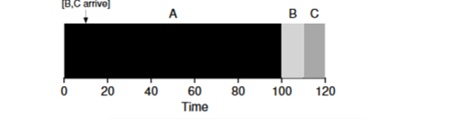
Vamos supor que a tarefa A (100s) chega primeiro e começa a ser executada. No momento t=10, as tarefas B e C chegam, cada uma delas consumindo 10 segundos. Assim, o tempo médio de execução é (100+(110-10)+(120-10))/3 = 103. O que o escalonador poderia fazer para melhorar a situação?
Shortest Time-to-Completion First (STCF)
Para melhorar a situação, vamos ignorar a suposição 3 de que o programa é iniciado e executado até a conclusão. Além disso, precisamos de suporte de hardware e, como você pode imaginar, usaremos um temporizador para interromper a tarefa em execução e mudar contextos. Assim, o escalonador pode agir no momento em que as tarefas B e C chegam — interromper a execução da tarefa A e começar a processar as tarefas B e C e, após sua conclusão, retomar a execução do processo A. Esse tipo de escalonador é chamado de STCFou Preemptive Job First.
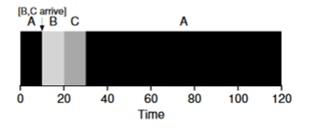
O resultado do trabalho desse escalonador será: ((120-0)+(20-10)+(30-10))/3=50. Portanto, esse escalonador se torna ainda mais otimizado para nossas tarefas.
Métrica do Tempo de Resposta (Response Time)
Portanto, se soubermos o tempo de execução das tarefas e que essas tarefas usam apenas CPU, o STCF será a melhor solução. Em tempos antigos, esses algoritmos funcionavam e até que muito bem. No entanto, agora o usuário passa a maior parte do tempo no terminal e espera dela uma interação produtiva e interativa. Assim surgiu uma nova métrica — o tempo de resposta (response).
O tempo de resposta é calculado da seguinte forma:
Tresponse=Tfirstrun−Tarrival
Assim, para o exemplo anterior, o tempo de resposta será: A=0, B=0, C=10 (abg=3,33).
E o algoritmo STCF não é tão eficiente em situações em que 3 tarefas chegam ao mesmo tempo — ele terá que esperar até que as pequenas tarefas sejam concluídas. Assim, o algoritmo é bom para a métrica de tempo de resposta, mas ruim para a métrica de interatividade. Imagine que, ao usar um terminal na tentativa de digitar caracteres em um editor, você precisasse esperar mais de 10 segundos porque uma outra tarefa estava ocupando o processador. Isso não é nada agradável.
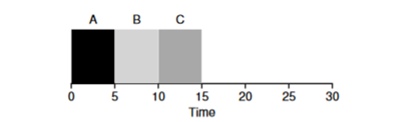
Portanto, enfrentamos outro problema — como podemos construir um escalonador que seja sensível ao tempo de resposta?
Round Robin
Para resolver esse problema, foi desenvolvido o algoritmo Round Robin (RR). A ideia principal é bastante simples: em vez de executar as tarefas até sua conclusão, vamos executar uma tarefa por um determinado intervalo de tempo (chamado de quântico de tempo) e, em seguida, trocar para outra tarefa na fila. O algoritmo repete esse processo até que todas as tarefas sejam concluídas. Nesse caso, o tempo de execução do programa deve ser um múltiplo do tempo em que o timer interrompe o processo. Por exemplo, se o timer interrompe o processo a cada x=10ms, o tamanho da janela de execução do processo deve ser um múltiplo de 10 e ser 10, 20 ou x*10.
Vamos considerar um exemplo: as tarefas ABC chegam simultaneamente ao sistema e cada uma delas deseja executar por 5 segundos. O algoritmo SJF executará cada tarefa até o fim antes de iniciar outra. Em contraste, o algoritmo RR com janela de execução = 1s passará pelas tarefas da seguinte maneira (fig. 4.3):
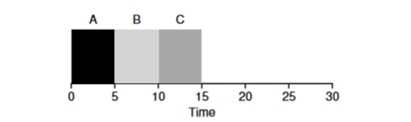
(SJF novamente (ruim para o tempo de resposta)
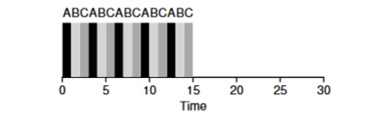
(Round Robin (bom para o tempo de resposta)
O tempo médio de resposta para o algoritmo RR (0+1+2)/3=1, enquanto para SJF (0+5+10)/3=5.
É lógico supor que a janela de tempo é um parâmetro muito importante para o RR, quanto menor ela for, maior será o tempo de resposta. No entanto, não se deve torná-la excessivamente pequena, pois o tempo de troca de contexto também desempenha um papel na performance geral. Assim, a escolha do tempo de janela de execução é definida pelo arquiteto do sistema operacional e depende das tarefas que estão previstas para serem executadas. A troca de contexto não é a única operação de serviço que consome tempo — o programa em execução opera com muitos outros aspectos, como diferentes caches, e a cada troca é necessário salvar e restaurar esse ambiente, o que também pode demandar bastante tempo.
O RR é um excelente planejador, se estivermos falando apenas sobre a métrica do tempo de resposta. Mas como se comportará a métrica do tempo de retorno da tarefa com esse algoritmo? Vamos considerar o exemplo acima, quando os tempos de execução A, B, C = 5s e chegam ao mesmo tempo. A tarefa A será concluída em 13s, B em 14s, C em 15s, resultando em um tempo médio de retorno de 14s. Assim, o RR é o pior algoritmo para a métrica de retorno.
De maneira mais geral, qualquer algoritmo do tipo RR é justo, pois divide o tempo de processamento no CPU igualmente entre todos os processos. E, assim, essas métricas estão em constante conflito entre si.
Portanto, temos vários algoritmos opostos e ainda restam algumas suposições — de que o tempo da tarefa é conhecido e que a tarefa utiliza apenas o CPU.
Mistura com I/O
Em primeiro lugar, vamos remover a suposição 4, de que o processo apenas utiliza o CPU, o que, naturalmente, não é verdade, pois os processos podem interagir com outros equipamentos.
No momento em que um processo solicita uma operação de entrada e saída, ele passa para o estado bloqueado, aguardando a conclusão do I/O. Se o I/O é enviado para o disco rígido, essa operação pode levar vários milissegundos ou mais, e o processador ficará ocioso nesse momento. Nesse tempo, o planejador pode alocar o processador para qualquer outro processo. A próxima decisão que o planejador terá que tomar é quando o processo concluir seu I/O. Quando isso ocorrer, haverá uma interrupção e o sistema operacional mudará o processo que solicitou o I/O para o estado pronto.
Vamos considerar um exemplo de várias tarefas. Cada uma delas precisa de 50 ms de tempo de processador. No entanto, a primeira irá acessar I/O a cada 10 ms (que também será executado a cada 10 ms). E o processo B simplesmente utiliza 50 ms de processador sem I/O.
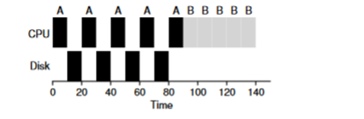
Neste exemplo, usaremos o planejador STCF. Como o planejador se comportará se iniciarmos um processo como A? Ele fará o seguinte — primeiro completará totalmente o processo A, e depois o processo B.
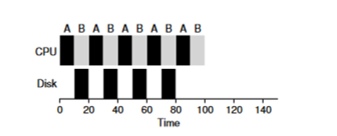
A abordagem tradicional para resolver esse problema é interpretar cada subtarefa de 10 ms do processo A como uma tarefa separada. Assim, ao iniciar com o algoritmo STJF, a escolha entre a tarefa de 50 ms e a de 10 ms é óbvia. Então, quando a subtarefa A terminar, o processo B e I/O serão iniciados. Após a conclusão do I/O, será decidido reiniciar o processo de 10 ms A em vez do processo B. Dessa forma, é possível implementar sobreposição, onde a CPU é utilizada por outro processo enquanto o primeiro aguarda I/O. Como resultado, o sistema é melhor utilizado — no momento em que processos interativos aguardam I/O, outros processos podem ser executados na CPU.
O Oráculo não existe mais.
Agora tentaremos nos livrar da suposição de que o tempo de execução da tarefa é conhecido. Essa suposição é, em geral, a mais errada e irrealista de toda a lista. Na verdade, em sistemas operacionais comuns, o próprio SO geralmente sabe muito pouco sobre o tempo de execução das tarefas, como podemos então construir um planejador sem saber quanto tempo a tarefa levará? Talvez pudéssemos usar alguns princípios de RR para resolver esse problema?
Resultado
Examinamos as ideias básicas de escalonamento de tarefas e revisamos dois grupos de planejadores. O primeiro inicia a tarefa mais curta primeiro, melhorando assim o tempo de retorno, enquanto o segundo se divide igualmente entre todas as tarefas, melhorando o tempo de resposta. Ambos os algoritmos são ruins onde os algoritmos do outro grupo são bons. Também examinamos como o uso paralelo de CPU e I/O pode melhorar o desempenho, mas ainda não resolvemos o problema da previsão do SO. E na próxima aula, veremos um planejador que observa o passado recente e tenta prever o futuro. Ele se chama fila de feedback multi-nível.
Fonte: habr.com
