

Se uma base de dados de séries temporais (timeseries db, ) for usada como o armazenamento principal para um site de estatísticas, em vez de resolver o problema, pode-se acabar com muitas dores de cabeça. Estou trabalhando em um projeto que utiliza essa base, e às vezes o InfluxDB, do qual falaremos, traz surpresas completamente inesperadas.
Aviso Legal: os problemas mencionados referem-se à versão InfluxDB 1.7.4.
Por que séries temporais?
O projeto consiste em rastrear transações em diversas blockchains e exibir estatísticas. Especificamente, estamos observando a emissão e a queima de stablecoins (). Com base nessas transações, gráficos precisam ser construídos e tabelas resumidas mostradas.
Ao analisar as transações, surgiu a ideia: usar a base de dados de séries temporais InfluxDB como o armazenamento principal. As transações são pontos no tempo e se encaixam bem no modelo de série temporal.
Além disso, as funções de agregação pareceram muito convenientes — para processar gráficos com longos períodos de tempo, são perfeitamente adequadas. O usuário precisa de um gráfico de um ano, mas a base contém um conjunto de dados com um intervalo de cinco minutos. Enviar todas as cem mil pontos não faz sentido — além do longo processamento, elas não caberiam na tela. É possível escrever uma implementação própria de aumento de intervalo, ou usar as funções de agregação integradas do Influx. Com elas, é possível agrupar os dados por dias e enviar os 365 pontos necessários.
O que me incomodou um pouco é que geralmente essas bases são usadas para coletar métricas. Monitoramento de servidores, dispositivos IoT, tudo a partir do qual ‘estão fluindo’ milhões de pontos do tipo: [<tempo> — <valor da métrica>]. Mas se a base funciona bem com um grande fluxo de dados, por que um volume pequeno deve causar problemas? Com esse pensamento, começamos a trabalhar com o InfluxDB.
O que mais é conveniente no InfluxDB
Além das mencionado funções de agregação, há mais uma coisa maravilhosa — consultas contínuas (). Este é um planejador integrado na base de dados que pode processar dados de acordo com um cronograma. Por exemplo, é possível agrupar todos os registros de um dia a cada 24 horas, calcular a média e gravar um novo ponto em outra tabela sem escrever soluções próprias.
Há também uma políticas de retenção () — configuração para exclusão de dados após um determinado período. Útil, por exemplo, quando é necessário armazenar a carga da CPU por uma semana com medições a cada segundo, mas essa precisão não é necessária ao longo de meses. Nessa situação, é possível fazer assim:
- criar uma consulta contínua para agregar dados em outra tabela;
- para a primeira tabela, definir a política de exclusão de métricas que são mais antigas do que a semana mencionada.
E o Influx irá diminuir automaticamente o tamanho dos dados e excluir o que não é necessário.
Sobre os dados armazenados
Não há muitos dados armazenados: cerca de 70 mil transações e mais de um milhão de pontos com informações de mercado. A adição de novos registros não excede 3000 pontos por dia. Também existem métricas sobre o site, mas há poucos dados e, de acordo com a política de retenção, eles são armazenados por no máximo um mês.
Problemas
Durante o desenvolvimento e posterior teste do serviço, surgiram problemas cada vez mais críticos durante a operação do InfluxDB.
1. Exclusão de dados
Há uma série de dados com transações:
SELECT time, amount, block, symbol FROM transactions WHERE symbol='USDT'Resultado:
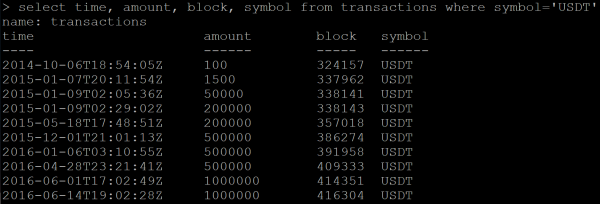
Envio o comando para excluir dados:
DELETE FROM transactions WHERE symbol='USDT'Depois, faço uma consulta para obter os dados já excluídos. E o Influx, em vez de uma resposta vazia, retorna parte dos dados que deveriam ter sido excluídos.
Tento excluir a tabela inteira:
DROP MEASUREMENT transactionsVerifico a exclusão da tabela:
SHOW MEASUREMENTSNão vejo a tabela na lista, mas uma nova consulta de dados ainda retorna o mesmo conjunto de transações.
O problema ocorreu apenas uma vez, pois o caso de exclusão é uma ocorrência isolada. Mas esse comportamento do banco claramente não se encaixa na definição de operação 'correta'. Mais tarde no GitHub, encontrei um de quase um ano sobre esse assunto.
Como resultado, a exclusão e posterior restauração de todo o banco ajudou.
2. Números de ponto flutuante
Cálculos matemáticos usando funções integradas no InfluxDB apresentam erros de precisão. Não é que isso seja algo incomum, mas é desagradável.
No meu caso, os dados têm um componente financeiro e seria desejável processá-los com alta precisão. Por causa disso, planejo abrir mão das consultas contínuas.
3. Consultas contínuas não podem ser adaptadas a diferentes fusos horários.
O serviço possui uma tabela com estatísticas diárias de transações. Para cada dia, é necessário agrupar todas as transações daquele dia. No entanto, o dia de cada usuário começará em horários diferentes, resultando em diferentes conjuntos de transações. De acordo com o UTC, existem de deslocamento, para as quais os dados precisam ser agregados.
No InfluxDB, ao agrupar por tempo, é possível especificar um deslocamento adicional, por exemplo, para o horário de Moscovo (UTC+3):
SELECT MEAN("supply") FROM transactions GROUP BY symbol, time(1d, 3h) fill(previous)Mas o resultado da consulta será incorreto. Por algum motivo, os dados agrupados por dia começarão no ano de 1677 (o InfluxDB oficialmente suporta o intervalo de tempo a partir desse ano):
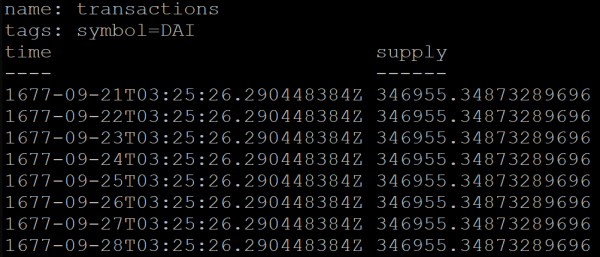
Para contornar esse problema, o serviço foi temporariamente alterado para UTC+0.
4. Desempenho
Na internet, existem muitos benchmarks comparando o InfluxDB e outros bancos de dados. Na primeira análise, pareceram materiais de marketing, mas agora acredito que há uma parte de verdade neles.
Vou compartilhar meu caso.
O serviço fornece um método de API que retorna estatísticas das últimas 24 horas. Durante os cálculos, o método faz três solicitações ao banco de dados com as seguintes consultas:
SELECT * FROM coins_info WHERE time <= NOW() GROUP BY symbol ORDER BY time DESC LIMIT 1SELECT * FROM dominance_info ORDER BY time DESC LIMIT 1SELECT * FROM transactions WHERE time >= NOW() - 24h ORDER BY time DESCExplicação:
- Na primeira consulta, obtemos os últimos pontos para cada moeda com os dados do mercado. Oito pontos para oito moedas, no meu caso.
- A segunda consulta obtém o único ponto mais recente.
- A terceira solicita a lista de transações das últimas 24 horas, que podem ser várias centenas.
Esclareço que no InfluxDB, índices são automaticamente criados por tags e por tempo, acelerando as consultas. Na primeira consulta, symbol é uma tag.
Realizei um teste de estresse para esse método de API. Para 25 RPS, o servidor demonstrou carga total em seis CPUs:
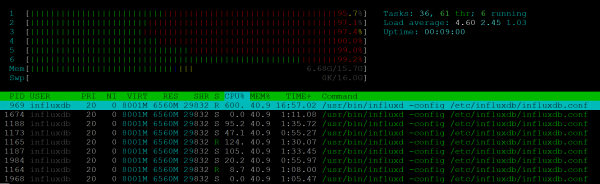
Enquanto isso, o processo NodeJs não gerou carga alguma.
A velocidade de execução já começou a degradar após 7-10 RPS: se um cliente poderia receber uma resposta em 200 ms, dez clientes precisavam esperar cerca de um segundo. 25 RPS é o limite em que a estabilidade sofreu, e os clientes recebiam erros 500.
Com esse desempenho, usar Influx em nosso projeto é impossível. Além disso: em um projeto onde o monitoramento precisa ser exibido para muitos clientes, podem surgir problemas semelhantes, e o servidor de métricas ficará sobrecarregado.
Saída
A principal conclusão da experiência obtida é que não se deve usar uma tecnologia desconhecida em um projeto sem uma análise adequada. Uma simples triagem de tickets abertos no GitHub poderia ter fornecido informações para evitar a escolha do InfluxDB como armazenador de dados principal.
O InfluxDB parecia adequado para as necessidades do meu projeto, mas, na prática, este banco de dados não atende às demandas e apresenta muitos problemas.
No repositório do projeto, já é possível encontrar a versão 2.0.0-beta, e resta-nos esperar que a segunda versão traga melhorias significativas. Enquanto isso, vou estudar a documentação do TimescaleDB.
Fonte: habr.com
