

Engenheiro — em latim — inspirado.
O engenheiro pode tudo. (c) R.Diesel.
Epígrafes.
Ou a história sobre por que o administrador de banco de dados deve lembrar de seu passado como programador.
Prefácio
Todos os nomes foram alterados. Qualquer semelhança é mera coincidência. O material representa exclusivamente a opinião pessoal do autor.
Isenção de garantias: no planejado ciclo de artigos não haverá descrição detalhada e precisa das tabelas e scripts utilizados. Os materiais não podem ser usados imediatamente "AS IS".
Primeiro, devido ao grande volume do material,
em segundo lugar, devido à adequação com a base de produção do cliente real.
Portanto, nos artigos serão apresentados apenas ideias e descrições de forma geral.
Talvez no futuro o sistema evolua para o nível de publicação no GitHub, ou talvez não. O tempo dirá.
O início da história — "».
O que resultou, de maneira geral — "»
Por que tudo isso para mim?
Bem, primeiro, para não esquecer, relembrando na aposentadoria os gloriosos dias.
Em segundo lugar, para sistematizar o que foi escrito. Porque já, às vezes, começo a me confundir e esquecer partes específicas.
E o mais importante — talvez isso possa ser útil para alguém e ajudar a não reinventar a roda e não pisar em um garfo. Em outras palavras, melhorar seu karma (não o de Habr). Porque a coisa mais valiosa neste mundo são as ideias. O principal é encontrar a ideia. E realizar a ideia na realidade já é uma questão puramente técnica.
Então, vamos começar, devagar...
Definição do problema.
Temos:
Banco de dados PostgreSQL (10.5), de carga mista (OLTP+DSS), de média-baixa carga, situado na nuvem AWS.
A monitorização do banco de dados está ausente, a monitorização da infraestrutura é feita por meio dos recursos padrão da AWS na configuração mínima.
É necessário:
Monitorar o desempenho e o estado do banco de dados, encontrar e ter informações iniciais para otimizar consultas pesadas ao BD.
Uma breve introdução ou análise das opções de solução
Para começar, vamos tentar analisar as opções de solução do problema do ponto de vista de uma análise comparativa de benefícios e inconvenientes para o engenheiro, enquanto os benefícios e prejuízos da gestão ficam a cargo de quem é responsável de acordo com os quadros.
Opção 1 — "Trabalhando sob demanda"
Deixamos tudo como está. Se o cliente não estiver satisfeito com algo na funcionalidade, desempenho do banco de dados ou do aplicativo, ele informará os engenheiros de DBA por e-mail ou criando um incidente no sistema de tickets.
O engenheiro, ao receber a notificação, vai analisar o problema, sugerir uma solução ou adiar a questão, esperando que tudo se resolva por si só, e de qualquer forma, tudo logo será esquecido.
Biscoitos e pãezinhos, hematomas e inchaçosBiscoitos e pãezinhos:
1. Não é necessário fazer nada em excesso
2. Sempre há uma oportunidade de se esquivar e relaxar.
3. Um monte de tempo que pode ser gastado à vontade.
Hematomas e inchaços:
1. Mais cedo ou mais tarde, o cliente refletirá sobre a essência da existência e a justiça universal neste mundo e mais uma vez se perguntará - por que estou pagando por isso? A consequência é sempre a mesma — a única questão é quando o cliente ficará entediado e se despedirá. E a alimentação se esvaziará. Isso é triste.
2. Desenvolvimento do engenheiro — zero.
3. Dificuldades no planejamento do trabalho e carga de serviço
Opção 2 - 'Dançamos com tambores, vendemos e calçamos'
Ponto 1-Por que precisamos de um sistema de monitoramento? Vamos receber tudo através de solicitações. Executamos um monte de solicitações para o dicionário de dados e visualizações dinâmicas, ativamos vários contadores, reunimos tudo em tabelas, periodicamente analisamos listas e tabelas. No resultado, temos gráficos bonitos ou nem tão bonitos, tabelas, relatórios. O principal é ter mais, mais.
Ponto 2-Geramos atividade — iniciamos a análise de tudo isso.
Ponto 3-Preparar um documento, que chamamos simplesmente de — 'como organizar nosso banco de dados'.
Ponto 4-O cliente, ao ver toda essa maravilha de gráficos e números, fica numa ingenuidade infantil acreditando — agora sim, tudo vai funcionar em breve. E, de forma fácil e indolor, se despede de seus recursos financeiros. A gestão também está confiante — os engenheiros estão trabalhando duro. Carga no máximo.
Ponto 5-Repetir regularmente o Ponto 1.
Biscoitos e pãezinhos, hematomas e inchaçosBiscoitos e pãezinhos:
1. A vida dos gerentes e engenheiros é simples, previsível e cheia de atividades. Tudo zumbindo, todos ocupados.
2. A vida do cliente também não é ruim — ele sempre acredita que precisa apenas esperar um pouco e tudo se resolverá. Não se resolve, bem, o que fazer — o mundo é injusto, na próxima vida — terá sorte.
Hematomas e inchaços:
1. Tarde ou cedo, surgirá um fornecedor mais ágil oferecendo o mesmo serviço, mas um pouco mais barato. E se o resultado for o mesmo, por que pagar mais? Isso, novamente, levará ao desaparecimento da fonte de renda.
2. Isto é entediante. Assim como qualquer atividade sem sentido.
3. Assim como na opção anterior, não há desenvolvimento algum. Mas para o engenheiro, a desvantagem é que, ao contrário da primeira opção, aqui é necessário gerar constantemente a Base de Dados de Inventário. E isso consome tempo, que poderia ser usado para o próprio benefício. Afinal, se você não cuidar de si mesmo, ninguém se importará com você.
Opção 3 - Não é preciso reinventar a roda, é preciso comprá-la e utilizar.
Engenheiros de outras empresas não comem pizza com cerveja à toa (ah, os gloriosos tempos de São Petersburgo nos anos 90). Vamos usar sistemas de monitoramento que já foram desenvolvidos, ajustados e que funcionam, e que, na verdade, trazem benefícios (pelo menos para seus criadores).
Biscoitos e pãezinhos, hematomas e inchaçosBiscoitos e pãezinhos:
1. Não é preciso perder tempo inventando o que já foi inventado. Pegue e use.
2. Sistemas de monitoramento não são feitos por tolos e, com certeza, são úteis.
3. Sistemas de monitoramento que estão em funcionamento geralmente oferecem informações úteis e filtradas.
Hematomas e inchaços:
1. O engenheiro, nesse caso, não é um engenheiro, mas apenas um usuário de um produto alheio. Ou um usuário.
2. É preciso convencer o cliente da necessidade de comprar algo que, na verdade, ele não quer entender, nem deve, e o orçamento do ano já está aprovado e não vai mudar. Depois, é necessário alocar um recurso separado e ajustar para um sistema específico. Ou seja, primeiro terá que pagar, pagar e pagar de novo. E o cliente é avarento. Essa é a norma da vida.
O que fazer - Turgenev? Sua pergunta é bastante pertinente. (c)
Nessa situação específica, é possível agir de uma forma ligeiramente diferente - vamos fazer nosso próprio sistema de monitoramento.
Embora não um sistema exatamente, no sentido completo da palavra, isso seria um tanto exagerado e presunçoso, mas ao menos será uma forma de facilitar nossa tarefa e coletar mais informações para resolver incidentes de desempenho. Para não nos encontrarmos na situação - "vá para onde você não sabe, encontre o que não sabe".
Quais são os prós e contras dessa opção:
Acesso direto aos sistemas de cabos transpacíficos. Ping mínimo para a China, Japão, Austrália e costa oeste dos EUA.
1. Isso é interessante. Pelo menos é mais interessante do que as constantes "shrink datafile, alter tablespace, etc."
2. Estas são novas habilidades e um novo desenvolvimento. O que, a longo prazo, dará as recompensas merecidas.
Pontos negativos:
1. Será necessário trabalhar. Trabalhar muito.
2. Será necessário explicar regularmente o sentido e as perspectivas de toda a atividade.
3. Será preciso abrir mão de algo, já que o único recurso disponível para o engenheiro — o tempo — é limitado pelo Universo.
4. O mais assustador e desagradável — é que no final pode resultar em algo como 'Nem um ratinho, nem um sapo, mas uma criatura desconhecida'.
Quem não arrisca, não toma champanhe.
Assim — começa a parte mais interessante.
A ideia geral — esquematicamente
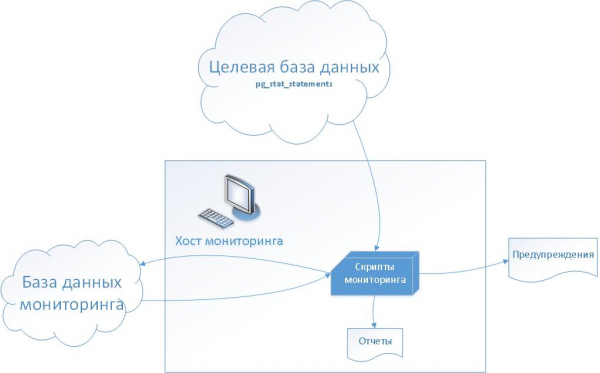
(A ilustração foi retirada de um artigo «»)
Explicação:
- Na base de dados alvo, é instalado a extensão padrão do PostgreSQL — “pg_stat_statements”.
- Na base de dados de monitoramento, criamos um conjunto de tabelas de serviço para armazenar a história do pg_stat_statements na etapa inicial e para configurar métricas e monitoramento posteriormente.
- No host de monitoramento, criamos um conjunto de scripts bash, incluindo para geração de incidentes no sistema de tickets.
Tabelas de serviço
Para começar, um ERD esquemático simplificado, o que conseguimos no final:
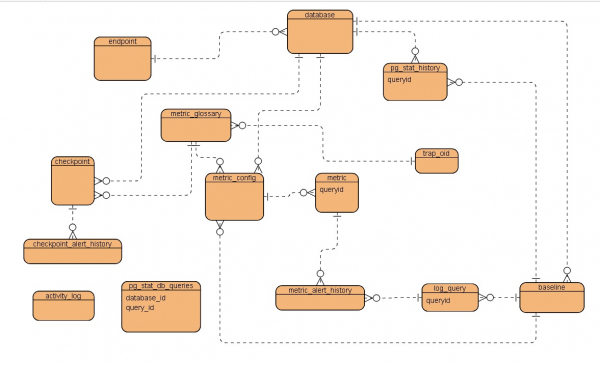
Breve descrição das tabelasendpoint — host, ponto de conexão com a instância
database — parâmetros da base de dados
pg_stat_history — tabela histórica para armazenar instantâneas temporais da visualização do pg_stat_statements da base de dados alvo
metric_glossary — glossário de métricas de desempenho
metric_config — configuração de métricas individuais
metric — métrica específica para a consulta que está sendo monitorada
metric_alert_history — histórico de alertas de desempenho
log_query — tabela de serviço para armazenar registros desmembrados do arquivo de log do PostgreSQL carregados da AWS
baseline — parâmetros do período de tempo usado como base
checkpoint — configuração das métricas de verificação do estado da base de dados
checkpoint_alert_history — histórico de alertas das métricas de verificação do estado da base de dados
pg_stat_db_queries — tabela de serviço de consultas ativas
activity_log — tabela de serviço do log de atividade
trap_oid — tabela de serviço de configuração de trap
Etapa 1 — coletamos informações estatísticas sobre o desempenho e obtemos relatórios
Para armazenar informações estatísticas, utiliza-se a tabela pg_stat_history
Estrutura da tabela pg_stat_history
                                          Tabela "public.pg_stat_history"
       Coluna        |            Tipo             |                          Modificadores
---------------------+-----------------------------+-------------------------------------------
 id                  | inteiro                     | não nulo padrão nextval('pg_stat_history_id_seq'::regclass)
 snapshot_timestamp  | timestamp sem fuso horário |
 database_id         | inteiro                     |
 dbid                | oid                         |
 userid              | oid                         |
 queryid             | bigint                      |
 query               | texto                       |
 calls               | bigint                      |
 total_time          | precisão dupla              |
 min_time            | precisão dupla              |
 max_time            | precisão dupla              |
 mean_time           | precisão dupla              |
 stddev_time         | precisão dupla              |
 rows                | bigint                      |
 shared_blks_hit     | bigint                      |
 shared_blks_read    | bigint                      |
 shared_blks_dirtied | bigint                      |
 shared_blks_written | bigint                      |
 local_blks_hit      | bigint                      |
 local_blks_read     | bigint                      |
 local_blks_dirtied  | bigint                      |
 local_blks_written  | bigint                      |
 temp_blks_read      | bigint                      |
 temp_blks_written   | bigint                      |
 blk_read_time       | precisão dupla              |
 blk_write_time      | precisão dupla              |
 baseline_id         | inteiro                     |
Índices:
    "pg_stat_history_pkey" CHAVE PRIMÁRIA, btree (id)
    "database_idx" btree (database_id)
    "queryid_idx" btree (queryid)
    "snapshot_timestamp_idx" btree (snapshot_timestamp)
Restrições de chave estrangeira:
    "database_id_fk" CHAVE ESTRANGEIRA (database_id) REFERENCES database(id) ON DELETE CASCADE
Como pode ser visto, a tabela representa apenas dados acumulados da visão pg_stat_statements na base de dados de destino.
O uso desta tabela é muito simples
pg_stat_history representará a estatística acumulada da execução de consultas a cada hora. No início de cada hora, após o preenchimento da tabela, as estatísticas pg_stat_statements são reiniciadas com o auxílio de pg_stat_statements_reset().
Nota: as estatísticas são coletadas para consultas com duração de execução superior a 1 segundo.
Preenchimento da tabela pg_stat_history
--pg_stat_history.sql
CREATE OR REPLACE FUNCTION pg_stat_history( ) RETURNS boolean AS $$
DECLARE
  endpoint_rec record ;
  database_rec record ;
  pg_stat_snapshot record ;
  current_snapshot_timestamp timestamp without time zone;
BEGIN
  current_snapshot_timestamp = date_trunc('minute',now());

  FOR endpoint_rec IN SELECT * FROM endpoint
  LOOP
    FOR database_rec IN SELECT * FROM database WHERE endpoint_id = endpoint_rec.id
	  LOOP

		RAISE NOTICE 'NOVA IMAGEM ESTÁ SENDO CRIADA';

		--Conectar ao DB alvo
	    EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||endpoint_rec.host||' dbname='||database_rec.name||' user=USER password=PASSWORD '')';

        RAISE NOTICE 'host % e dbname % ',endpoint_rec.host,database_rec.name;
		RAISE NOTICE 'Criando a imagem de pg_stat_statements para o banco de dados %',database_rec.name;

		SELECT
	      *
		INTO
		  pg_stat_snapshot
	    FROM dblink('LINK1',
	      'SELECT
	       dbid , SUM(calls),SUM(total_time),SUM(rows) ,SUM(shared_blks_hit) ,SUM(shared_blks_read) ,SUM(shared_blks_dirtied) ,SUM(shared_blks_written) ,
           SUM(local_blks_hit) , SUM(local_blks_read) , SUM(local_blks_dirtied) , SUM(local_blks_written) , SUM(temp_blks_read) , SUM(temp_blks_written) , SUM(blk_read_time) , SUM(blk_write_time)
	       FROM pg_stat_statements WHERE dbid=(SELECT oid from pg_database where datname=current_database() )
		   GROUP BY dbid
  	      '
	               )
	      AS t
	       ( dbid oid , calls bigint ,
  	         total_time double precision ,
	         rows bigint , shared_blks_hit bigint , shared_blks_read bigint ,shared_blks_dirtied bigint ,shared_blks_written	 bigint ,
             local_blks_hit	 bigint ,local_blks_read bigint , local_blks_dirtied bigint ,local_blks_written bigint ,
             temp_blks_read	 bigint ,temp_blks_written bigint ,
             blk_read_time double precision , blk_write_time double precision
	       );

		INSERT INTO pg_stat_history
          (
		    snapshot_timestamp  ,database_id  ,
			dbid , calls  ,total_time ,
            rows ,shared_blks_hit  ,shared_blks_read  ,shared_blks_dirtied  ,shared_blks_written ,local_blks_hit ,
            local_blks_read,local_blks_dirtied,local_blks_written,temp_blks_read,temp_blks_written,
            blk_read_time, blk_write_time
		  )
	    VALUES
	      (
	       current_snapshot_timestamp ,
		   database_rec.id ,
	       pg_stat_snapshot.dbid ,pg_stat_snapshot.calls,
	       pg_stat_snapshot.total_time,
	       pg_stat_snapshot.rows ,pg_stat_snapshot.shared_blks_hit ,pg_stat_snapshot.shared_blks_read ,pg_stat_snapshot.shared_blks_dirtied ,pg_stat_snapshot.shared_blks_written ,
           pg_stat_snapshot.local_blks_hit , pg_stat_snapshot.local_blks_read , pg_stat_snapshot.local_blks_dirtied , pg_stat_snapshot.local_blks_written ,
	       pg_stat_snapshot.temp_blks_read , pg_stat_snapshot.temp_blks_written , pg_stat_snapshot.blk_read_time , pg_stat_snapshot.blk_write_time
	      );

        RAISE NOTICE 'Criando a imagem de pg_stat_statements para consultas com min_time maior que 1000ms';

        FOR pg_stat_snapshot IN
          --Todas as consultas com max_time maior que 1000 ms
	      SELECT
	        *
	      FROM dblink('LINK1',
	        'SELECT
	         dbid , userid ,queryid,query,calls,total_time,min_time ,max_time,mean_time, stddev_time ,rows ,shared_blks_hit ,
			 shared_blks_read ,shared_blks_dirtied ,shared_blks_written ,
             local_blks_hit , local_blks_read , local_blks_dirtied ,
			 local_blks_written , temp_blks_read , temp_blks_written , blk_read_time ,
			 blk_write_time
	         FROM pg_stat_statements
			 WHERE dbid=(SELECT oid from pg_database where datname=current_database() AND min_time >= 1000 )
  	        '

	                  )
	        AS t
	         ( dbid oid , userid oid , queryid bigint ,query text , calls bigint ,
  	           total_time double precision ,min_time double precision	 ,max_time double precision	 , mean_time double precision	 ,  stddev_time double precision	 ,
	           rows bigint , shared_blks_hit bigint , shared_blks_read bigint ,shared_blks_dirtied bigint ,shared_blks_written	 bigint ,
               local_blks_hit	 bigint ,local_blks_read bigint , local_blks_dirtied bigint ,local_blks_written bigint ,
               temp_blks_read	 bigint ,temp_blks_written bigint ,
               blk_read_time double precision , blk_write_time double precision
	         )
	    LOOP
		  INSERT INTO pg_stat_history
          (
		    snapshot_timestamp  ,database_id  ,
			dbid ,userid  , queryid  , query  , calls  ,total_time ,min_time ,max_time ,mean_time ,stddev_time ,
            rows ,shared_blks_hit  ,shared_blks_read  ,shared_blks_dirtied  ,shared_blks_written ,local_blks_hit ,
            local_blks_read,local_blks_dirtied,local_blks_written,temp_blks_read,temp_blks_written,
            blk_read_time, blk_write_time
		  )
	      VALUES
	      (
	       current_snapshot_timestamp ,
		   database_rec.id ,
	       pg_stat_snapshot.dbid ,pg_stat_snapshot.userid ,pg_stat_snapshot.queryid,pg_stat_snapshot.query,pg_stat_snapshot.calls,
	       pg_stat_snapshot.total_time,pg_stat_snapshot.min_time ,pg_stat_snapshot.max_time,pg_stat_snapshot.mean_time, pg_stat_snapshot.stddev_time ,
	       pg_stat_snapshot.rows ,pg_stat_snapshot.shared_blks_hit ,pg_stat_snapshot.shared_blks_read ,pg_stat_snapshot.shared_blks_dirtied ,pg_stat_snapshot.shared_blks_written ,
           pg_stat_snapshot.local_blks_hit , pg_stat_snapshot.local_blks_read , pg_stat_snapshot.local_blks_dirtied , pg_stat_snapshot.local_blks_written ,
	       pg_stat_snapshot.temp_blks_read , pg_stat_snapshot.temp_blks_written , pg_stat_snapshot.blk_read_time , pg_stat_snapshot.blk_write_time
	      );

        END LOOP;

        PERFORM dblink_disconnect('LINK1');

	  END LOOP ;--FOR database_rec IN SELECT * FROM database WHERE endpoint_id = endpoint_rec.id

  END LOOP;

RETURN TRUE;
END
$$ LANGUAGE plpgsql;
Como resultado, após um certo período de tempo na tabela pg_stat_history , teremos um conjunto de instantâneas do conteúdo da tabela pg_stat_statements do banco de dados alvo.
Relatórios propriamente ditos
Com consultas simples, é possível obter relatórios bastante úteis e interessantes.
Dados agregados para um intervalo de tempo específico
Consulta
SELECT
  database_id ,
  SUM(calls) AS calls ,SUM(total_time)  AS total_time ,
  SUM(rows) AS rows , SUM(shared_blks_hit)  AS shared_blks_hit,
  SUM(shared_blks_read) AS shared_blks_read ,
  SUM(shared_blks_dirtied) AS shared_blks_dirtied,
  SUM(shared_blks_written) AS shared_blks_written ,
  SUM(local_blks_hit) AS local_blks_hit ,
  SUM(local_blks_read) AS local_blks_read ,
  SUM(local_blks_dirtied) AS local_blks_dirtied ,
  SUM(local_blks_written)  AS local_blks_written,
  SUM(temp_blks_read) AS temp_blks_read,
  SUM(temp_blks_written) temp_blks_written ,
  SUM(blk_read_time) AS blk_read_time ,
  SUM(blk_write_time) AS blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY database_id ;
Tempo de DB
to_char(interval ‘1 millisecond’ * pg_total_stat_history_rec.total_time, ‘HH24:MI:SS.MS’)
Tempo de I/O
to_char(interval ‘1 millisecond’ * ( pg_total_stat_history_rec.blk_read_time + pg_total_stat_history_rec.blk_write_time ), ‘HH24:MI:SS.MS’)
TOP10 SQL por total_time
Consulta
SELECT
  queryid ,
  SUM(calls) AS calls ,
  SUM(total_time)  AS total_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY queryid
ORDER BY 3 DESC
LIMIT 10
------------------------------------------------------------------------------------- | TOP10 SQL POR TEMPO DE EXECUÇÃO TOTAL | #| queryid| calls| calls %| total_time (ms) | dbtime % +----+-----------+-----------+-----------+--------------------------------+---------- | 1| 821760255| 2| .00001|00:03:23.141( 203141.681 ms.)| 5.42 | 2| 4152624390| 2| .00001|00:03:13.929( 193929.215 ms.)| 5.17 | 3| 1484454471| 4| .00001|00:02:09.129( 129129.057 ms.)| 3.44 | 4| 655729273| 1| .00000|00:02:01.869( 121869.981 ms.)| 3.25 | 5| 2460318461| 1| .00000|00:01:33.113( 93113.835 ms.)| 2.48 | 6| 2194493487| 4| .00001|00:00:17.377( 17377.868 ms.)| .46 | 7| 1053044345| 1| .00000|00:00:06.156( 6156.352 ms.)| .16 | 8| 3644780286| 1| .00000|00:00:01.063( 1063.830 ms.)| .03
TOP10 SQL por tempo total de I/O
Consulta
SELECT
  queryid ,
  SUM(calls) AS calls ,
  SUM(blk_read_time + blk_write_time)  AS io_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY  queryid
ORDER BY 3 DESC
LIMIT 10
---------------------------------------------------------------------------------------- | TOP10 SQL POR TEMPO TOTAL DE I/O | #| queryid| chamadas| % de chamadas| Tempo de I/O (ms)|% de tempo de I/O do db +----+-----------+-----------+-----------+--------------------------------+------------- | 1| 4152624390| 2| .00001|00:08:31.616( 511616.592 ms.)| 31.06 | 2| 821760255| 2| .00001|00:08:27.099( 507099.036 ms.)| 30.78 | 3| 655729273| 1| .00000|00:05:02.209( 302209.137 ms.)| 18.35 | 4| 2460318461| 1| .00000|00:04:05.981( 245981.117 ms.)| 14.93 | 5| 1484454471| 4| .00001|00:00:39.144( 39144.221 ms.)| 2.38 | 6| 2194493487| 4| .00001|00:00:18.182( 18182.816 ms.)| 1.10 | 7| 1053044345| 1| .00000|00:00:16.611( 16611.722 ms.)| 1.01 | 8| 3644780286| 1| .00000|00:00:00.436( 436.205 ms.)| .03
TOP10 SQL pelo tempo máximo de execução
Consulta
SELECT
  id AS snapshotid ,
  queryid ,
  snapshot_timestamp ,
  max_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
ORDER BY 4 DESC
LIMIT 10
----------------------------------------------------------------------------------------- | TOP10 SQL PELO TEMPO MÁXIMO DE EXECUÇÃO | #| snapshot| snapshotID| queryid| max_time (ms) +----+------------------+-----------+-----------+---------------------------------------- | 1| 05.04.2019 01:03| 4169| 655729273| 00:02:01.869( 121869.981 ms.) | 2| 04.04.2019 17:00| 4153| 821760255| 00:01:41.570( 101570.841 ms.) | 3| 04.04.2019 16:00| 4146| 821760255| 00:01:41.570( 101570.841 ms.) | 4| 04.04.2019 16:00| 4144| 4152624390| 00:01:36.964( 96964.607 ms.) | 5| 04.04.2019 17:00| 4151| 4152624390| 00:01:36.964( 96964.607 ms.) | 6| 05.04.2019 10:00| 4188| 1484454471| 00:01:33.452( 93452.150 ms.) | 7| 04.04.2019 17:00| 4150| 2460318461| 00:01:33.113( 93113.835 ms.) | 8| 04.04.2019 15:00| 4140| 1484454471| 00:00:11.892( 11892.302 ms.) | 9| 04.04.2019 16:00| 4145| 1484454471| 00:00:11.892( 11892.302 ms.) | 10| 04.04.2019 17:00| 4152| 1484454471| 00:00:11.892( 11892.302 ms.)
TOP10 SQL por leitura/escrita de buffer COMPARTILHADO
Consulta
SELECT
  id AS snapshotid ,
  queryid ,
  snapshot_timestamp ,
  shared_blks_read ,
  shared_blks_written
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( shared_blks_read > 0 OR shared_blks_written > 0 )
ORDER BY 4 DESC  , 5 DESC
LIMIT 10
-------------------------------------------------------------------------------------------- | TOP10 SQL POR LEITURA/GRAVAÇÃO DE BUFFER COMPARTILHADO | #| instantâneo| snapshotID| queryid| blocos compartilhados lidos| blocos compartilhados escritos +----+------------------+-----------+-----------+---------------------+--------------------- | 1| 04.04.2019 17:00| 4153| 821760255| 797308| 0 | 2| 04.04.2019 16:00| 4146| 821760255| 797308| 0 | 3| 05.04.2019 01:03| 4169| 655729273| 797158| 0 | 4| 04.04.2019 16:00| 4144| 4152624390| 756514| 0 | 5| 04.04.2019 17:00| 4151| 4152624390| 756514| 0 | 6| 04.04.2019 17:00| 4150| 2460318461| 734117| 0 | 7| 04.04.2019 17:00| 4155| 3644780286| 52973| 0 | 8| 05.04.2019 01:03| 4168| 1053044345| 52818| 0 | 9| 04.04.2019 15:00| 4141| 2194493487| 52813| 0 | 10| 04.04.2019 16:00| 4147| 2194493487| 52813| 0 --------------------------------------------------------------------------------------------
Histograma de distribuição de consultas por tempo de execução máximo
Consultas
SELECT
  MIN(max_time) AS hist_min  ,
  MAX(max_time) AS hist_max ,
  (( MAX(max_time) - MIN(min_time) ) / hist_columns ) as hist_width
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT ;

SELECT
  SUM(calls) AS calls
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( max_time >= hist_current_min AND  max_time < hist_current_max ) ;
|-----------------------------------------------------------------------------------------------
| HISTOGRAMA DE TEMPO MÁXIMO
| TOTAL DE CHAMADAS : 33851920
| TEMPO MÍNIMO  : 00:00:01.063
| TEMPO MÁXIMO  : 00:02:01.869
---------------------------------------------------------------------------------
|                      duração mínima|                      duração máxima|     chamadas
+----------------------------------+----------------------------------+----------
| 00:00:01.063(      1063.830 ms.) | 00:00:13.144(     13144.445 ms.) | 9
| 00:00:13.144(     13144.445 ms.) | 00:00:25.225(     25225.060 ms.) | 0
| 00:00:25.225(     25225.060 ms.) | 00:00:37.305(     37305.675 ms.) | 0
| 00:00:37.305(     37305.675 ms.) | 00:00:49.386(     49386.290 ms.) | 0
| 00:00:49.386(     49386.290 ms.) | 00:01:01.466(     61466.906 ms.) | 0
| 00:01:01.466(     61466.906 ms.) | 00:01:13.547(     73547.521 ms.) | 0
| 00:01:13.547(     73547.521 ms.) | 00:01:25.628(     85628.136 ms.) | 0
| 00:01:25.628(     85628.136 ms.) | 00:01:37.708(     97708.751 ms.) | 4
| 00:01:37.708(     97708.751 ms.) | 00:01:49.789(    109789.366 ms.) | 2
| 00:01:49.789(    109789.366 ms.) | 00:02:01.869(    121869.981 ms.) | 0
TOP10 Instantâneas por Consulta por Segundo
Consultas
--pg_qps.sql
--Calcular Consultas Por Segundo
CREATE OR REPLACE FUNCTION pg_qps( pg_stat_history_id integer ) RETURNS double precision AS $$
DECLARE
 pg_stat_history_rec record ;
 prev_pg_stat_history_id integer ;
 prev_pg_stat_history_rec record;
 total_seconds double precision ;
 result double precision;
BEGIN
  result = 0 ;

  SELECT *
  INTO pg_stat_history_rec
  FROM
    pg_stat_history
  WHERE id = pg_stat_history_id ;

  IF pg_stat_history_rec.snapshot_timestamp IS NULL
  THEN
    RAISE EXCEPTION 'ERRO - pg_stat_history não encontrado para id = %',pg_stat_history_id;
  END IF ;

 --RAISE NOTICE 'pg_stat_history_id = % , snapshot_timestamp = %', pg_stat_history_id ,
 pg_stat_history_rec.snapshot_timestamp ;

  SELECT
    MAX(id)
  INTO
    prev_pg_stat_history_id
  FROM
    pg_stat_history
  WHERE
    database_id = pg_stat_history_rec.database_id AND
	queryid IS NULL AND
	id  0
  THEN
    result = pg_stat_history_rec.calls / total_seconds ;
  ELSE
   result = 0 ;
  END IF;

 RETURN result ;
END
$$ LANGUAGE plpgsql;


SELECT
  id ,
  snapshot_timestamp ,
  calls ,
  total_time ,
  ( select pg_qps( id )) AS QPS ,
  blk_read_time ,
  blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( select pg_qps( id )) IS NOT NULL
ORDER BY 5 DESC
LIMIT 10
|-----------------------------------------------------------------------------------------------
| TOP10 Capturas ordenadas por números de QueryPerSeconds
-----------------------------------------------------------------------------------------------------------------------------------------------
|    #|          captura| snapshotID|      chamadas|                      tempo total db|        QPS|                          tempo I/O| percentual de tempo I/O%
+-----+------------------+-----------+-----------+----------------------------------+-----------+----------------------------------+-----------
|    1|  04.04.2019 20:04|       4161|    5758631|  00:06:30.513(    390513.926 ms.)|   1573.396|  00:00:01.470(      1470.110 ms.)|       .376
|    2|  04.04.2019 17:00|       4149|    3529197|  00:11:48.830(    708830.618 ms.)|    980.332|  00:12:47.834(    767834.052 ms.)|    108.324
|    3|  04.04.2019 16:00|       4143|    3525360|  00:10:13.492(    613492.351 ms.)|    979.267|  00:08:41.396(    521396.555 ms.)|     84.988
|    4|  04.04.2019 21:03|       4163|    2781536|  00:03:06.470(    186470.979 ms.)|    785.745|  00:00:00.249(       249.865 ms.)|       .134
|    5|  04.04.2019 19:03|       4159|    2890362|  00:03:16.784(    196784.755 ms.)|    776.979|  00:00:01.441(      1441.386 ms.)|       .732
|    6|  04.04.2019 14:00|       4137|    2397326|  00:04:43.033(    283033.854 ms.)|    665.924|  00:00:00.024(        24.505 ms.)|       .009
|    7|  04.04.2019 15:00|       4139|    2394416|  00:04:51.435(    291435.010 ms.)|    665.116|  00:00:12.025(     12025.895 ms.)|      4.126
|    8|  04.04.2019 13:00|       4135|    2373043|  00:04:26.791(    266791.988 ms.)|    659.179|  00:00:00.064(        64.261 ms.)|       .024
|    9|  05.04.2019 01:03|       4167|    4387191|  00:06:51.380(    411380.293 ms.)|    609.332|  00:05:18.847(    318847.407 ms.)|     77.507
|   10|  04.04.2019 18:01|       4157|    1145596|  00:01:19.217(     79217.372 ms.)|    313.004|  00:00:01.319(      1319.676 ms.)|      1.666
Histórico de Execução Horária com QueryPerSeconds e Tempo I/O
Consulta
SELECT
  id ,
  snapshot_timestamp ,
  chamadas ,
  tempo_total ,
  ( select pg_qps( id )) AS QPS ,
  blk_read_time ,
  blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
ORDER BY 2
|-----------------------------------------------------------------------------------------------
| HISTÓRICO DE EXECUÇÃO POR HORA COM QueryPerSeconds e Tempo I/O
-----------------------------------------------------------------------------------------------------------------------------------------------
| HISTÓRICO DE CONSULTAS POR SEGUNDO
|    #|          instantâneo| snapshotID|      chamadas|                      total dbtime|        QPS|                          tempo I/O| % do tempo I/O
+-----+------------------+-----------+-----------+----------------------------------+-----------+----------------------------------+-----------
|    1|  04.04.2019 11:00|       4131|       3747|  00:00:00.835(       835.374 ms.)|      1.041|  00:00:00.000(          .000 ms.)|       .000
|    2|  04.04.2019 12:00|       4133|    1002722|  00:01:52.419(    112419.376 ms.)|    278.534|  00:00:00.149(       149.105 ms.)|       .133
|    3|  04.04.2019 13:00|       4135|    2373043|  00:04:26.791(    266791.988 ms.)|    659.179|  00:00:00.064(        64.261 ms.)|       .024
|    4|  04.04.2019 14:00|       4137|    2397326|  00:04:43.033(    283033.854 ms.)|    665.924|  00:00:00.024(        24.505 ms.)|       .009
|    5|  04.04.2019 15:00|       4139|    2394416|  00:04:51.435(    291435.010 ms.)|    665.116|  00:00:12.025(     12025.895 ms.)|      4.126
|    6|  04.04.2019 16:00|       4143|    3525360|  00:10:13.492(    613492.351 ms.)|    979.267|  00:08:41.396(    521396.555 ms.)|     84.988
|    7|  04.04.2019 17:00|       4149|    3529197|  00:11:48.830(    708830.618 ms.)|    980.332|  00:12:47.834(    767834.052 ms.)|    108.324
|    8|  04.04.2019 18:01|       4157|    1145596|  00:01:19.217(     79217.372 ms.)|    313.004|  00:00:01.319(      1319.676 ms.)|      1.666
|    9|  04.04.2019 19:03|       4159|    2890362|  00:03:16.784(    196784.755 ms.)|    776.979|  00:00:01.441(      1441.386 ms.)|       .732
|   10|  04.04.2019 20:04|       4161|    5758631|  00:06:30.513(    390513.926 ms.)|   1573.396|  00:00:01.470(      1470.110 ms.)|       .376
|   11|  04.04.2019 21:03|       4163|    2781536|  00:03:06.470(    186470.979 ms.)|    785.745|  00:00:00.249(       249.865 ms.)|       .134
|   12|  04.04.2019 23:03|       4165|    1443155|  00:01:34.467(     94467.539 ms.)|    200.438|  00:00:00.015(        15.287 ms.)|       .016
|   13|  05.04.2019 01:03|       4167|    4387191|  00:06:51.380(    411380.293 ms.)|    609.332|  00:05:18.847(    318847.407 ms.)|     77.507
|   14|  05.04.2019 02:03|       4171|     189852|  00:00:10.989(     10989.899 ms.)|     52.737|  00:00:00.539(       539.110 ms.)|      4.906
|   15|  05.04.2019 03:01|       4173|       3627|  00:00:00.103(       103.000 ms.)|      1.042|  00:00:00.004(         4.131 ms.)|      4.010
|   16|  05.04.2019 04:00|       4175|       3627|  00:00:00.085(        85.235 ms.)|      1.025|  00:00:00.003(         3.811 ms.)|      4.471
|   17|  05.04.2019 05:00|       4177|       3747|  00:00:00.849(       849.454 ms.)|      1.041|  00:00:00.006(         6.124 ms.)|       .721
|   18|  05.04.2019 06:00|       4179|       3747|  00:00:00.849(       849.561 ms.)|      1.041|  00:00:00.000(          .051 ms.)|       .006
|   19|  05.04.2019 07:00|       4181|       3747|  00:00:00.839(       839.416 ms.)|      1.041|  00:00:00.000(          .062 ms.)|       .007
|   20|  05.04.2019 08:00|       4183|       3747|  00:00:00.846(       846.382 ms.)|      1.041|  00:00:00.000(          .007 ms.)|       .001
|   21|  05.04.2019 09:00|       4185|       3747|  00:00:00.855(       855.426 ms.)|      1.041|  00:00:00.000(          .065 ms.)|       .008
|   22|  05.04.2019 10:00|       4187|       3797|  00:01:40.150(    100150.165 ms.)|      1.055|  00:00:21.845(     21845.217 ms.)|     21.812
Texto de todas as consultas SQL
Consulta
SELECIONE
  queryid,
  query
FROM
  pg_stat_history
WHERE
  queryid NÃO É NULO E
  database_id = DATABASE_ID E
  snapshot_timestamp ENTRE BEGIN_TIMEPOINT E END_TIMEPOINT
AGRUPAR POR queryid, query
Resultado
Como pode ser visto, utilizando recursos bastante simples, é possível obter uma quantidade considerável de informações úteis sobre a carga e o estado do banco de dados.
Observação:Se nos comandos registrarmos o queryid, teremos um histórico de consultas separadas (com o objetivo de economizar espaço, relatórios para consultas separadas foram omitidos).
Assim, os dados estatísticos sobre o desempenho das consultas estão disponíveis e sendo coletados.
A primeira etapa "coleta de dados estatísticos" foi concluída.
Podemos passar para a segunda etapa - "configuração de métricas de desempenho".
Mas isso já é uma história completamente diferente.
Continua…
Fonte: habr.com
