

Na semana passada, eu participei da conferência de TI DUMP (https://dump-ekb.ru/) em Ekaterinburgo e quero contar sobre o que foi discutido nas seções de Backend e Devops, e se as conferências regionais de TI valem a pena.
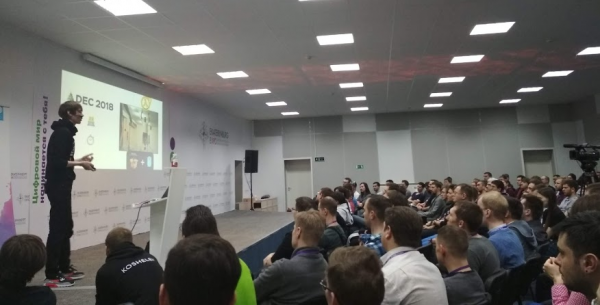
Nikolai Sverchkov da Evil Martians sobre Serverless
O que aconteceu lá, afinal?
No total, a conferência teve 8 seções: Backend, Frontend, Mobile, Teste e QA, Devops, Design, Ciência e Gestão.
Os maiores auditórios, aliás, eram os da Ciência e Gestão, cada um com cerca de 350 pessoas. Backend e Frontend eram um pouco menores. A sala de Devops era a mais pequena, mas bastante ativa.
Eu assisti às palestras nas seções de Devops e Backend e conversei um pouco com os palestrantes. Quero falar sobre os temas abordados e fazer uma análise dessas seções na conferência.
Nas seções de Devops e Backend, participaram representantes da SKB-Kontur, DataArt, Evil Martians, do estúdio web de Ekaterinburgo Flag, Miro (RealTimeBoard). Os temas incluíam CI/CD, trabalho com serviços de filas, log, e os temas Serverless e o uso de PostgreSQL em Go foram bem explorados.
Houve também palestras da Avito, Tinkoff, Yandex, Jetstyle, Megafon, e do banco Ak Bars, mas não consegui assisti-las fisicamente (as gravações em vídeo e os slides ainda não estão disponíveis, prometem disponibilizá-los em duas semanas no dump-ekb.ru).
Seção de Devops
O que me surpreendeu — a seção ocorreu na sala menor, com cerca de 50 lugares. As pessoas estavam até nos corredores 🙂 Vou contar sobre as palestras que consegui ouvir.
Elasticsearch com um petabyte
A seção começou com a palestra de Vladimir Lila (SKB-Kontur) sobre Elasticsearch na Kontur. Eles têm um Elasticsearch bastante grande e carregado (~800 TB de dados, ~1,3 petabyte considerando a redundância). O Elasticsearch para todos os serviços da Kontur é único, composto por 2 clusters (de 7 e 9 servidores), e é tão importante que a Kontur tem um engenheiro específico para Elasticsearch (na verdade, o próprio Vladimir).
Vladimir também compartilhou suas opiniões sobre os benefícios do Elasticsearch e os problemas que ele traz.
Benefícios:
- Todos os logs em um só lugar, fácil acesso a eles
- Armazenamento dos logs durante um ano e fácil análise deles
- Alta velocidade de trabalho com logs
- Visualização de dados excelente "pronta para uso"
Problemas:
- broker de mensagens — essencial (na Kontur, essa função é desempenhada pelo Kafka)
- particularidades do uso do Elasticsearch Curator (carga alta periodicamente devido a tarefas agendadas no Curator)
- não há autenticação integrada (apenas por um custo separado, bastante elevado, ou como plugins de código aberto com diferentes graus de prontidão para produção)
Sobre o Open Distro for Elasticsearch, as opiniões foram só positivas 🙂 A mesma questão de autenticação foi resolvida lá.
De onde vem o petabyte?Os nós deles são compostos por servidores com 12*8 Tb SATA + 2*2 Tb SSD. O armazenamento frio é feito em SATA, e o SSD é apenas para cache quente (hot storage).
7+9 servidores, (7 + 9) * 12 * 8 = 1536 Tb.
Uma parte do espaço é reservada, alocada para redundância e afins.
Logs de cerca de 90 aplicações são enviados para o Elasticsearch, incluindo todos os serviços de reporte do Kontur, Elba e outros.
Características do desenvolvimento em Serverless
A seguir, a apresentação de Ruslan Serkin da DataArt sobre Serverless.
Ruslan falou sobre o que é o desenvolvimento com a abordagem Serverless em geral, e quais são suas características.
Serverless é uma abordagem de desenvolvimento em que os desenvolvedores não interagem de forma alguma com a infraestrutura. Exemplos: AWS Lambda Serverless, Kubeless.io (Serverless dentro do Kubernetes), Google Cloud Functions.
Um aplicativo ideal em Serverless é basicamente uma função que envia uma solicitação a um provedor Serverless através de um Gateway de API especial. É um microserviço ideal, sendo que o AWS Lambda suporta uma grande quantidade de linguagens de programação modernas. O custo de suporte e implantação da infraestrutura se torna zero no caso de provedores de nuvem, e o suporte para pequenas aplicações também será muito barato (AWS Lambda — 0,2$ / 1 milhão de solicitações simples).
A escalabilidade desse sistema é praticamente ideal — o provedor de nuvem cuida disso, o Kubeless escala automaticamente dentro do cluster Kubernetes.
Existem desvantagens:
- o desenvolvimento de grandes aplicações se torna mais difícil
- há complexidade na profilagem de aplicações (você tem acesso apenas aos logs, mas não à profilagem como é entendida normalmente)
- não há versionamento
Vou ser sincero, ouvi sobre Serverless há alguns anos, mas todos esses anos não entendia como aplicá-lo corretamente. Depois da palestra do Ruslan, veio a compreensão, e após a palestra do Nikolai Svertchkov (Evil Martians) da seção de Backend, isso se consolidou. Já valeu a pena ir à conferência 🙂
CI para iniciantes, ou vale a pena criar seu próprio CI para uma agência web
Mikhail Radionov, gerente da agência web Flag de Ekaterinburgo, falou sobre um CI/CD feito por eles.
Sua agência passou pelo caminho do 'CI/CD manual' (acessar o servidor via SSH, fazer git pull, repetir 100 vezes ao dia) até o Jenkins e até uma ferramenta feita por eles, que permite controlar o código e realizar lançamentos chamada Pullkins.
Por que o Jenkins não funcionou? Ele não oferecia flexibilidade suficiente por padrão e era muito complicado para personalizações.
A “Flag” desenvolve no Laravel (framework PHP). Ao desenvolver um servidor CI/CD, Mikhail e sua equipe utilizaram os mecanismos integrados do Laravel chamados Telescope e Envoy. Como resultado, foi criado um servidor em PHP (note-se) que processa solicitações de webhook de entrada, pode compilar front-end, back-end, implantar em diferentes servidores e reportar no Slack.
Em seguida, para possibilitar deploys blue/green e ter configurações uniformes em ambientes dev-stage-prod, eles migram para Docker. As vantagens se mantiveram, acrescendo a possibilidade de homogeneização do ambiente e deploys sem costura, além da necessidade de aprender Docker para trabalhar corretamente com ele.
Como reduzimos o número de rollbacks de lançamentos de servidores em 99%
A última apresentação na seção DevOps foi de Viktor Yaremchenko, engenheiro líder de DevOps na Miro.com (anteriormente RealTimeBoard).
A base do RealTimeBoard, o principal produto da equipe Miro, é um aplicativo monolítico em Java. Compilar, testar e implantar sem downtime é uma tarefa difícil. É importante realizar um deploy de versão de código que não precise ser revertido (após tudo, é um monolítico pesado).
No caminho para construir um sistema que permita isso, a Miro percorreu um trajeto que incluiu trabalho na arquitetura, ferramentas utilizadas (Atlassian Bamboo, Ansible, etc.) e desenvolvimento da organização das equipes (eles agora têm uma equipe de DevOps dedicada e muitas equipes Scrum individuais compostas por desenvolvedores de diferentes perfis).
O caminho foi árduo e espinhoso, e Viktor compartilhou a dor acumulada e ainda assim o otimismo que não se apagou.
Ganhei um livro por perguntas
Seção de Back-end
Consegui assistir a 2 apresentações - de Nikolai Sverchkov (Evil Martians), também sobre Serverless, e de Grigory Koshelev (empresa Kontur) sobre telemetria.
Serverless para os simples mortais
Enquanto Ruslan Sirkin falava sobre o que é Serverless, Nikolai mostrou aplicativos simples utilizando Serverless e detalhou os fatores que impactam o custo e a velocidade de funcionamento dos aplicativos na AWS Lambda.
Um detalhe interessante: o mínimo elemento cobrado é 128 Mb de memória e 100 ms de CPU, custando 0,000000208$. Além disso, 1 milhão dessas solicitações por mês é gratuito.
Algumas funções de Nikolai frequentemente ultrapassaram o limite de 100 ms (o aplicativo principal foi escrito em Ruby), portanto, reescrevê-las em Go trouxe uma ótima economia.
Vostok Hercules — faça a telemetria ser incrível novamente!
O último relato da seção de Backend de Grigory Koshelev (empresa Kontur) sobre telemetria. Telemetria é logs, métricas, rastreamentos de aplicativos.
A Kontur utiliza ferramentas desenvolvidas internamente e disponibilizadas no Github. A ferramenta do relato — Hercules, , é utilizada para a entrega de dados de telemetria.
Na apresentação de Vladimir Lila na seção Devops, foi abordado o armazenamento e processamento de logs no Elasticsearch, mas há a questão de entregar logs de milhares de dispositivos e aplicações, que é resolvida por ferramentas como Vostok Hercules.
A Kontur seguiu um caminho conhecido por muitos — de RabbitMQ para Apache Kafka, mas não é tão simples. Eles tiveram que adicionar ao esquema Zookeeper, Cassandra e Graphite. Não posso revelar todas as informações sobre este relato (não é meu perfil), se estiver interessado — você pode esperar pelos slides e vídeos no site da conferência.
Como se compara com outras conferências?
Não posso comparar com conferências em Moscovo e São Petersburgo, mas posso comparar com outros eventos na região dos Urais e com o 404fest em Samara.
O DUMP acontece em 8 seções, isso é um recorde para conferências nos Urais. Seções muito grandes como Ciência e Gestão, o que também é incomum. A audiência em Ekaterimburgo é bastante estruturada — na cidade há grandes departamentos de desenvolvimento da Yandex, Kontur, Tinkoff, isso também impacta as apresentações.
Outro ponto interessante — muitas empresas têm de 3 a 4 palestrantes na conferência (foi assim com a Kontur, Evil Martians, Tinkoff). Muitos deles eram patrocinadores, mas as apresentações eram de um nível semelhante ao de outras, não eram palestras publicitárias.
Devo ir ou não? Se você mora nos Urais ou nas proximidades, tem a oportunidade e está interessado nos temas — sim, claro. Se você está pensando em uma viagem mais longa — eu daria uma olhada nos temas das apresentações e nos vídeos dos anos anteriores. e tomaria uma decisão.
Outro ponto positivo das conferências nas regiões é, geralmente, a facilidade de conversar com o palestrante após as apresentações, pois simplesmente há menos candidatos a esse tipo de interação.
Obrigado ao DUMP e a Ekaterimburgo!
Fonte: habr.com
