

Olá, Habr!
Lembramos que, após o livro sobre lançamos um trabalho igualmente interessante sobre a biblioteca .
Enquanto a comunidade apenas começa a explorar os limites das capacidades desta poderosa ferramenta. Recentemente, foi publicado um artigo que gostaríamos de apresentá-lo. A partir de sua própria experiência, o autor conta como fazer do Kafka Streams um armazenamento de dados distribuído. Boa leitura!
A biblioteca Apache é utilizada em todo o mundo no setor de empresas para processamento de fluxo distribuído sobre o Apache Kafka. Um dos aspectos subestimados deste framework é que ele permite manter um estado local, gerado a partir do processamento de fluxo.
Neste artigo, contarei como a nossa empresa conseguiu utilizar essa capacidade de maneira vantajosa no desenvolvimento de um produto para segurança de aplicações em nuvem. Com o Kafka Streams, criamos microsserviços com estado compartilhado, cada um dos quais serve como uma fonte resistente a falhas e altamente disponível de informações confiáveis sobre o estado dos objetos no sistema. Para nós, isso representa um avanço tanto em termos de confiabilidade quanto em termos de facilidade de suporte.
Se você está interessado em uma abordagem alternativa que permita usar um único banco de dados central para manter o estado formal de seus objetos – leia, será interessante...
Por que decidimos que era hora de mudar nossas abordagens em relação ao trabalho com estado compartilhado
Precisávamos manter o estado de vários objetos, baseando-nos em relatórios de agentes (por exemplo: o site foi atacado?). Antes da transição para o Kafka Streams, costumávamos depender de um único banco de dados central (+ API de serviço) para gerenciar o estado. Essa abordagem tem suas desvantagens: em a manutenção da consistência e sincronização se torna um verdadeiro desafio. O banco de dados pode se tornar um gargalo, ou acabar em e sofrer de imprevisibilidade.
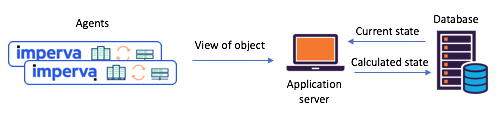
Ilustração 1: um cenário típico de divisão de estado, encontrado antes da transição para
Kafka e Kafka Streams: os agentes comunicam suas representações através da API, o estado atualizado é calculado através do banco de dados central
Conheça o Kafka Streams – agora é fácil criar microsserviços com estado compartilhado
Cerca de um ano atrás, decidimos revisar nossos cenários de trabalho com estado compartilhado para resolver alguns problemas. Imediatamente decidimos experimentar o Kafka Streams – é bem conhecido o quão escalável, disponível e resistente a falhas ele é, além do rico conjunto de funcionalidades de streaming (transformações, incluindo aquelas com estado preservado). Era exatamente o que precisávamos, sem mencionar o quão madura e confiável a sistema de troca de mensagens se tornou no Kafka.
Cada um dos microserviços que criamos com estado preservado foi construído com base em uma instância do Kafka Streams com uma topologia bastante simples. Ela consistia em 1) uma fonte 2) um processador com armazenamento persistente de chaves e valores 3) um fluxo:
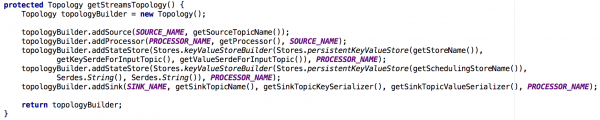
Ilustração 2: a topologia padrão de nossas instâncias de streaming para microserviços com estado preservado. Observe que também há um armazenamento aqui, onde estão os metadados sobre o planejamento.
Com essa nova abordagem, os agentes compõem mensagens que são enviadas ao tópico de origem, e os consumidores – digamos, o serviço de notificações por e-mail – recebem o estado compartilhado calculado através do fluxo (tópico de saída).
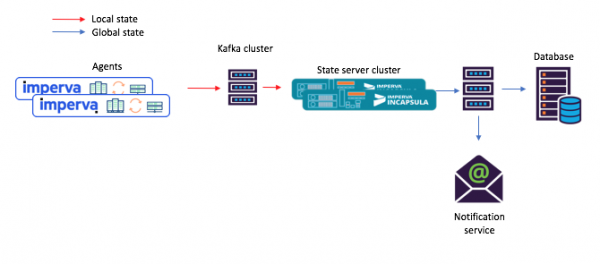
Ilustração 3: um novo exemplo do fluxo de tarefas para o cenário com microserviços compartilhados: 1) um agente gera uma mensagem que chega ao tópico de origem do Kafka; 2) o microserviço com estado compartilhado (usando Kafka Streams) processa ela e grava o estado calculado no tópico final do Kafka; após isso, 3) os consumidores recebem o novo estado.
Ei, esse armazenamento interno de chaves e valores realmente é muito útil!
Como mencionado acima, nossa topologia com estado compartilhado contém um armazenamento de chaves e valores. Encontramos várias opções para sua utilização, e duas delas estão descritas abaixo.
Opção #1: uso do armazenamento de chaves e valores em cálculos.
O nosso primeiro armazenamento de chave-valor continha dados auxiliares necessários para nossos cálculos. Por exemplo, em alguns casos, o estado compartilhado era determinado pelo princípio da "maioria dos votos". No armazenamento, podíamos manter todos os relatórios mais recentes dos agentes sobre o estado de um determinado objeto. Assim, ao receber um novo relatório de um dos agentes, podíamos salvá-lo, extrair do armazenamento os relatórios de todos os outros agentes sobre o mesmo objeto e repetir os cálculos.
Abaixo, na Ilustração 4, mostramos como abrimos o acesso ao armazenamento de chave-valor para o método processador, permitindo assim que uma nova mensagem pudesse ser processada.
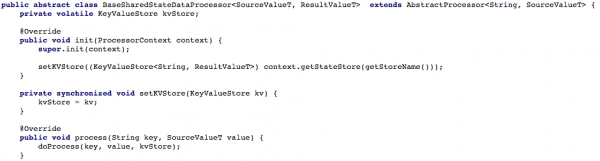
Ilustração 4: abrindo acesso ao armazenamento de chave-valor para o método processador (depois disso, em cada cenário que lida com estado compartilhado, é necessário implementar o método doProcess)
Opção #2: criação de uma API CRUD sobre Kafka Streams
Após configurar nosso fluxo básico de tarefas, começamos a tentar escrever uma API RESTful CRUD para nossos microsserviços que lidam com estado compartilhado. Queríamos que fosse possível extrair o estado de alguns ou todos os objetos, além de definir ou remover o estado de um objeto (isso é útil para a manutenção do backend).
Para suportar toda a API Get State, sempre que precisávamos recomputar o estado durante o processamento, armazenávamos temporariamente no armazenamento integrado de chave-valor. Nesse caso, é bastante simples implementar essa API usando uma única instância do Kafka Streams, como mostrado no listagem abaixo:
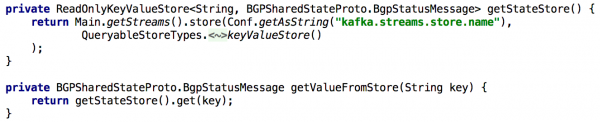
Ilustração 5: utilizando o armazenamento integrado de chave-valor para obter o estado pré-computado de um objeto
A atualização do estado do objeto através da API também não é difícil de implementar. Basicamente, para isso, é necessário apenas criar um produtor Kafka e, com ele, fazer uma gravação que contenha o novo estado. Isso garante que todas as mensagens geradas através da API sejam processadas exatamente da mesma forma que aquelas provenientes de outros produtores (por exemplo, agentes).
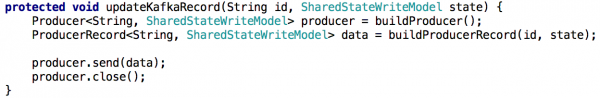
Ilustração 6: o estado do objeto pode ser definido com um produtor Kafka
Um pequeno complicador: o Kafka possui várias partições
Continuando, queríamos distribuir a carga relacionada ao processamento e melhorar a disponibilidade, fornecendo para cada cenário um cluster de microsserviços com estado compartilhado. A configuração foi extremamente simples: depois que configuramos todas as instâncias para que funcionassem com o mesmo ID de aplicativo (e com os mesmos servidores de inicialização), praticamente todo o resto ocorreu automaticamente. Também especificamos que cada tópico de origem consistiria em várias partições, para que cada instância pudesse ser atribuída a um subconjunto dessas partições.
Também gostaria de mencionar que, aqui, é comum fazer backup do armazenamento de estados, para que, por exemplo, em caso de recuperação de falhas, esse backup possa ser transferido para outra instância. Para cada armazenamento de estados no Kafka Streams, é criado um tópico replicável com um log de alterações (onde as atualizações locais são rastreadas). Assim, o Kafka constantemente protege o armazenamento dos estados. Portanto, em caso de falha de alguma instância do Kafka Streams, o armazenamento de estados pode ser rapidamente restaurado em outra instância, para onde as partições correspondentes serão transferidas. Nossos testes mostraram que isso é feito em questão de segundos, mesmo que existam milhões de registros no armazenamento.
Ao passar de um microsserviço com estado compartilhado para um cluster de microsserviços, não é trivial implementar a API Get State. Na nova situação, o armazenamento de estados de cada microsserviço contém apenas uma parte do todo (os objetos cujas chaves foram mapeadas para uma partição específica). Precisávamos determinar em qual instância estava o estado do objeto que precisávamos, e fizemos isso com base nos metadados dos fluxos, conforme mostrado abaixo:
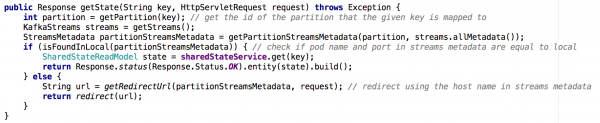
Ilustração 7: usando metadados de fluxos, determinamos de qual instância solicitar o estado do objeto desejado; essa abordagem foi aplicada com a GET ALL API.
Principais Conclusões
Os armazenamentos de estados no Kafka Streams podem, de fato, servir como um banco de dados distribuído.
- constantemente replicado no Kafka
- Sobre esse sistema, é fácil construir uma API CRUD.
- O processamento de múltiplas partições se torna um pouco mais complicado.
- Também é possível adicionar um ou mais armazenamentos de estado à topologia de streaming para armazenar dados auxiliares. Essa opção pode ser utilizada para:
- O armazenamento a longo prazo de dados necessários para cálculos durante o processamento de streaming.
- O armazenamento a longo prazo de dados que podem ser úteis na próxima inicialização da instância de streaming.
- muitas outras…
Graças a essas e outras qualidades, o Kafka Streams é uma excelente escolha para suportar o estado global em um sistema distribuído como o nosso. O Kafka Streams tem se mostrado bastante confiável em produção (desde sua implantação, praticamente não perdemos mensagens), e temos certeza de que suas capacidades não se limitam a isso!
Fonte: habr.com
