

Os logs são uma parte importante do sistema, permitindo entender se ele está funcionando (ou não) como esperado. Em uma arquitetura de microsserviços, trabalhar com logs se torna uma disciplina separada de uma olimpíada especial. É preciso resolver uma série de questões:
- como registrar logs a partir do aplicativo;
- onde registrar os logs;
- como enviar os logs para armazenamento e processamento;
- como processar e armazenar os logs.
A aplicação de tecnologias populares de contêineres adiciona mais complexidade ao campo de opções para resolver o problema.
É exatamente sobre isso que fala a palestra de Yuri Bushmelev, "Mapa de obstáculos no campo de coleta e entrega de logs".
Para quem está interessado, convido a continuar lendo.
Meu nome é Yuri Bushmelev. Eu trabalho na Lazada. Hoje, vou falar sobre como criamos nossos logs, como os coletamos e o que registramos neles.
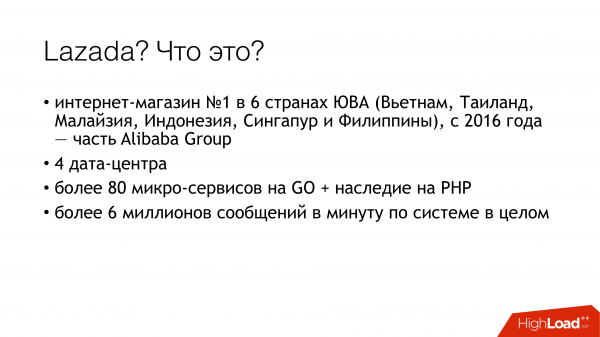
De onde somos? Quem somos nós? A Lazada é a loja online nº 1 em seis países do Sudeste Asiático. Todos esses países estão distribuídos por nossos centros de dados. Atualmente, temos 4 centros de dados. Por que isso é importante? Porque algumas soluções foram influenciadas pelo fato de que há uma conexão muito fraca entre os centros. Trabalhamos com uma arquitetura de microsserviços. Fiquei surpreso ao descobrir que já temos 80 microsserviços. Quando comecei a trabalhar na tarefa dos logs, éramos apenas 20. Além disso, temos uma porção considerável de legados em PHP, com os quais também precisamos conviver e aceitar. Tudo isso gera, atualmente, mais de 6 milhões de mensagens por minuto em todo o sistema. A seguir, mostrarei como tentamos lidar com isso e por que é tão difícil.
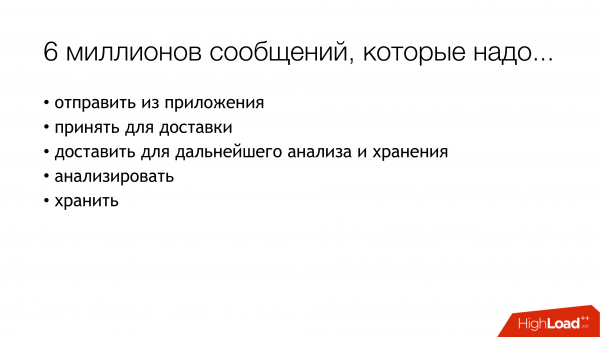
Precisamos lidar com essas 6 milhões de mensagens. O que devemos fazer com elas? 6 milhões de mensagens que precisam ser:
- enviadas do aplicativo
- recebidas para entrega
- entregues para análise e armazenamento.
- analisadas
- armazenadas de alguma forma.
Quando três milhões de mensagens apareceram, eu estava com uma expressão bem parecida. Porque começamos com alguns centavos. É claro que é onde os logs de aplicativos são registrados. Por exemplo, não consegui conectar ao banco de dados, consegui conectar ao banco de dados, mas não consegui ler algo. Mas além disso, cada um dos nossos microserviços também escreve um log de acesso. Cada solicitação que chega ao microserviço é registrada no log. Por que fazemos isso? Os desenvolvedores querem ter a capacidade de rastreamento. Em cada log de acesso, há um campo traceid, pelo qual uma interface especial desenvolve toda a cadeia e mostra o rastreamento de forma organizada. O rastreamento mostra como a solicitação se desenrolou, e isso ajuda nossos desenvolvedores a lidarem mais rapidamente com qualquer aspecto desconhecido.
Como viver com isso? Agora, eu vou falar brevemente sobre as opções - como esse problema é geralmente resolvido. Como resolver a tarefa de coleta, transmissão e armazenamento de logs.
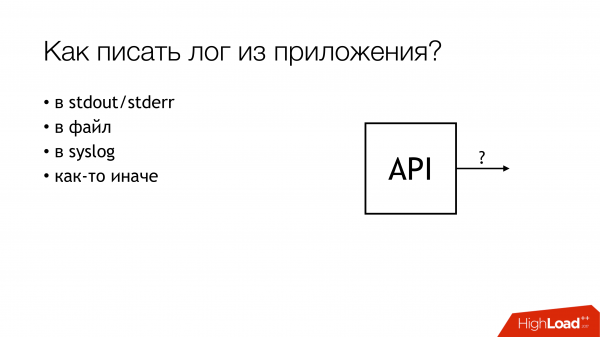
Como escrever do aplicativo? É claro que existem diferentes maneiras. Em particular, há boas práticas, como nos contam os especialistas da moda. Existe o old school em duas versões, como os mais velhos costumavam dizer. Existem outras maneiras.
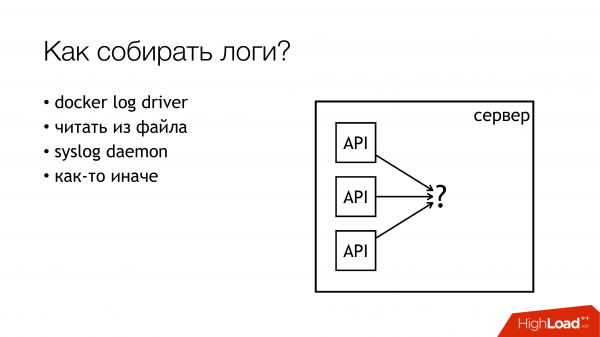
A situação com a coleta de logs é semelhante. As opções para essa parte específica não são muitas. Já existem mais, mas ainda não são tantas.
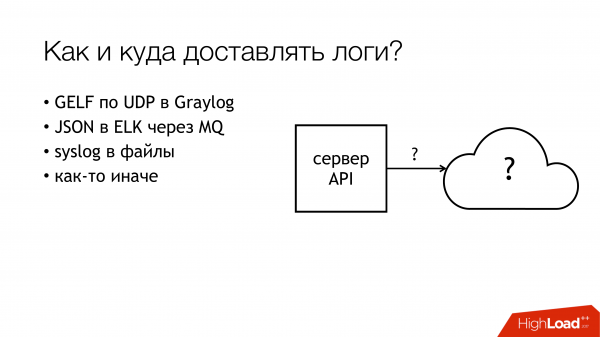
Mas com a entrega e a análise subsequente, o número de variações começa a explodir. Não vou descrever cada opção agora. Creio que as principais estão na mente de todos que se interessaram pelo assunto.
Vou mostrar como fizemos isso na Lazada e como tudo isso começou.
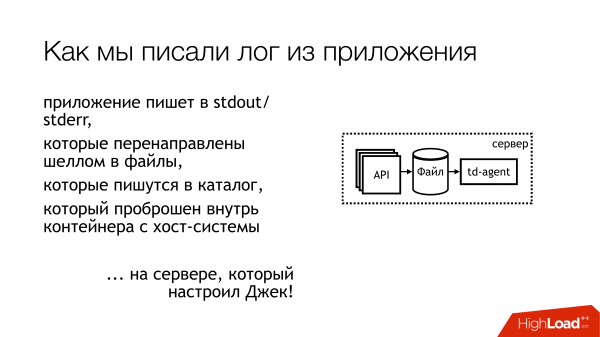
Um ano atrás, cheguei à Lazada, e fui enviado para um projeto sobre logs. Era mais ou menos assim. O log do aplicativo era escrito em stdout e stderr. Todos seguiram a moda. Mas depois os desenvolvedores o tiraram dos fluxos padrão, e depois lá os especialistas em infraestrutura resolveriam. Entre os especialistas em infraestrutura e os desenvolvedores, existem também os liberadores, que disseram: 'ê... tudo bem, vamos simplesmente encapsulá-los em um arquivo com shell, e tudo'. E como tudo isso estava em um contêiner, acabaram encapsulando diretamente no próprio contêiner, mapearam um diretório interno e colocaram isso lá. Acho que todos entendem mais ou menos o que resultou disso.
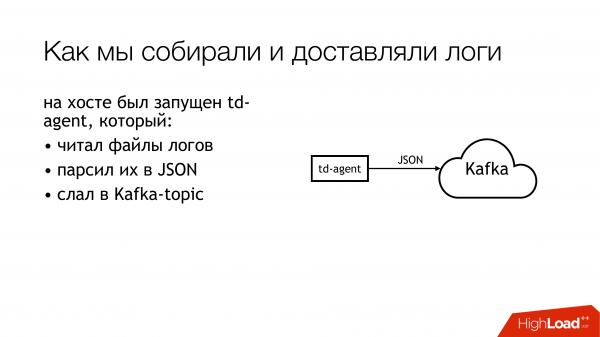
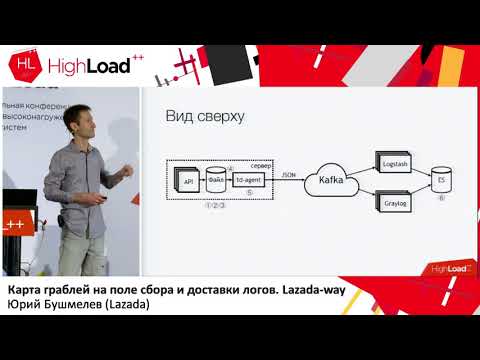
Vamos dar uma olhada um pouco mais adiante. Como entregamos esses logs. Alguém escolheu o td-agent, que na verdade é o fluentd, mas não exatamente o fluentd. Eu nunca entendi a relação entre esses dois projetos, mas eles parecem tratar da mesma coisa. E este fluentd, escrito em Ruby, lia os arquivos de log, os analisava em JSON usando algumas expressões regulares. Depois, eles eram enviados para o Kafka. E no Kafka, para cada API, tínhamos 4 tópicos separados. Por que 4? Porque há live, há staging, e porque há stdout e stderr. Os desenvolvedores os criam, enquanto os engenheiros de infraestrutura precisam criá-los no Kafka. Além disso, o Kafka era controlado por outro departamento. Então, era necessário criar um ticket para que eles criassem 4 tópicos para cada API. Todos esqueciam disso. No geral, foi uma confusão total.
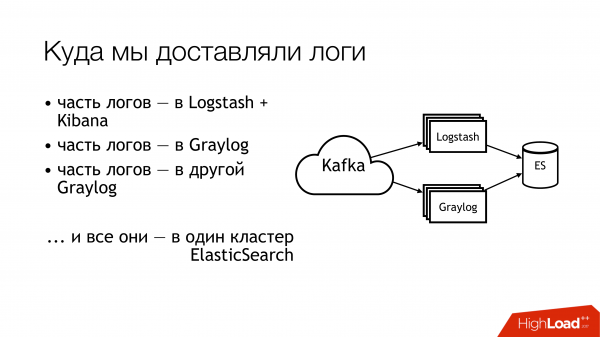
O que fizemos depois com isso? Enviamos para o Kafka. A partir daí, metade dos logs ia para o Logstash. A outra metade dos logs se dividia. Uma parte ia para um Graylog, a outra parte – para outro Graylog. No final, tudo isso ia para um único cluster Elasticsearch. Ou seja, toda essa bagunça acabava lá. Não se deve fazer assim!
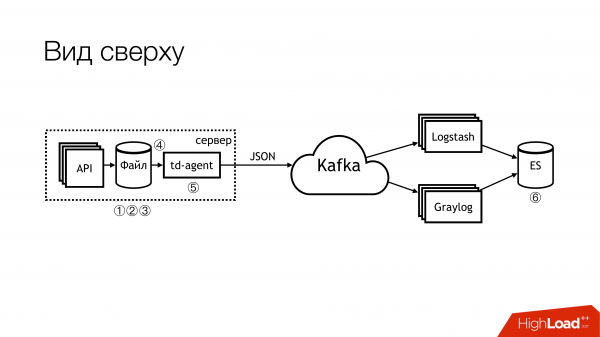
Assim é como isso se parece, se olharmos de cima. Não se deve fazer assim! Aqui estão os pontos problemáticos marcados com números. Na verdade, existem mais, mas 6 são realmente problemáticos, com os quais precisamos fazer algo. Sobre eles, vou falar separadamente agora.
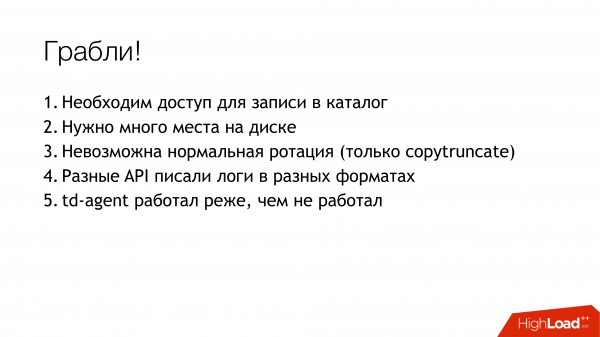
Aqui (1,2,3) temos arquivos sendo escritos e, portanto, aqui estão três armadilhas imediatamente.
Primeiro (1) – precisamos escrevê-los em algum lugar. Nem sempre queremos dar à API a possibilidade de escrever diretamente em um arquivo. Preferencialmente, a API deve estar isolada em um contêiner, e ainda melhor – se for read-only. Eu sou um administrador de sistemas, então tenho uma perspectiva um pouco alternativa sobre essas questões.
O segundo ponto (2,3) é que recebemos muitas solicitações na API. A API grava muitos dados em arquivos. Os arquivos crescem. Precisamos rotacioná-los. Caso contrário, não haverá disco suficiente. Rotacioná-los é complicado, pois são redirecionados via shell para um diretório. Não conseguimos rotacioná-los. Não podemos simplesmente pedir ao aplicativo para reabrir os descritores. Caso contrário, os desenvolvedores vão olhar para você como se fosse um idiota: "Quais descritores? Nós escrevemos no stdout." O pessoal da infraestrutura implementou o copytruncate no logrotate, que faz apenas uma cópia do arquivo e trunca o original. Portanto, entre esses processos de cópia, o espaço em disco geralmente acaba.
(4) Tínhamos formatos diferentes em diferentes APIs. Eles eram um pouco distintos, mas era necessário escrever regexps diferentes. Como tudo isso era gerenciado pelo Puppet, havia um grande emaranhado de classes com suas peculiaridades. Além disso, o td-agent na maior parte do tempo poderia consumir muita memória, travar, ou simplesmente fingir que estava funcionando e não fazer nada. Não era possível perceber externamente que ele não estava fazendo nada. No melhor dos casos, ele caía e alguém o levantava depois. Mais precisamente, um alerta chegava e alguém ia manualmente reiniciá-lo.
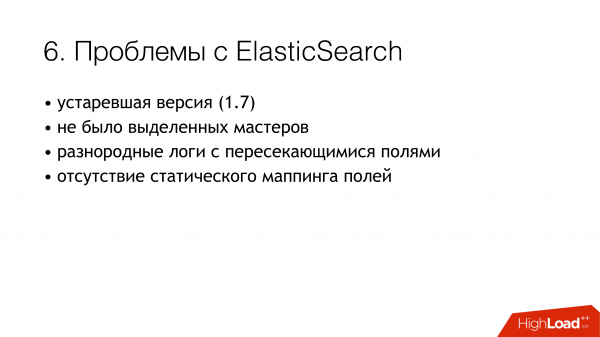
(6) E a maior bagunça foi o elasticsearch. Porque era uma versão antiga. Naquele momento, não tinhamos mestres dedicados. Tínhamos logs heterogêneos, cujos campos poderiam se sobrepor. Diferentes logs de diferentes aplicativos podiam ser escritos com os mesmos nomes de campo, mas poderiam conter dados diferentes. Ou seja, um log chegava com Integer no campo, por exemplo, level. Outro log chegava com String no campo level. Na ausência de um mapeamento estático, isso resultava em um problema notável. Se após a rotação do índice no elasticsearch a primeira mensagem recebida fosse uma string, tudo funcionava normalmente. Mas se a primeira mensagem fosse um Integer, todas as mensagens subsequentes recebidas como String seriam simplesmente descartadas. Porque o tipo de campo não coincide.
Começamos a nos fazer essas perguntas. Decidimos não procurar culpados.
É necessário fazer algo! Uma coisa óbvia — devemos estabelecer padrões. Alguns padrões já existiam. Alguns foram criados um pouco mais tarde. Felizmente, um formato único de logs para todas as APIs já havia sido aprovado até aquele momento. Ele está descrito diretamente nos padrões de interação dos serviços. Assim, aqueles que desejam receber logs devem escrevê-los nesse formato. Se alguém não escreve logs nesse formato, então, não garantimos nada.
Além disso, gostaríamos de estabelecer um padrão único para os métodos de gravação, entrega e coleta de logs. Ou seja, onde escrevê-los e como entregá-los. A situação ideal é quando nos projetos é utilizada a mesma biblioteca. Existe uma biblioteca de logging separada para Go, e outra separada para PHP. Todos os que estão conosco — todos devem usá-las. No momento, eu diria que temos cerca de 80% disso implementado. Mas alguns ainda estão comendo cactos.
E é lá (no slide) que começa a emergir lentamente o "SLA para entrega de logs". Ele ainda não existe, mas estamos trabalhando nisso. Porque é muito conveniente quando a infraestrutura diz que, se você escrever em tal formato em tal lugar e não mais de N mensagens por segundo, então, temos uma certa probabilidade de entregá-las lá. Isso elimina uma grande dor de cabeça. Se o SLA existir, será simplesmente maravilhoso!
Como começamos a resolver o problema? A principal dificuldade estava com o td-agent. Não estava claro onde nossos logs estavam indo. Eles estão sendo entregues? Estão sendo coletados? Onde estão, afinal? Portanto, o primeiro ponto foi decidir substituir o td-agent. As opções para substituí-lo, de forma resumida, eu esbocei aqui.
Fluentd. Em primeiro lugar, trabalhei com ele no emprego anterior, e ele também apresentava quedas periódicas lá. Em segundo lugar, é quase a mesma coisa, só que mais focada.
Filebeat. O que o tornava conveniente para nós? O fato de ser escrito em Go, e nós temos uma grande expertise em Go. Assim, se necessário, poderíamos adaptá-lo para nossas necessidades. Portanto, decidimos não adotá-lo. Para não haver sequer a tentação de começar a reescrevê-lo para nós.
A solução óbvia para um administrador de sistemas permanece ser usar vários syslogs em tal quantidade (syslog-ng/rsyslog/nxlog).
Ou então escrever algo próprio, mas descartamos isso, assim como o Filebeat. Se vamos escrever algo, é melhor que seja algo útil para o negócio. Para entrega de logs, é melhor optar por algo já pronto.
Portanto, a escolha basicamente se reduziu a escolher entre syslog-ng e rsyslog. Optei pelo rsyslog simplesmente porque já tínhamos classes para rsyslog no Puppet, e não encontrei uma diferença óbvia entre eles. Onde diz syslog aqui, diz syslog ali. Sim, a documentação de alguns é pior, a de outros é melhor. Um faz de um jeito, e o outro faz de outro.
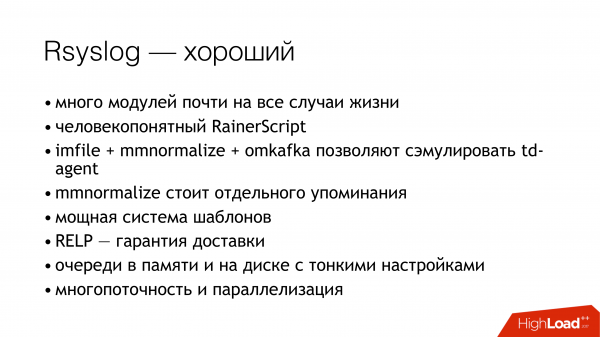
E um pouco sobre o rsyslog. Primeiro, ele é excelente, porque possui muitos módulos. Tem uma linguagem de configuração intuitiva chamada RainerScript. Um grande bônus é que conseguimos simular o comportamento do td-agent com ferramentas padrão, e para os aplicativos, nada mudou. Ou seja, estamos trocando o td-agent pelo rsyslog, e tudo o mais permanecemos intacto. E instantaneamente obtemos a entrega funcionando. Além disso, o mmnormalize é uma ferramenta incrível no rsyslog. Ela permite fazer o parsing de logs, mas não usando Grok e regexp. Ela cria uma árvore de sintaxe abstrata. Ela faz o parsing dos logs de forma semelhante a como um compilador analisa o código fonte. Isso permite que funcione muito rapidamente, consuma pouco CPU e, de fato, é algo muito legal. Há muitos outros bônus. Não vou entrar em detalhes sobre eles.
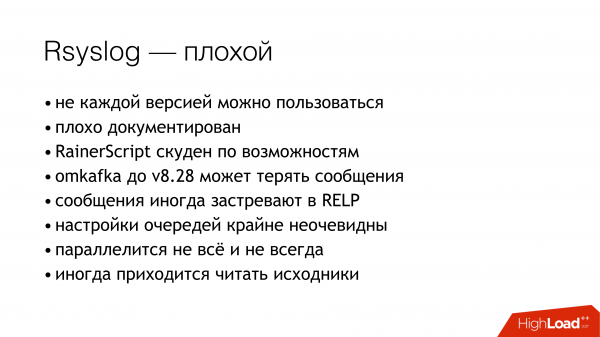
O rsyslog também possui vários pontos negativos. Eles são mais ou menos como os bônus. Os principais problemas são: é necessário saber como configurá-lo e escolher a versão correta.
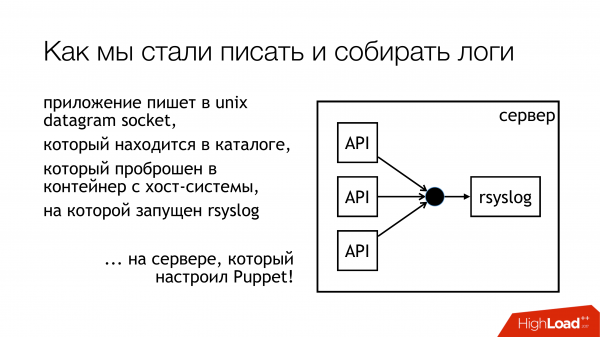
Decidimos que escreveríamos logs em socket unix. E não em /dev/log, porque ali temos uma confusão de logs do sistema, com o journald nesse pipeline. Portanto, vamos escrever em um socket personalizado. Vamos conectá-lo a um conjunto de regras separado. Não vamos misturar nada. Tudo será transparente e claro. E foi exatamente isso que fizemos. O diretório com esses sockets é padronizado e é repassado para todos os containers. Os containers podem ver o socket necessário, abri-lo e escrever nele.
Por que não um arquivo? Porque todos leram , que tentava redirecionar um arquivo no docker, e descobria-se que, após o reinício do rsyslog, o descritor de arquivo mudava, e o docker perdia esse arquivo. Ele mantinha algo diferente aberto, mas já não era aquele socket para o qual se escreve. Decidimos que iríamos contornar esse problema e, ao mesmo tempo, evitar o problema do bloqueio.
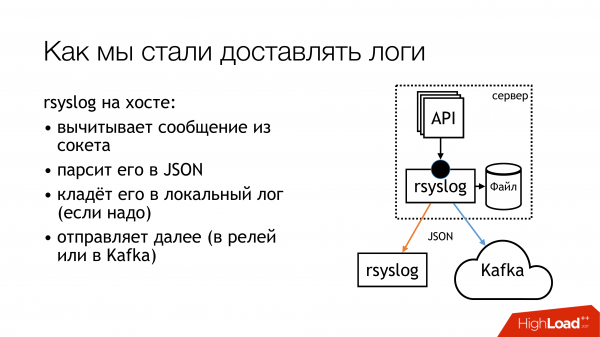
O rsyslog realiza as ações indicadas no slide e envia os logs ou para o relay ou para o Kafka. O Kafka corresponde ao método antigo. O relay — eu procurei usar exclusivamente o rsyslog para a entrega de logs. Sem Message Queue, utilizando ferramentas padrão do rsyslog. Em princípio, isso funciona.
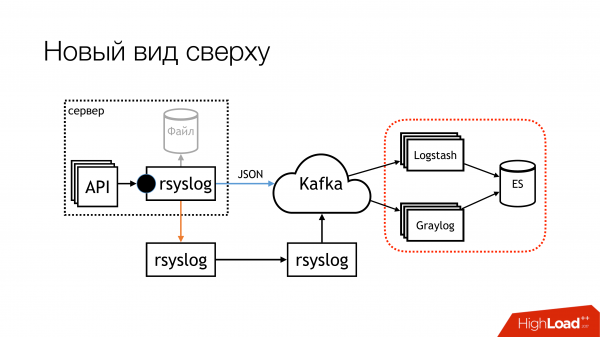
Mas há detalhes sobre como inseri-los nessa parte (Logstash/Graylog/ES). Esta parte (rsyslog-rsyslog) é utilizada entre os data centers. Aqui, há um link TCP comprimido, que permite economizar largura de banda e, assim, aumentar a probabilidade de recebemos registros de outro data center em condições em que o canal está congestionado. Porque temos a Indonésia, onde a situação é complicada. Lá é um problema constante.
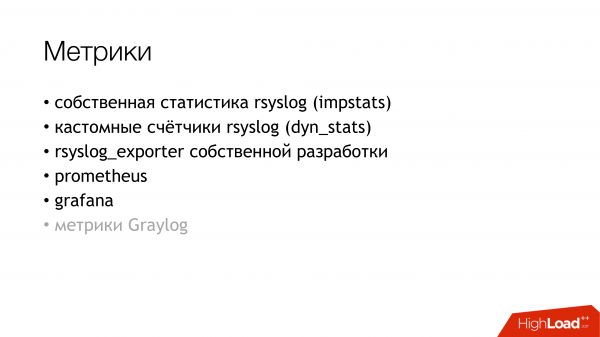
Começamos a pensar em como monitorar a probabilidade de os logs que registramos a partir do aplicativo chegarem ao seu destino. Decidimos estabelecer métricas. O rsyslog tem seu próprio módulo de coleta de estatísticas, que possui alguns contadores. Por exemplo, pode mostrar o tamanho da fila ou quantas mensagens chegaram em uma determinada ação. A partir disso, já é possível tirar algumas conclusões. Além disso, ele possui contadores personalizados que podem ser configurados, e mostrará, por exemplo, o número de mensagens registradas por alguma API. Em seguida, escrevi o rsyslog_exporter em Python, e enviamos tudo isso para o Prometheus e construímos gráficos. As métricas do Graylog eram muito desejadas, mas ainda não conseguimos configurá-las.
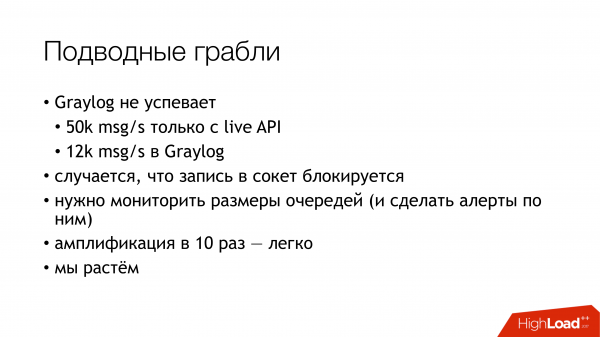
Quais problemas surgiram? Surgiram problemas com o fato de que descobrimos (SURPREENDENTEMENTE!) que nossas APIs Live enviam 50 mil mensagens por segundo. Isso apenas das APIs Live, sem contar o staging. E o Graylog nos mostra apenas 12 mil mensagens por segundo. E surgiu a pergunta válida, onde estão os restantes? Daí concluímos que o Graylog simplesmente não estava dando conta. Observamos, e realmente, o Graylog com Elasticsearch não dava conta desse fluxo.
Além disso, outras descobertas que fizemos durante o processo.
A gravação no socket fica bloqueada. Como isso aconteceu? Quando usei o rsyslog para entrega, em algum momento, nosso canal entre os data centers falhou. A entrega parou em um lugar, e parou em outro. Tudo isso chegou à máquina com a API, que escreve no socket do rsyslog. A fila encheu. Depois, a fila para escrita no unix socket, que por padrão é de 128 pacotes, também encheu. E a próxima write() na aplicação fica bloqueada. Quando olhamos na biblioteca que usamos nas aplicações em Go, estava escrito que a gravação no socket ocorre em modo não bloqueante. Estávamos certos de que nada estava bloqueando. Porque nós lemos. , que escreveu sobre isso. Mas há um detalhe. Ao redor dessa chamada havia um ciclo infinito, onde havia constantes tentativas de empurrar a mensagem para o socket. Isso não notamos. Foi necessário reescrever a biblioteca. Desde então, ela mudou várias vezes, mas agora nos livramos de bloqueios em todos os subsistemas. Portanto, podemos parar o rsyslog, e nada vai cair.
É preciso monitorar o tamanho das filas, o que ajuda a evitar esses erros. Primeiro, podemos monitorar quando começamos a perder mensagens. Em segundo lugar, podemos monitorar se estamos tendo problemas na entrega.
E mais um ponto desagradável — a amplificação em 10 vezes na arquitetura de microsserviços — isso é muito fácil. Não temos tantas requisições de entrada, mas devido ao grafo pelo qual as mensagens se movem, por causa dos logs de acesso, realmente aumentamos a carga dos logs em cerca de dez vezes. Infelizmente, não consegui contar os números exatos, mas os microsserviços são assim. É algo a se ter em mente. Atualmente, o subsistema de coleta de logs é o mais sobrecarregado na Lazada.
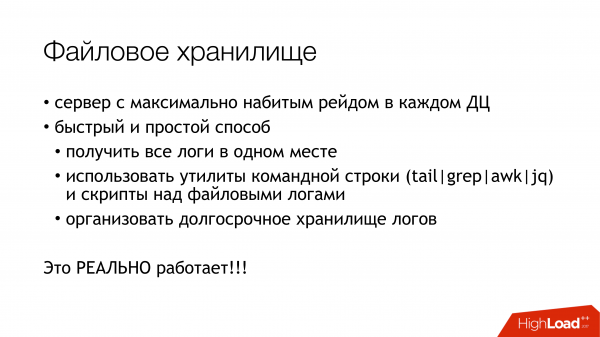
Como resolver o problema do elasticsearch? Se você precisa rapidamente obter logs em um só lugar, para não ter que correr por todas as máquinas e coletá-los, use um armazenamento de arquivos. Isso funciona garantidamente. Pode ser feito a partir de qualquer servidor. Basta instalar discos lá e configurar o syslog. Depois disso, todos os logs estarão garantidamente em um só lugar. A partir daí, você pode configurar o elasticsearch, graylog ou outra coisa no seu próprio ritmo. Mas você já terá todos os logs e, além disso, poderá armazená-los conforme a capacidade dos arrays de discos.
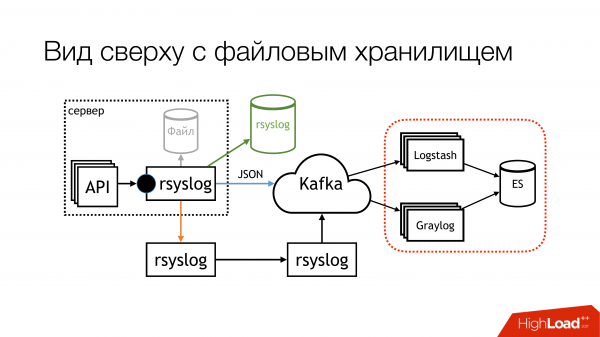
No momento da minha apresentação, o esquema ficou assim. Praticamente paramos de escrever em arquivos. Agora, provavelmente, desligaremos os restos. Em máquinas locais, onde as APIs estão em execução, não escreveremos mais em arquivos. Primeiro, há um armazenamento de arquivos que funciona muito bem. Em segundo lugar, nessas máquinas, o espaço acaba constantemente, é preciso monitorá-lo incessantemente.
Essa parte com Logstash e Graylog realmente está dando dor de cabeça. Portanto, precisamos nos livrar dela. É necessário escolher uma das duas.
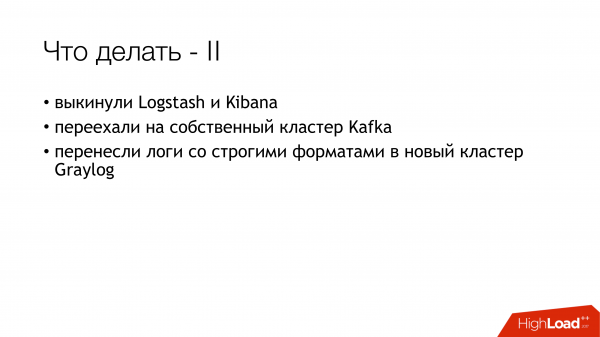
Decidimos descartar o Logstash e o Kibana. Porque temos um departamento de segurança. Qual é a relação? A relação é que o Kibana sem X-Pack e sem Shield não permite delimitar os direitos de acesso aos logs. Portanto, optamos pelo Graylog. Ele não me agrada, mas funciona. Compramos novo hardware, instalamos o Graylog lá e transferimos todos os logs com formatos rígidos para um Graylog separado. Resolvemos o problema com diferentes tipos de campos iguais de maneira organizacional.
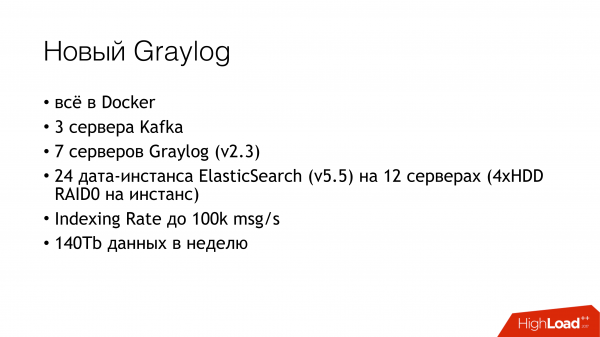
O que na verdade está incluído no novo Graylog. Simplesmente gravamos tudo no Docker. Pegamos um monte de servidores, implantamos três instâncias do Kafka, 7 servidores Graylog versão 2.3 (porque queríamos a versão 5 do Elasticsearch). Tudo isso foi levantado em RAID com HDDs. Vimos uma taxa de indexação de até 100 mil mensagens por segundo. Vimos o número que 140 terabytes de dados por semana.
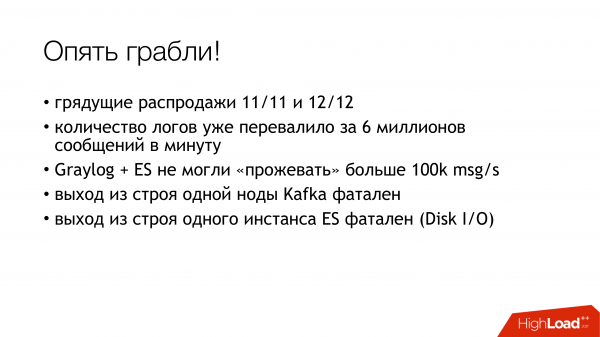
E mais uma vez, desafios! Temos duas vendas se aproximando. Nós transferimos 6 milhões de mensagens. Nosso Graylog não dá conta. De alguma forma, precisamos sobreviver novamente.
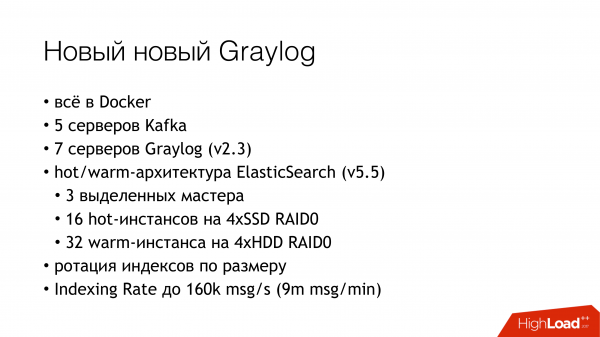
Sobrevivemos assim. Adicionamos mais alguns servidores e SSDs. No momento, estamos operando dessa maneira. Agora estamos processando 160 mil mensagens por segundo. Ainda não atingimos o limite, então ainda não está claro quanto realmente conseguiremos puxar disso.
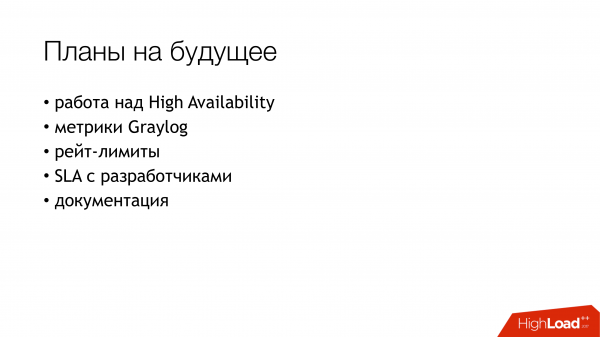
Aqui estão nossos planos para o futuro. Desses, o mais importante, provavelmente, é a alta disponibilidade. Neste momento, não a temos. Várias máquinas configuradas da mesma forma, mas tudo ainda passa por uma só máquina. Precisamos gastar tempo para configurar o failover entre elas.
Coletar métricas do Graylog.
Fazer um rate limit para que uma API, enlouquecida, não consuma nossa largura de banda e outras coisas.
E finalmente, assinar algum tipo de SLA com os desenvolvedores, informando que podemos suportar essa quantidade. Se vocês enviam mais, desculpem.
E escrever documentação.
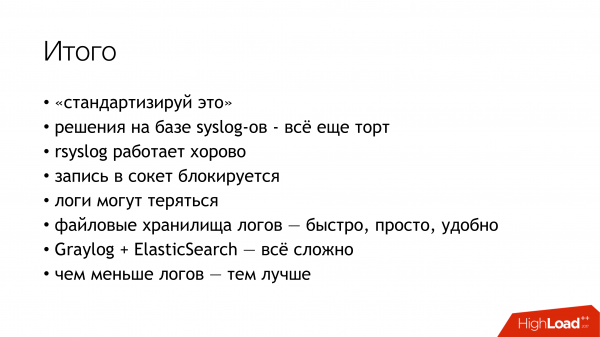
Resumindo, os resultados de tudo o que passamos. Primeiro, padrões. Em segundo lugar, syslog – é um prazer. Em terceiro lugar, o rsyslog funciona exatamente como está escrito no slide. E vamos para as perguntas.
Perguntas.
Pergunta: Por que decidiram não usar… (filebeat?)
Resposta: Precisamos gravar em um arquivo. Não queria fazer isso. Quando sua API grava milhares de mensagens por segundo, mesmo que você rotacione uma vez por hora, ainda assim não é uma opção. Pode-se gravar em pipe. Ao que os desenvolvedores me perguntaram: "E se o processo em que estamos gravando falhar"? Eu simplesmente não consegui encontrar o que responder e disse: "Bem, ok, vamos não fazer assim".
Pergunta: Por que você não escreve logs apenas no HDFS?
Resposta: Este é o próximo passo. Pensamos sobre isso no início, mas, como no momento não temos recursos para trabalhar nisso, permanece como uma solução a longo prazo.
Pergunta: O formato em coluna seria mais adequado.
Resposta: Eu entendo tudo. Estamos de acordo com isso.
Pergunta: Você escreve no rsyslog. É possível usar tanto TCP quanto UDP. Mas se for UDP, como você garante a entrega?
Resposta: Existem dois pontos. Primeiro, eu sempre digo a todos que não garantimos a entrega dos logs. Porque quando os desenvolvedores vêm e dizem: 'Vamos começar a escrever dados financeiros lá, e você os armazenará caso algo aconteça', nós respondemos: 'Ótimo! Vamos fazer com que você comece a bloquear a gravação no socket e a fazer isso em transações, para garantir que você nos coloque no socket e verifique se recebemos do outro lado.' E nesse momento, a maioria das pessoas logo perde o interesse. E se não há interesse, que perguntas temos? Se você não quer garantir a gravação no socket, por que nós deveríamos garantir a entrega? Nós fazemos o melhor que podemos. Realmente tentamos entregar o máximo possível e da melhor forma, mas não damos 100% de garantia. Portanto, não escreva dados financeiros lá. Para isso, temos bancos de dados com transações.
Pergunta: Quando a API gera uma mensagem no log e passa o controle para os microsserviços, você já encontrou o problema de que mensagens de diferentes microsserviços chegam na ordem errada? Isso causa confusão.
Resposta: É normal que elas cheguem em ordens diferentes. Você precisa estar preparado para isso. Porque qualquer entrega em rede não garante a ordem, ou você precisa gastar recursos especificamente para isso. Se pegarmos sistemas de armazenamento de arquivos, cada API salva logs em seu próprio arquivo. Na verdade, o rsyslog os organiza em diretórios. Cada API tem seus próprios logs, onde você pode ir e verificar, e depois, pelo timestamp nesse log, pode correlacioná-los. Se eles olharem no Graylog, lá eles estarão ordenados por timestamp. Tudo será bom.
Pergunta: O timestamp pode diferir em milissegundos.
Resposta: O timestamp é gerado pela própria API. Essa é, na verdade, toda a questão. Temos NTP. A API gera o timestamp já na própria mensagem. Não é o rsyslog que o adiciona.
Pergunta: Não está muito claro como ocorre a interação entre os data centers. No contexto de um data center, é compreensível como os logs foram coletados e processados. Como se dá a interação entre os data centers? Ou cada data center vive sua própria vida?
Resposta: Quase. Cada país está localizado em um único data center. No momento, não temos uma configuração distribuída onde um país esteja alocado em diferentes data centers. Portanto, não é necessário integrá-los. Dentro de cada centro, existe um Log Relay. É um servidor Rsyslog. Na verdade, são duas máquinas de gerenciamento. Elas estão configuradas da mesma forma. Mas, por enquanto, o tráfego está passando por apenas uma delas. Ela agrega todos os logs. Possui uma fila em disco para precauções. Ela comprime os logs e os envia para o data center central (em Singapura), de onde são enviados para o Graylog. E em cada data center há seu próprio armazenamento de arquivos. Caso ocorra uma perda de conexão, ainda temos todos os logs lá. Eles permanecerão lá. Eles serão salvos.
Pergunta: Em situações incomuns, você recebe logs de lá?
Resposta: É possível ir até lá (no armazenamento de arquivos) e verificar.
Pergunta: Como vocês monitoram para garantir que não estão perdendo logs?
Resposta: Na verdade, nós os perdemos, e estamos monitorando isso. Iniciamos o monitoramento há um mês. Na biblioteca utilizada pelo Go API, há métricas. Ela consegue contar quantas vezes não conseguiu gravar no socket. Atualmente, existe uma heurística inteligente. Há um buffer. Ele tenta gravar a mensagem no socket a partir dele. Se o buffer ficar cheio, ele começa a descartar mensagens. E conta quantas ele descartou. Se os contadores começarem a se encher, ficamos sabendo. Os dados chegam também ao Prometheus, e os gráficos podem ser visualizados no Grafana. É possível configurar alertas. Mas, por enquanto, não está claro para quem enviá-los.
Pergunta: No Elasticsearch, vocês armazenam logs com redundância. Quantas réplicas vocês têm?
Resposta: Uma réplica.
Pergunta: Isso é apenas uma réplica?
Resposta: É um mestre e uma réplica. Os dados são armazenados em duas instâncias.
Pergunta: Você fez algum ajuste no tamanho do buffer do rsyslog?
Resposta: Escrevemos datagramas em um socket unix personalizado. Isso imediatamente nos impõe um limite de 128 kilobytes. Não podemos escrever mais do que isso. Estipulamos isso no padrão. Quem quiser entrar nos storages deve escrever 128 kilobytes. As bibliotecas, por sua vez, truncam e marcam a mensagem como truncada. Nosso padrão de mensagem possui um campo especial que indica se foi truncada durante a gravação ou não. Assim, temos a oportunidade de rastrear esse aspecto.
Pergunta: Você está escrevendo JSON corrompido?
Resposta: JSON corrompido será descartado durante o relay, porque é um pacote muito grande. Ou será descartado pelo Graylog, pois não poderá fazer o parsing do JSON. Mas existem nuances que precisam ser corrigidas, e a maior parte delas está relacionada ao rsyslog. Já abri algumas issues lá que ainda precisam de trabalho.
Pergunta: Por que Kafka? Você já experimentou o RabbitMQ? O Graylog não se ajusta a essas cargas?
Resposta: Não conseguimos nos conectar com o Graylog. Mas o Graylog funciona para nós. É realmente problemático. É uma coisa peculiar. E, na verdade, não é necessário. Eu preferiria escrever diretamente do rsyslog para o Elasticsearch e depois visualizar no Kibana. Mas precisamos resolver essa questão com os seguranças. Essa é uma possível direção para nosso desenvolvimento, quando descartaremos o Graylog e utilizaremos o Kibana. Não faria sentido usar o Logstash. Porque eu posso fazer tudo isso com o rsyslog. E ele possui um módulo para gravação no Elasticsearch. Estamos tentando conviver com o Graylog. Até fizemos algumas melhorias. Mas ainda há espaço para melhorias.
Sobre o Kafka. Assim aconteceu historicamente. Quando cheguei, já existia e já eram registrados logs nele. Nós apenas configuramos nosso cluster e transferimos os logs para lá. Nós o gerenciamos, sabemos como ele está. Sobre o RabbitMQ... não estamos indo bem com o RabbitMQ. Mas temos o RabbitMQ funcionando. Ele está em produção e tivemos problemas com ele. Agora, antes da liquidação, ele foi ajustado e começou a funcionar bem. Mas antes disso, eu não estava pronto para colocá-lo em produção. Há ainda outro ponto. O Graylog consegue ler a versão AMQP 0.9, enquanto o rsyslog consegue escrever na versão AMQP 1.0. E não há uma única solução que consiga fazer as duas coisas. Há ou uma coisa ou outra. Portanto, por enquanto, fica somente com Kafka. Mas isso também tem suas nuances. Porque o omkafka, na versão do rsyslog que estamos usando, pode perder todo o buffer de mensagens que ele retirou do rsyslog. Por enquanto, estamos lidando com isso.
Pergunta: Você usa o Kafka porque ele já estava aí? Não é usado para mais nada?
Resposta: O Kafka que existia é usado pela equipe de Data Science. É um projeto completamente separado, sobre o qual, infelizmente, não posso dizer nada. Não estou a par. Ele estava sob a responsabilidade da equipe de Data Science. Quando foram registrados os logs, decidiram utilizá-lo para não precisar instalar o seu próprio. Agora, atualizamos o Graylog e perdemos a compatibilidade, porque há uma versão antiga do Kafka. Precisamos configurar o nosso próprio. De quebra, nos livramos desses quatro tópicos por cada API. Fizemos um tópico amplo para todos os ambientes de produção, um outro tópico amplo para todos os ambientes de testes e apenas jogamos tudo lá. O Graylog extrai tudo isso em paralelo.
Pergunta: Por que essa malandragem com os sockets? Vocês tentaram usar o driver de log syslog para contêineres?
Resposta: Na época em que estávamos lidando com essa questão, nosso relacionamento com o Docker era tenso. Era o Docker 1.0 ou 0.9. O Docker em si era peculiar. Em segundo lugar, se você ainda tentar inserir logs nele... Tenho uma suspeita não confirmada de que ele passa todos os logs por ele mesmo, através do daemon do Docker. Se uma API entra em pane, as outras APIs ficam travadas porque não conseguem enviar stdout e stderr. Não sei a que isso levará. Tenho uma suspeita intuitiva de que não devemos usar o driver syslog do Docker neste ponto. Nosso departamento de testes funcionais tem seu próprio cluster Graylog com logs. Eles usam os drivers de log do Docker e parece que está tudo funcionando bem. Mas eles escrevem diretamente em Graylog usando GELF. Quando começamos tudo isso, precisávamos que funcionasse. Pode ser que mais tarde, quando alguém disser que já está funcionando bem há muito tempo, possamos tentar de novo.
Pergunta: Vocês fazem a entrega entre data centers usando rsyslog. Por que não usar Kafka?
Resposta: Estamos fazendo os dois, na verdade, por duas razões. Se a conexão estiver completamente ruim, todos os nossos logs, mesmo compactados, não conseguem passar. E o Kafka permite que eles sejam simplesmente descartados durante o processo. Dessa forma, evitemos o entupimento desses logs. Usamos o Kafka diretamente nesse caso. Se nossa conexão estiver boa e quisermos liberá-la, usamos o rsyslog. Mas na verdade podemos configurá-lo para que ele mesmo descarte o que não passou. Neste momento, usamos a entrega do rsyslog diretamente em alguns lugares e o Kafka em outros.
Fonte: habr.com
