

Ao migrar de uma aplicação monolítica para uma arquitetura de microserviços, enfrentamos novos desafios.
Em uma aplicação monolítica, geralmente é suficiente identificar em qual parte do sistema ocorreu um erro. Provavelmente, o problema está no próprio código do monólito ou no banco de dados. Mas quando começamos a investigar problemas em uma arquitetura de microserviços, as coisas já não são tão evidentes. É necessário rastrear todo o caminho que a solicitação percorreu do início ao fim, isolando-o entre centenas de microserviços. Além disso, muitos deles ainda possuem seus próprios repositórios, onde podem surgir tanto erros lógicos quanto problemas de desempenho e resiliência.
Procurei por muito tempo uma ferramenta que me ajudasse a lidar com tais problemas (escrevi sobre isso no Habr: , ), mas acabei criando minha própria solução open source. Neste artigo, compartilho as vantagens da abordagem service mesh e apresento uma nova ferramenta para sua implementação.
O tracing distribuído é uma solução comum para o problema de localização de erros em sistemas distribuídos. Mas e se a abordagem de coleta de informações sobre interações de rede ainda não foi implementada no sistema, ou, pior ainda, em uma parte do sistema funciona adequadamente, mas em outra ela não foi adicionada aos serviços antigos? Para identificar a verdadeira causa raiz do problema, é necessário ter uma visão completa do que está acontecendo no sistema. É especialmente importante entender quais microserviços estão envolvidos nos principais caminhos críticos para o negócio.
Aqui, a abordagem de service mesh pode nos ajudar, pois cuida de toda a maquinaria de coleta de informações de rede em um nível inferior ao funcionamento dos próprios serviços. Essa abordagem nos permite interceptar todo o tráfego e analisá-lo em tempo real. Além disso, os aplicativos não precisam saber nada sobre isso.
Abordagem de service mesh
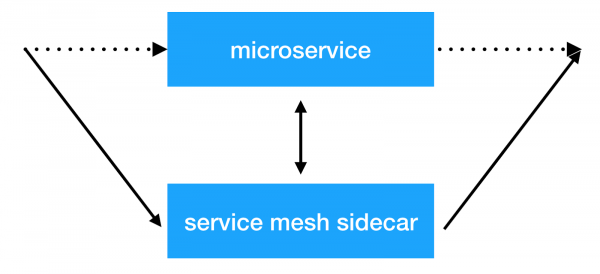
A principal ideia da abordagem service mesh é adicionar mais uma camada de infraestrutura sobre a rede, que nos permitirá realizar qualquer operação com a interação entre serviços. A maioria das implementações funciona da seguinte maneira: a cada microserviço, é adicionado um contêiner sidecar com um proxy transparente, pelo qual todo o tráfego de entrada e saída do serviço é direcionado. E é exatamente aqui que podemos realizar balanceamento de carga do cliente, aplicar políticas de segurança, impor limitações na quantidade de requisições e coletar informações importantes sobre a interação dos serviços em produção.
Soluções
Já existem várias implementações dessa abordagem: e . Elas fornecem muitas funcionalidades prontas para uso. No entanto, isso também traz um grande overhead em recursos. Quanto maior o cluster onde esse sistema opera, mais recursos serão necessários para manter a nova infraestrutura. No Avito, utilizamos clusters Kubernetes que contêm milhares de instâncias de serviços (e esse número continua a crescer rapidamente). Na implementação atual, o Istio consome cerca de 300 MB de memória RAM para cada instância de serviço. Devido à grande quantidade de funcionalidades, o balanceamento transparente também impacta o tempo de resposta total dos serviços (até 10 ms).
Como resultado, analisamos quais funcionalidades realmente precisamos agora e decidimos que a principal razão pela qual começamos a implementar essas soluções era a capacidade de coletar informações de rastreamento de todo o sistema de forma transparente. Também queríamos ter controle sobre a interação entre serviços e realizar diferentes manipulações com os cabeçalhos que são transmitidos entre os serviços.
Assim, chegamos à nossa solução: .
Netramesh
— é uma solução de service mesh leve com escalabilidade infinita, independentemente do número de serviços no sistema.
Os principais objetivos da nova solução eram um pequeno overhead em recursos e alta performance. Entre as principais funcionalidades, queríamos poder enviar spans de rastreamento para o nosso sistema Jaeger de forma transparente desde o início.
Hoje, a maioria das soluções em nuvem é implementada em Golang. E, claro, isso tem suas razões. Escrever aplicações de rede em Golang, que funcionam de forma assíncrona com entrada e saída e se escalam conforme necessário para os núcleos, é conveniente e bastante simples. E, o que também é muito importante, o desempenho é suficiente para resolver essa tarefa. Portanto, nós também escolhemos Golang.
Desempenho
Focamos nossos esforços em alcançar o desempenho máximo. Para uma solução que é implantada próxima a cada instância do serviço, é necessário um baixo consumo de memória RAM e tempo de CPU. E, claro, a latência de resposta também deve ser a menor possível.
Vamos ver quais resultados obtivemos.
RAM
O Netramesh consome ~10Mb sem tráfego e 50Mb no máximo com carga de até 10000 RPS em uma única instância.
O proxy Istio envoy consome sempre ~300Mb em nossos clusters com milhares de instâncias. Isso não permite escalá-lo para todo o cluster.
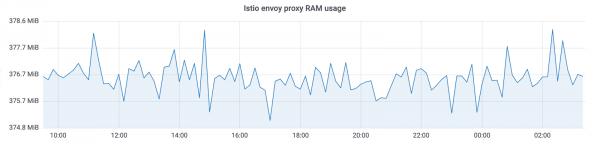
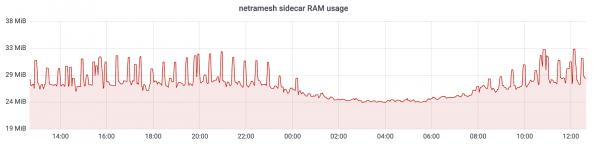
Com o Netramesh, conseguimos uma redução no consumo de memória de ~10 vezes.
CPU
O uso de CPU é relativamente igual sob carga. Depende da quantidade de requisições por unidade de tempo ao sidecar. Os valores em 3000 requisições por segundo no pico são:
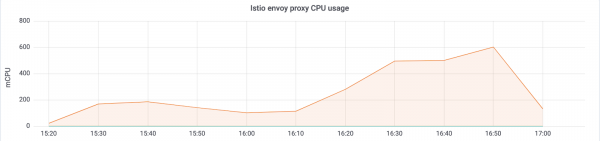
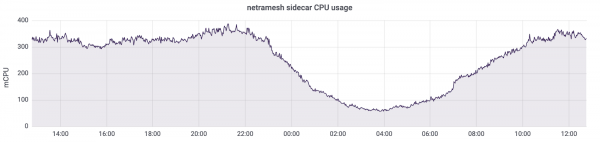
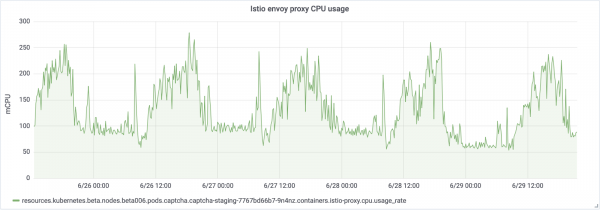
Há outro ponto importante: o Netramesh é uma solução sem plano de controle e, sem carga, não consome tempo de CPU. Com Istio, os sidecars sempre atualizam os endpoints dos serviços. No final, podemos ver essa situação sem carga:
Usamos HTTP/1 para a interação entre os serviços. O aumento do tempo de resposta do Istio ao ser proxyado através do envoy era de até 5-10ms, o que é bastante para serviços que estão prontos para responder em milissegundos. Com o Netramesh, esse tempo foi reduzido para 0,5-2ms.
Escalabilidade
A pequena quantidade de recursos gastos por cada proxy permite colocá-lo próximo a cada serviço. O Netramesh foi intencionalmente criado sem componente de plano de controle para manter a leveza de cada sidecar. Frequentemente, em soluções de service mesh, o plano de controle espalha informações de descoberta de serviço para cada sidecar. Juntamente com isso, também vem informações sobre timeouts e configurações de balanceamento. Tudo isso permite fazer muitas coisas úteis, mas, infelizmente, incham os sidecars em tamanho.
Descoberta de serviço

O Netramesh não adiciona quaisquer mecanismos adicionais para a descoberta de serviços. Todo o tráfego é proxyado de forma transparente através do sidecar netra.
Netramesh suporta o protocolo de aplicação HTTP/1. Para sua definição, é utilizada uma lista de portas configurável. Normalmente, há várias portas no sistema que lidam com a comunicação via HTTP. Por exemplo, usamos 80, 8890 e 8080 para a interação entre serviços e solicitações externas. Nesse caso, elas podem ser configuradas através de uma variável de ambiente. NETRA_HTTP_PORTS.
Se você estiver usando Kubernetes como orquestrador e seu mecanismo de entidades Service para a interação entre serviços dentro do cluster, o mecanismo permanece exatamente o mesmo. Primeiro, o microserviço obtém o endereço IP do serviço usando kube-dns e estabelece uma nova conexão com ele. Esta conexão é inicialmente feita com o netra-sidecar e todos os pacotes TCP chegam primeiramente ao netra. Em seguida, o netra-sidecar estabelece a conexão com o destino original. O NAT no IP do pod no nó permanece exatamente o mesmo que sem o netra.
Rastreamento distribuído e passando o contexto
O Netramesh oferece a funcionalidade necessária para enviar spans de rastreamento sobre a interação HTTP. O netra-sidecar analisa o protocolo HTTP, mede a latência das solicitações e extrai as informações necessárias dos cabeçalhos HTTP. No final, obtemos todos os rastros em um sistema Jaeger unificado. Para uma configuração mais refinada, também é possível usar variáveis de ambiente fornecidas pela biblioteca oficial. .
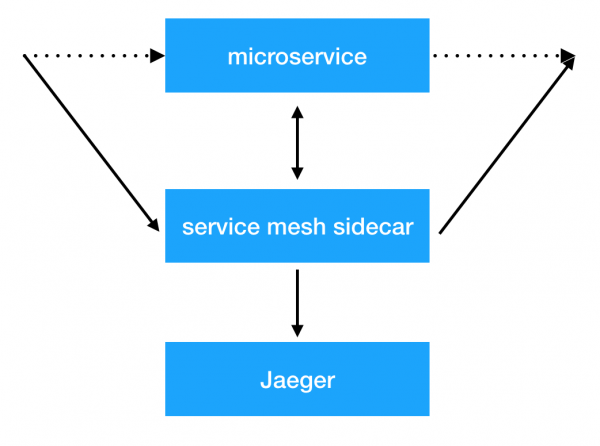
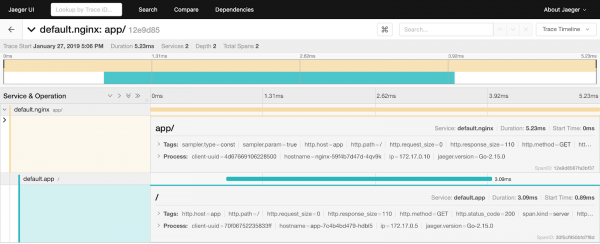
Mas há um problema. Enquanto os serviços não gerarem e passarem um cabeçalho uber específico, não veremos os spans de rastreamento conectados no sistema. E isso é necessário para localizar rapidamente as causas dos problemas. Aqui, o Netramesh novamente tem uma solução. O proxy lê os cabeçalhos HTTP e, se não houver um uber trace id, ele o gera. O Netramesh também armazena informações sobre solicitações de entrada e saída no sidecar e as relaciona enriquecendo os cabeçalhos necessários das solicitações de saída. Tudo o que precisa ser feito nos serviços é passar apenas um cabeçalho. X-Request-Id, que pode ser configurado através de uma variável de ambiente. NETRA_HTTP_REQUEST_ID_HEADER_NAME. Para gerenciar o tamanho do contexto no Netramesh, é possível definir as seguintes variáveis de ambiente: NETRA_TRACING_CONTEXT_EXPIRATION_MILLISECONDS (tempo durante o qual o contexto será mantido) e NETRA_TRACING_CONTEXT_CLEANUP_INTERVAL (frequência de limpeza do contexto).
Também é possível combinar vários caminhos no seu sistema, marcando-os com um marcador de sessão especial. O Netra permite configurar HTTP_HEADER_TAG_MAP para transformar cabeçalhos HTTP em tags correspondentes de rastreamento. Isso pode ser particularmente útil para testes. Após a conclusão de um teste funcional, é possível verificar qual parte do sistema foi afetada, filtrando pela chave de sessão correspondente.
Definição da fonte da solicitação
Para determinar de onde a solicitação veio, você pode utilizar a funcionalidade de adição automática de cabeçalho com a fonte. Com a variável de ambiente NETRA_HTTP_X_SOURCE_HEADER_NAME é possível definir o nome do cabeçalho que será automaticamente aplicado. Com NETRA_HTTP_X_SOURCE_VALUE é possível definir o valor que será atribuído ao cabeçalho X-Source em todas as solicitações de saída.
Isso permite a disseminação uniforme deste cabeçalho útil por toda a rede. Em seguida, você pode usá-lo em serviços e adicioná-lo aos logs e métricas.
Roteamento de tráfego e a estrutura interna do Netramesh
O Netramesh consiste em dois componentes principais. O primeiro, netra-init, estabelece regras de rede para interceptação de tráfego. Ele utiliza para interceptar todo ou parte do tráfego em um sidecar, que é o segundo componente principal do Netramesh. Você pode configurar quais portas devem ser interceptadas em sessões TCP de entrada e saída: INBOUND_INTERCEPT_PORTS, OUTBOUND_INTERCEPT_PORTS.
Além disso, a ferramenta possui uma capacidade interessante — roteamento probabilístico. Se você usar o Netramesh exclusivamente para coletar spans de rastreamento, é possível economizar recursos em um ambiente de produção, ativando o roteamento probabilístico usando as variáveis NETRA_INBOUND_PROBABILITY e NETRA_OUTBOUND_PROBABILITY (de 0 a 1). O valor padrão é 1 (todo o tráfego é interceptado).
Após uma interceptação bem-sucedida, o sidecar do netra aceita uma nova conexão e utiliza a SO_ORIGINAL_DST opção de soquete para obter o destino original. Em seguida, o Netra abre uma nova conexão para o IP original e estabelece uma comunicação TCP bidirecional entre as partes, ouvindo todo o tráfego que passa. Se a porta for definida como HTTP, o Netra tenta analisá-la e rastreá-la. Se a análise de HTTP falhar, o Netra faz um fallback para TCP e proxy transparentemente os bytes.
Construção do gráfico de dependências
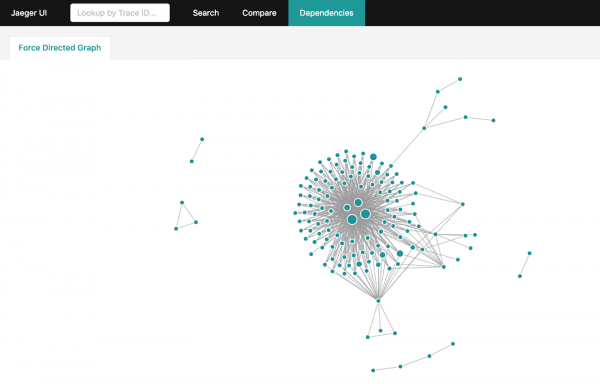
Após receber uma grande quantidade de informações de tracing no Jaeger, é desejável obter um gráfico completo de interações no sistema. Mas se seu sistema estiver bastante sobrecarregado e bilhões de spans de tracing se acumularem em um dia, a agregação deles se torna uma tarefa complexa. Existe um método oficial para isso: . No entanto, isso levará horas para construir o gráfico completo e exigirá extrair do Jaeger todo o conjunto de dados das últimas 24 horas.
Se você estiver usando Elasticsearch para armazenar spans de tracing, pode aproveitar , que construirá um gráfico semelhante em minutos, utilizando as características e capacidades do Elasticsearch.
Como usar o Netramesh
O Netra pode ser facilmente adicionado a qualquer serviço operando sob qualquer orquestrador. Você pode ver um exemplo .
Atualmente, o Netra não possui a capacidade de injeção automática de sidecar nos serviços, mas há planos para implementação.
O futuro do Netramesh
O principal objetivo é alcançar baixos custos de recursos e alta performance, oferecendo funcionalidades essenciais para observabilidade e controle da interação entre serviços.
No futuro, o Netramesh terá suporte a outros protocolos de camada de aplicação além do HTTP. Em breve, a capacidade de roteamento L7 estará disponível.
Utilize o Netramesh se você estiver enfrentando problemas semelhantes e envie-nos suas perguntas e sugestões.
Fonte: habr.com
