

tl;dr:
- A aprendizagem de máquina procura padrões nos dados. No entanto, a inteligência artificial pode ser 'tendenciosa' — ou seja, identificar padrões incorretos. Por exemplo, um sistema de detecção de câncer de pele a partir de fotografias pode prestar especial atenção às imagens tiradas em consultórios médicos. A aprendizagem de máquina não consegue compreender: seus algoritmos apenas detectam padrões em números, e se os dados não forem representativos, o resultado do seu processamento também será. E detectar esses erros pode ser complicado devido à própria mecânica da aprendizagem de máquina.
- A área problemática mais evidente e inquietante é a diversidade humana. Existem várias razões pelas quais os dados sobre pessoas podem perder a objetividade desde a coleta. Mas não devemos pensar que esse problema se limita apenas a pessoas: dificuldades semelhantes surgem ao tentar detectar uma inundação em um armazém ou uma turbina a gás com falha. Alguns sistemas podem ter preconceitos em relação à cor da pele, enquanto outros terão uma visão tendenciosa em relação a sensores da Siemens.
- Esses problemas não são novos para a aprendizagem de máquina, e não são exclusivos dela. Suposições errôneas são feitas em qualquer estrutura complexa, e entender por que uma determinada decisão foi tomada é sempre desafiador. É necessário combater isso de maneira abrangente: criando ferramentas e processos para verificação — e educando os usuários para que não sigam cegamente as recomendações da IA. A aprendizagem de máquina realmente faz algumas coisas muito melhor do que nós, — mas os cães, por exemplo, são muito mais eficazes do que as pessoas na detecção de drogas, o que não é justificativa para usá-los como testemunhas e proferir condenações com base em seus testemunhos. E os cães, por sua vez, são muito mais inteligentes do que qualquer sistema de aprendizagem de máquina.
A aprendizagem de máquina hoje é uma das tendências tecnológicas fundamentais mais importantes. É uma das principais maneiras pelas quais a tecnologia mudará o mundo nas próximas décadas. Alguns aspectos dessas mudanças são preocupantes. Por exemplo, o impacto potencial da aprendizagem de máquina no mercado de trabalho, ou seu uso para fins antiéticos (por regimes autoritários, por exemplo). Há outro problema, que é o foco deste post: tendência da inteligência artificial.
Esta não é uma história simples.
A IA do Google consegue encontrar gatinhos. Essa notícia de 2012 foi algo especial na época.
O que é "preconceito na IA"?
"Dados brutos" são ao mesmo tempo um oxímoro e uma má ideia; os dados precisam ser bem preparados e tratados com cuidado. —Jeffrey Boker
Até cerca de 2013, para criar um sistema que, digamos, reconhecesse gatos em fotos, você precisava descrever os passos lógicos. Como encontrar ângulos na imagem, reconhecer olhos, analisar texturas para identificar pelo, contar patas, e assim por diante. Depois, juntar todos os componentes — e descobrir que, na verdade, não funciona muito bem. Aproximadamente como um cavalo mecânico — teoricamente você pode construí-lo, mas na prática é muito complicado de descrever. No final, você tem centenas (ou até milhares) de regras escritas à mão. E nenhuma modelo funcionando.
Com o surgimento do aprendizado de máquina, paramos de usar regras "manuais" para reconhecer determinado objeto. Em vez disso, pegamos mil amostras de "aquilo", X, mil amostras de "outro", Y, e fazemos o computador construir um modelo com base na análise estatística deles. Então, damos a esse modelo um exemplo de dados, e ele, com alguma precisão, determina se se encaixa em um dos conjuntos. O aprendizado de máquina gera um modelo com base nos dados, e não por um ser humano que o escreve. Os resultados são impressionantes, especialmente na área de reconhecimento de imagens e padrões, e é por isso que toda a indústria de tecnologia está atualmente migrando para aprendizado de máquina (ML).
Mas nem tudo é tão simples. No mundo real, suas milhares de amostras X ou Y também contêm A, B, J, L, O, R e até mesmo L. Elas podem estar distribuídas de maneira desigual, e algumas podem ocorrer com tanta frequência que o sistema presta mais atenção a elas do que aos objetos que realmente interessam.
O que isso significa na prática? Meu exemplo favorito é quando os sistemas de reconhecimento de imagens . É fácil entender o porquê: a maior parte das fotos-exemplo de "ovelhas" foi tirada em campos onde elas vivem, e nessas imagens a grama ocupa muito mais espaço do que os pequenos peludos branquíssimos, e é a grama que os sistemas consideram mais importante.
Há exemplos ainda mais sérios. Recentemente, um sobre a detecção de câncer de pele em fotografias. Descobriu-se que os dermatologistas frequentemente fotografam uma régua junto com as manifestações do câncer de pele para registrar o tamanho das lesões. Nas fotografias de pele saudável, não existem réguas. Para o sistema de IA, essas réguas (mais precisamente, os pixels que definimos como "régua") tornaram-se uma das diferenças entre os conjuntos de exemplos, e às vezes mais importantes do que uma pequena erupção na pele. Assim, o sistema criado para reconhecer o câncer de pele, às vezes, reconhecia a régua em vez dele.
O ponto-chave aqui é que o sistema não possui compreensão semântica do que está observando. Nós olhamos para um conjunto de pixels e vemos nele uma ovelha, pele ou réguas, enquanto o sistema vê apenas uma sequência numérica. Ele não vê o espaço tridimensional, não percebe objetos, texturas ou ovelhas. Ele simplesmente vê padrões nos dados.
A dificuldade no diagnóstico de tais problemas é que a rede neural (modelo gerado pelo seu sistema de aprendizagem de máquina) consiste em milhares de nós. Não há uma maneira simples de olhar para o modelo e ver como ele toma decisões. Ter essa forma de olhar significaria que o processo é simples o suficiente para descrever todas as regras manualmente, sem o uso de aprendizagem de máquina. As pessoas se preocupam que a aprendizagem de máquina se tornou uma espécie de "caixa-preta". (Explicarei mais tarde por que essa comparação é um exagero.)
Esta, em termos gerais, é a questão da viés na inteligência artificial ou na aprendizagem de máquina: o sistema que busca padrões nos dados pode encontrar padrões incorretos, e você pode não perceber isso. Esta é uma característica fundamental da tecnologia, e é algo que é evidente para todos que trabalham com ela em círculos acadêmicos e em grandes empresas de tecnologia. Mas suas consequências são complexas, e nossas possíveis soluções para essas consequências também são.
Vamos primeiro falar sobre as consequências.
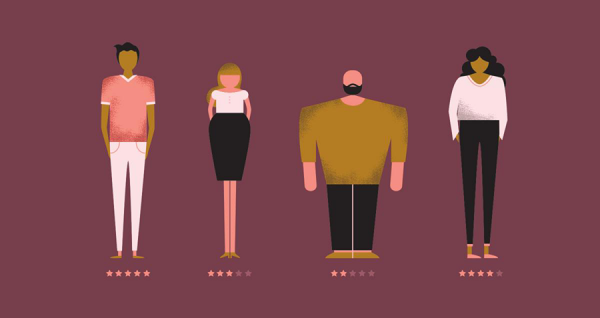
A IA pode implicitamente fazer escolhas a favor de determinadas categorias de pessoas, com base em um grande número de sinais sutis.
Cenários de viés da IA.
A coisa mais óbvia e assustadora é que este problema pode se manifestar quando se trata da diversidade humana. Recentemente, , que a Amazon tentou construir um sistema de aprendizado de máquina para triagem inicial de candidatos a emprego. Como entre os funcionários da Amazon há mais homens, os exemplos de “contratação bem-sucedida” também eram predominantemente masculinos, e na seleção de currículos apresentada pelo sistema havia mais homens. A Amazon percebeu isso e decidiu não colocar o sistema em produção.
O mais importante neste exemplo é que o sistema, segundo rumores, favorecia candidatos do sexo masculino, mesmo que o gênero não estivesse especificado no currículo. O sistema identificava outros padrões nos exemplos de “contratação bem-sucedida”: por exemplo, mulheres podem usar palavras específicas para descrever conquistas, ou ter hobbies distintos. Claro, o sistema não sabia o que era “hóquei”, quem eram os “homens”, ou o que significava “sucesso” — ele simplesmente realizava uma análise estatística do texto. Mas os padrões que ele identificava provavelmente ficariam despercebidos por um humano, e alguns deles (como o fato de que pessoas de diferentes gêneros descrevem o sucesso de maneiras diferentes) provavelmente seriam difíceis de reconhecer, mesmo ao observá-los.
E a situação piora. Um sistema de aprendizado de máquina que detecta câncer muito bem em pele clara pode ter um desempenho inferior em pele escura, ou vice-versa. Não necessariamente por preconceito, mas porque você provavelmente precisaria construir um modelo separado para a outra cor de pele, escolhendo outras características. Sistemas de aprendizado de máquina não são intercambiáveis, mesmo em um campo tão específico quanto o reconhecimento de imagens. Você precisa ajustar o sistema, às vezes apenas por meio de tentativas e erros, para captar bem as particularidades dos dados de seu interesse, até alcançar a precisão desejada. Mas você pode não perceber que o sistema é 98% preciso com um grupo e apenas 91% (ainda que isso seja mais preciso do que a análise feita por um humano) com outro.
Até agora, usei principalmente exemplos referentes a pessoas e suas características. É em torno desse tema que a discussão sobre esse problema se concentra. Mas é importante entender que o preconceito contra pessoas é apenas uma parte do problema. Vamos usar aprendizado de máquina para uma variedade de coisas, e a escolha de amostra será relevante para todas elas. Por outro lado, se você está lidando com pessoas, o preconceito nos dados pode não estar relacionado a elas.
Para entender isso, voltemos ao exemplo do câncer de pele e consideremos três possibilidades hipotéticas de falha do sistema.
- Distribuição heterogênea de pessoas: número desequilibrado de fotos de pele em diferentes tons, levando a resultados falso-positivos ou falso-negativos relacionados à pigmentação.
- Os dados nos quais o sistema é treinado contêm uma característica frequentemente encontrada e distribuída de forma heterogênea, que não está relacionada a pessoas e não tem valor diagnóstico: uma régua nas fotos de manifestações de câncer de pele ou grama nas fotos de ovelhas. Nesse caso, o resultado será diferente se a imagem contiver pixels de algo que o olho humano identificaria como 'régua'.
- Os dados contêm uma característica externa que uma pessoa não pode ver, mesmo que a procure.
O que isso significa? Sabemos a priori que os dados podem representar diferentes grupos de pessoas de maneira diferente, e pelo menos podemos planejar a busca por tais exceções. Em outras palavras, há várias razões sociais para supor que os dados sobre grupos de pessoas já contenham algum preconceito. Se olharmos para a foto com a régua, veremos essa régua — simplesmente a ignoramos antes, sabendo que não tem relevância, e esquecemos que o sistema não sabe de nada.
Mas e se todas as suas fotos de pele doente forem tiradas em um escritório onde são usadas lâmpadas incandescentes, enquanto as de pele saudável foram feitas sob luz fluorescente? E se, após fotografar a pele saudável, você atualizou o sistema operacional do seu telefone antes de fotografar a pele doente e a Apple ou o Google alteraram um pouco o algoritmo de supressão de ruído? Um humano não perceberá isso, não importa o quanto procure por tais características. Mas o sistema de uso da máquina verá e usará isso imediatamente. Ele não sabe nada.
Enquanto falamos sobre correlações espúrias, pode acontecer que os dados sejam precisos e os resultados corretos, mas você não queira usá-los por razões éticas, legais ou gerenciais. Em algumas jurisdições, por exemplo, não se pode oferecer descontos em seguros para mulheres, mesmo que elas possam dirigir de forma mais segura. Podemos facilmente imaginar um sistema que, ao analisar dados históricos, atribui um menor coeficiente de risco a nomes femininos. Ok, vamos remover os nomes da amostra. Mas lembre-se do exemplo da Amazon: o sistema pode determinar o gênero por outros fatores (mesmo não sabendo o que é gênero ou o que é um carro), e você não perceberá isso até que o regulador analise retroativamente as tarifas que você propõe e lhe aplique uma multa.
Finalmente, frequentemente presume-se que usaremos esses sistemas apenas para projetos relacionados a pessoas e interações sociais. Não é assim. Se você está fabricando turbinas a gás, provavelmente quererá aplicar aprendizado de máquina à telemetria transmitida por dezenas ou centenas de sensores em seu produto (sensores de áudio, vídeo, temperatura e quaisquer outros geram dados que podem ser facilmente adaptados para criar um modelo de aprendizado de máquina). Hipoteticamente, você poderia dizer: "Aqui estão os dados de mil turbinas que falharam, obtidos antes de suas quebras, e aqui estão os dados de mil turbinas que não falharam. Construa um modelo para indicar as diferenças entre elas". Agora imagine que os sensores da Siemens estão instalados em 75% das turbinas defeituosas e apenas 12% das boas (não há relação com as quebras). O sistema construirá um modelo para localizar turbinas com sensores da Siemens. Oops!

Imagem — Moritz Hardt, UC Berkeley
Gerenciamento de viés de IA
O que podemos fazer a respeito? Podemos abordar a questão de três maneiras:
- Rigor metodológico na coleta e gerenciamento de dados para treinar o sistema.
- Ferramentas técnicas para análise e diagnóstico do comportamento do modelo.
- Treinamento, aprendizado e cautela ao integrar aprendizado de máquina em produtos.
No livro "O Burguês Phonêmico" de Molière, há uma piada: um homem descobre que a literatura se divide em prosa e poesia, e ele se maravilha ao perceber que, a vida toda, falou em prosa sem saber. Provavelmente, os estatísticos se sentem assim hoje: sem perceber, dedicaram suas carreiras à inteligência artificial e ao erro de amostragem. Buscar o erro de amostragem e se preocupar com ele não é um novo problema; precisamos simplesmente abordar sistematicamente sua solução. Como mencionado acima, em alguns casos, é realmente mais fácil fazer isso estudando problemas relacionados a dados sobre pessoas. Suponhamos, a priori, que possamos ter preconceitos em relação a diferentes grupos de pessoas, mas o preconceito sobre os sensores Siemens é algo que nos parece difícil até de imaginar.
A novidade em tudo isso é, claro, que as pessoas não estão mais fazendo análises estatísticas diretamente. Elas são realizadas por máquinas que criam grandes modelos complexos, difíceis de entender. A questão da transparência é um dos aspectos principais do problema do preconceito. Temos medo de que o sistema não seja apenas tendencioso, mas que não haja nenhuma possibilidade de detectar seu preconceito, e que o aprendizado de máquina se diferencia de outras formas de automação, que se presume consistirem em etapas lógicas claras que podem ser verificadas.
Aqui existem duas questões. Podemos, talvez, realizar algum tipo de auditoria nos sistemas de aprendizado de máquina. E a auditoria de qualquer outro sistema, na verdade, não é muito mais fácil.
Primeiro, uma das direções da pesquisa moderna em aprendizado de máquina é encontrar métodos para identificar funcionalidades importantes dos sistemas de aprendizado de máquina. No entanto, o aprendizado de máquina (em seu estado atual) é um campo científico completamente novo que muda rapidamente, por isso não devemos pensar que coisas impossíveis hoje podem, em breve, se tornar bastante reais. O projeto é um exemplo interessante disso.
Em segundo lugar, a ideia de que se pode verificar e compreender o processo de tomada de decisões em sistemas ou organizações existentes é boa em teoria, mas não funciona tão bem na prática. Entender como as decisões são tomadas em uma grande organização não é nada fácil. Mesmo que exista um processo formal de tomada de decisões, ele não reflete como as pessoas realmente interagem, e elas muitas vezes não têm uma abordagem lógica e sistemática para tomar suas decisões. Como disse meu colega, , as pessoas também são caixas-preta..
Pegue mil pessoas de várias empresas e instituições interconectadas, e o problema se tornará ainda mais complexo. Sabemos, a posteriori, que o "Space Shuttle" estava destinado a se desintegrar na reentrada, e indivíduos dentro da NASA tinham informações que os levaram a pensar que algo ruim poderia acontecer, mas o sistema como um todo não sabia disso. A NASA havia acabado de passar por uma auditoria semelhante, após perder o último ônibus espacial, e mesmo assim perdeu outro — por uma razão muito similar. É fácil afirmar que organizações e indivíduos seguem regras lógicas claras, que podem ser verificadas, compreendidas e alteradas — mas a experiência prova o contrário. É a "».
Costumo comparar o aprendizado de máquina com bancos de dados, especialmente com bancos de dados relacionais — uma nova tecnologia fundamental que transformou as capacidades da informática e o mundo ao seu redor, que se tornou parte de tudo, que usamos continuamente sem nos darmos conta. Os bancos de dados também têm problemas, e são de natureza semelhante: o sistema pode ter sido construído com suposições incorretas ou dados ruins, mas isso será difícil de perceber, e as pessoas que usam o sistema farão o que ele diz, sem questionar. Existem muitas piadas antigas sobre trabalhadores do fisco que erraram seu nome e convencer eles a corrigir o erro é muito mais complicado do que realmente mudar o nome. Podemos pensar sobre isso de diferentes maneiras, mas não está claro qual é a melhor: como um problema técnico em SQL, como um erro em uma versão do Oracle ou como uma falha dos institutos burocráticos? Quão difícil é encontrar o erro em um processo que levou o sistema a não ter um recurso como a correção de erros de digitação? Seria possível perceber isso antes que as pessoas começassem a reclamar?
Essa problemática fica ainda mais clara em histórias onde motoristas acabam em rios devido a dados desatualizados em seus navegadores. Certo, os mapas precisam ser constantemente atualizados. Mas até que ponto a TomTom é responsável por levar seu carro ao mar?
Digo isso para afirmar que sim — o viés do aprendizado de máquina criará problemas. Mas esses problemas serão semelhantes aos que enfrentamos no passado, e poderão ser percebidos e resolvidos (ou não) de maneira tão eficaz quanto fizemos anteriormente. Portanto, o cenário em que o viés da IA cause danos provavelmente não ocorrerá com líderes de pesquisa em grandes organizações. O mais provável é que um pequeno contratante tecnológico ou fornecedor de software escreva algo improvisado, utilizando componentes, bibliotecas e ferramentas de código aberto que não compreende. E o cliente ingênuo cai na armadilha da expressão “inteligência artificial” na descrição do produto e, sem questionar, distribui isso entre seus funcionários mal remunerados, obrigando-os a fazer o que a IA disser. Isso já aconteceu com bancos de dados. Não é um problema da inteligência artificial e nem mesmo é um problema de software. É um fator humano.
Conclusão
O aprendizado de máquina pode realizar qualquer coisa que você consiga ensinar a um cachorro — mas você nunca pode ter certeza do que exatamente você ensinou esse cachorro.
Frequentemente, eu sinto que o termo "inteligência artificial" apenas atrapalha conversas como esta. Esse termo cria uma falsa impressão de que realmente a criamos — essa inteligência. Que estamos a caminho do HAL9000 ou Skynet — algo que realmente entende. Mas não. São apenas máquinas, e é muito mais correto compará-las, digamos, a uma máquina de lavar. Ela lavará as roupas muito melhor do que um humano, mas se você colocar louça em vez de roupa, ela… vai lavá-la. A louça ficará limpa. Mas não será o que você esperava, e isso não acontecerá porque o sistema tem algum preconceito em relação à louça. A máquina de lavar não sabe o que é louça nem o que é roupa — é apenas um exemplo de automação, conceitualmente não diferente de como os processos eram automatizados antes.
Seja sobre máquinas, aviões ou bancos de dados, esses sistemas serão simultaneamente muito poderosos e muito limitados. Eles dependerão totalmente de como as pessoas utilizam esses sistemas, de suas intenções boas ou más e de quão bem elas compreendem seu funcionamento.
Portanto, afirmar que "inteligência artificial é matemática, portanto não pode ter preconceitos" é completamente errado. Mas é igualmente incorreto declarar que o aprendizado de máquina "é subjetivo por natureza". O aprendizado de máquina encontra padrões nos dados, e quais padrões encontrará depende dos dados, que dependem de nós. Assim como o que fazemos com eles. O aprendizado de máquina realmente faz algumas coisas muito melhor que nós — mas cães, por exemplo, são muito mais eficazes do que humanos em detectar drogas, o que de forma alguma é motivo para trazê-los como testemunhas e emitir sentenças com base em seus depoimentos. E, a propósito, os cães são muito mais inteligentes do que qualquer sistema de aprendizado de máquina.
Tradução: .
Edição: .
Comunidade: .
Fonte: habr.com
