

Uma equipe de engenheiros do MIT desenvolveu uma hierarquia de memória orientada a objetos para um trabalho mais eficiente com dados. Neste artigo, exploramos como ela funciona.
/ / PD
Como é sabido, o aumento do desempenho dos CPUs modernos não é acompanhado por uma redução correspondente na latência de acesso à memória. A diferença nas métricas pode chegar a 10 vezes de um ano para o outro (). Como resultado, um gargalo surge, impedindo o uso pleno dos recursos disponíveis e desacelerando o processamento de dados.
A chamada latência de descompressão prejudica o desempenho. Em alguns casos, a preparação da descompressão dos dados pode levar até 64 ciclos de processador.
Para comparação: a adição e multiplicação de números de ponto flutuante não mais que dez ciclos. O problema é que a memória trabalha com blocos de dados de tamanho fixo, enquanto os aplicativos operam com objetos que podem conter diferentes tipos de dados e variar em tamanho. Para resolver isso, os engenheiros do MIT desenvolveram uma hierarquia de memória orientada a objetos que otimiza o processamento de dados.
Como funciona a tecnologia
No cerne da solução estão três tecnologias: Hotpads, Zippads e o algoritmo de compressão COCO.
Hotpads é uma hierarquia de memória de registradores superrápidos controlada por software (). Esses registradores são chamados de pads e existem três deles — de L1 a L3. Eles armazenam objetos de diferentes tamanhos, metadados e arrays de ponteiros.
Essencialmente, a arquitetura é um sistema de caches, mas adaptado para trabalhar com objetos. O nível do pad onde um objeto está localizado depende de quão frequentemente ele é utilizado. Se um dos níveis ‘transborda’, o sistema inicia um mecanismo semelhante ao ‘coletor de lixo’ em linguagens como Java ou Go. Ele analisa quais objetos são usados com menos frequência e os move automaticamente entre os níveis.
Zippads opera com base nos Hotpads — arquivando e desarquivando dados que entram ou saem dos dois últimos níveis da hierarquia — pad L3 e a memória principal. Nos pads primeiro e segundo, os dados são armazenados inalterados.
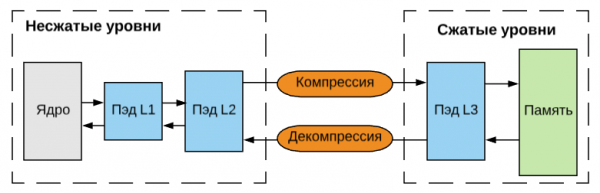
O Zippads comprime objetos com volume de até 128 bytes. Objetos maiores são divididos em partes que são colocadas em diferentes áreas de memória. Como afirmam os desenvolvedores, essa abordagem aumenta a eficiência do uso da memória.
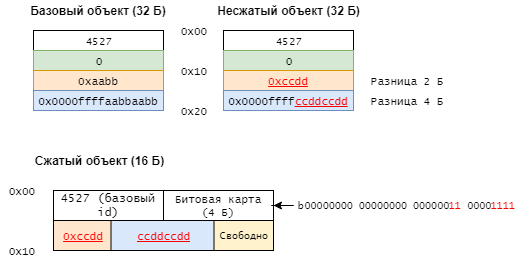
Para comprimir objetos, é utilizado o algoritmo COCO (Cross-Object COmpression), que será detalhado a seguir, embora o sistema também possa funcionar com ou . O algoritmo COCO representa uma forma de compressão diferencial (). Ele compara objetos a um "base" e remove bits duplicados — veja o diagrama abaixo:
Segundo engenheiros do MIT, sua hierarquia de memória orientada a objetos é 17% mais eficiente do que abordagens clássicas. Ela se aproxima mais da arquitetura de aplicações modernas, portanto, o novo método possui potencial.
Espera-se que, em primeiro lugar, a tecnologia comece a ser utilizada por empresas que trabalham com grandes dados e algoritmos de aprendizado de máquina. Outro potencial a ser explorado são as plataformas em nuvem. Provedores de IaaS terão a capacidade de operar de forma mais eficiente com virtualização, sistemas de armazenamento e recursos computacionais.
Nossos recursos e fontes adicionais:


Fonte: habr.com
