

O mercado de computação distribuída e big data, se acreditarmos , cresce entre 18-19% ao ano. Isso significa que a escolha de software para esses fins continua sendo uma questão relevante. Neste post, começaremos com o porquê da necessidade de computação distribuída, abordaremos mais detalhadamente a escolha de software, falaremos sobre o uso do Hadoop com a Cloudera e, por fim, discutiremos a seleção de hardware e como ele impacta a performance de diferentes maneiras.
Por que a computação distribuída é necessária nos negócios convencionais? É simples e ao mesmo tempo complicado. Simples — porque na maioria dos casos realizamos cálculos relativamente simples por unidade de informação. Complicado — porque essa informação é vasta. Muito vasta. Como consequência, é necessário . Assim, os cenários de uso são bastante universais: os cálculos podem ser aplicados em qualquer lugar onde seja necessário considerar um grande número de métricas em um conjunto de dados ainda maior.
Um dos exemplos recentes: a rede de pizzarias Dodo Pizza baseou-se na análise do banco de pedidos dos clientes, que ao escolher uma pizza com recheio aleatório, os usuários geralmente operam apenas com seis conjuntos básicos de ingredientes, além de alguns aleatórios. Com isso, a pizzaria ajustou suas compras. Além disso, conseguiu recomendar melhor aos usuários produtos adicionais oferecidos no momento do pedido, o que aumentou os lucros.
Outro exemplo: a redução de 40% no número de itens da loja H&M em algumas filiais, mantendo o nível de vendas. Isso foi alcançado excluindo itens com baixa venda, considerando a sazonalidade nas análises.
Escolha da ferramenta
O padrão da indústria para esse tipo de computação é o Hadoop. Por quê? Porque o Hadoop é uma excelente estrutura bem documentada (o mesmo Habr publica muitos artigos detalhados sobre isso), acompanhada de um conjunto completo de utilitários e bibliotecas. Você pode fornecer enormes conjuntos de dados, tanto estruturados quanto não estruturados, e o sistema se encarregará de distribuí-los entre os recursos computacionais. E esses recursos podem ser ampliados ou desligados a qualquer momento — a famosa escalabilidade horizontal em ação.
Em 2017, uma influente empresa de consultoria, a Gartner , que o Hadoop em breve se tornará obsoleto. A razão é bastante simples: os analistas acreditam que as empresas começarão a migrar em massa para a nuvem, onde poderão pagar conforme o uso de recursos computacionais. Outro fator importante que pode "enterrar" o Hadoop é a velocidade de operação. Tecnologias como Apache Spark ou Google Cloud DataFlow são mais rápidas do que o MapReduce, que é a base do Hadoop.
O Hadoop se baseia em algumas tecnologias fundamentais, as mais notáveis sendo o MapReduce (um sistema de distribuição de dados para cálculos entre servidores) e o sistema de arquivos HDFS. O último é projetado especificamente para armazenar informações distribuídas entre os nós de um cluster: cada bloco de tamanho fixo pode ser alocado em vários nós, e a replicação garante a resistência do sistema a falhas de nós individuais. Em vez de uma tabela de arquivos, é utilizado um servidor especial, denominado NameNode.
Na ilustração abaixo, está o diagrama de funcionamento do MapReduce. Na primeira etapa, os dados são divididos com base em um critério específico; na segunda, são distribuídos pelos recursos computacionais; na terceira, é realizado o cálculo.
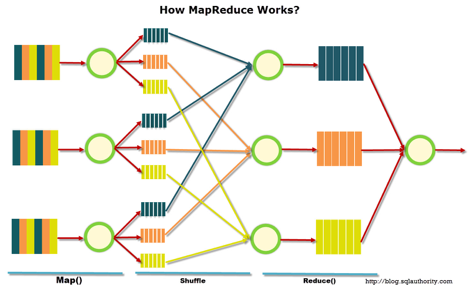
Originalmente, o MapReduce foi criado pelo Google para suas necessidades de busca. Depois, o MapReduce foi liberado como código aberto e o projeto foi assumido pela Apache. Enquanto isso, o Google começou a migrar para outras soluções. Um detalhe interessante: atualmente, o Google possui um projeto chamado Google Cloud Dataflow, que é posicionado como o próximo passo após o Hadoop, como uma alternativa rápida.
Ao analisar mais de perto, fica evidente que o Google Cloud Dataflow é baseado em uma variante do Apache Beam, que inclui um framework bem documentado, o Apache Spark, permitindo afirmar que as velocidades de execução são praticamente iguais. Além disso, o Apache Spark funciona muito bem no sistema de arquivos HDFS, o que permite implementá-lo em servidores Hadoop.
Adicionando a isso o volume de documentação e soluções prontas para Hadoop e Spark em comparação ao Google Cloud Dataflow, a escolha da ferramenta se torna clara. Além disso, os engenheiros podem decidir qual código usar — para Hadoop ou Spark — com base nas tarefas, experiência e habilidades.
Nuvem ou servidor local
A tendência de migração para a nuvem gerou até mesmo um termo interessante como Hadoop-as-a-service. Nesse cenário, a administração de servidores conectados se tornou extremamente importante. Pois, infelizmente, apesar de sua popularidade, o Hadoop puro é uma ferramenta bastante complexa de configurar, já que muito do trabalho precisa ser feito manualmente. Por exemplo, é necessário configurar os servidores separadamente, monitorar seus indicadores e ajustar cuidadosamente muitos parâmetros. Em suma, é um trabalho para entusiastas e há uma grande chance de cometer erros ou deixar algo passar.
Por isso, diversos distribuições que oferecem ferramentas convenientes de implantação e administração tornaram-se muito populares. Uma das distribuições mais conhecidas que suporta o Spark e simplifica tudo é a Cloudera. Ela possui versões paga e gratuita — e nesta última, todas as funcionalidades principais estão disponíveis, sem limitação do número de nós.
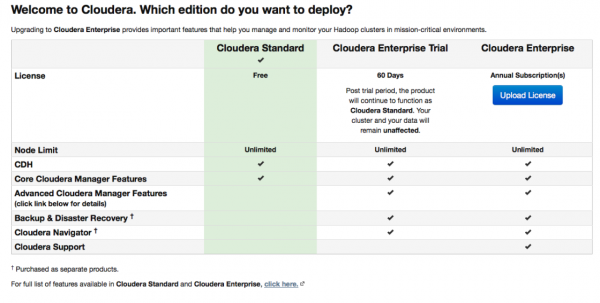
Durante a configuração, o Cloudera Manager se conectará aos seus servidores via SSH. Um ponto interessante: ao instalar, é melhor indicar que a instalação seja realizada por meio dos chamados parcelas: pacotes especiais, cada um contendo todos os componentes necessários, configurados para trabalhar uns com os outros. Essencialmente, é uma versão aprimorada do gerenciador de pacotes.
Após a instalação, obtemos um console de gerenciamento de cluster, onde é possível visualizar a telemetria dos clusters, os serviços instalados, além de poder adicionar/remover recursos e editar a configuração do cluster.
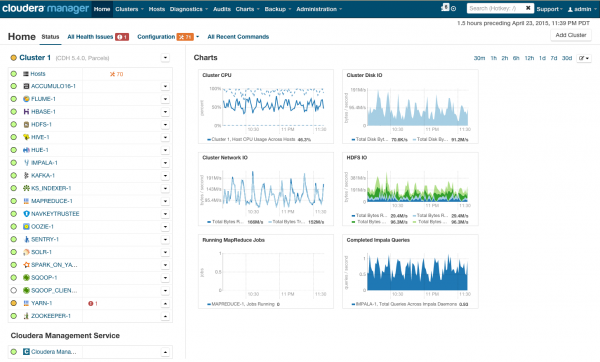
Como resultado, você se depara com a seção da nave que o levará para o futuro brilhante do Big Data. Mas antes de dizer “vamos lá”, vamos dar uma olhada sob o capô.
Requisitos de hardware
Em seu site, a Cloudera menciona diferentes configurações possíveis. Os princípios gerais que orientam sua construção são apresentados na ilustração:
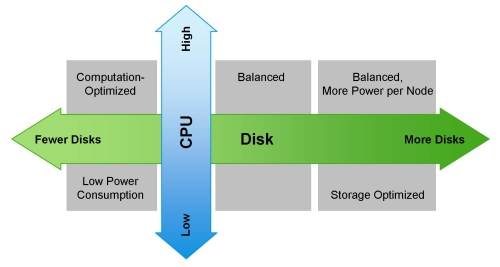
Esta visão otimista pode ser ofuscada pelo MapReduce. Se olharmos novamente para o diagrama da seção anterior, fica claro que, na maioria dos casos, uma tarefa MapReduce pode enfrentar um 'gargalo' ao ler dados do disco ou da rede. Isso também é mencionado no blog da Cloudera. Como resultado, para cálculos rápidos, incluindo aqueles feitos via Spark, que é frequentemente utilizado para cálculos em tempo real, a velocidade de entrada/saída é crucial. Portanto, ao utilizar o Hadoop, é de extrema importância que o cluster tenha máquinas balanceadas e rápidas, o que, para ser gentil, nem sempre é garantido na infraestrutura em nuvem.
O balanceamento na distribuição de cargas é alcançado pelo uso de virtualização OpenStack em servidores com poderosos CPUs multinúcleo. Os nós de dados recebem seus próprios recursos de processamento e discos específicos. Em nossa solução Atos Codex Data Lake Engine é alcançada ampla virtualização, o que nos beneficia tanto em termos de desempenho (minimizando o impacto da infraestrutura de rede) quanto em TCO (eliminando servidores físicos desnecessários).
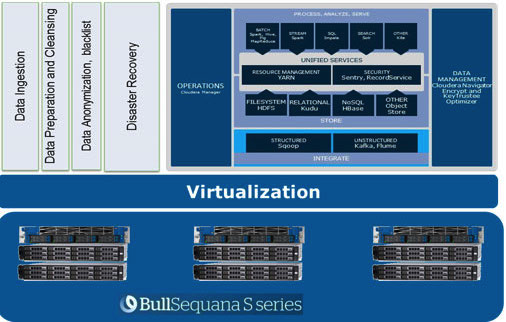
No caso do uso de servidores BullSequana S200, obtemos uma carga bastante uniforme, livre de alguns gargalos. A configuração mínima inclui 3 servidores BullSequana S200, cada um com dois JBOD, além de S200 adicionais que podem ser conectados, cada um contendo quatro nós de dados. Aqui está um exemplo de carga no teste TeraGen:
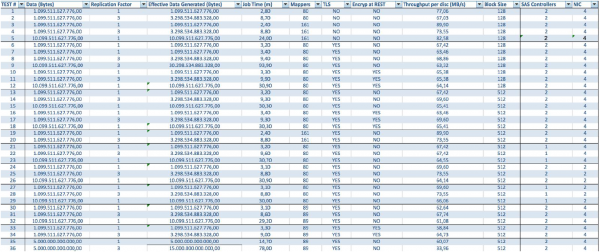
Os testes com diferentes volumes de dados e valores de replicação mostram resultados consistentes em termos de distribuição de carga entre os nós do cluster. Abaixo está um gráfico de distribuição de acesso a disco nos testes de desempenho.
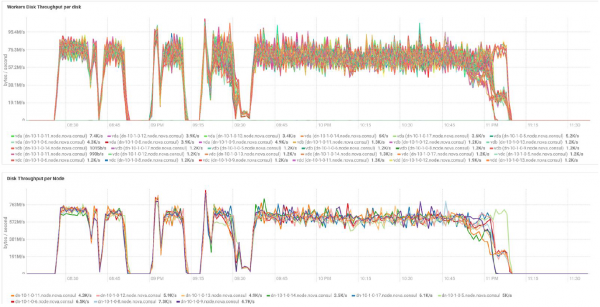
Os cálculos foram realizados com base em uma configuração mínima de 3 servidores BullSequana S200. Isso inclui 9 nós de dados e 3 nós principais, além de máquinas virtuais reservadas para implantação de proteção baseada em Virtualização OpenStack. Resultado do teste TeraSort: tamanho do bloco de 512 MB com um fator de replicação de três e criptografia levou 23,1 minutos.
Como pode-se expandir o sistema? Para o Data Lake Engine estão disponíveis diferentes tipos de expansões:
- Nós de transferência de dados: para cada 40 TB de espaço útil
- Nós analíticos com possibilidade de instalação de GPU
- Outras opções dependendo das necessidades do negócio (por exemplo, se precisar de Kafka e afins)
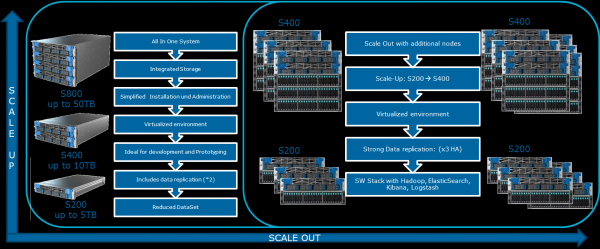
A composição do Atos Codex Data Lake Engine inclui tanto os próprios servidores quanto o software pré-instalado, que inclui o pacote Cloudera com licença; o próprio Hadoop, OpenStack com máquinas virtuais baseadas no núcleo do RedHat Enterprise Linux, sistemas de replicação de dados e backup (incluindo com nós de backup e Cloudera BDR - Backup and Disaster Recovery). O Atos Codex Data Lake Engine foi a primeira solução com virtualização a ser certificada. .
Se você está interessado em mais detalhes, teremos prazer em responder às suas perguntas nos comentários.
Fonte: habr.com
