

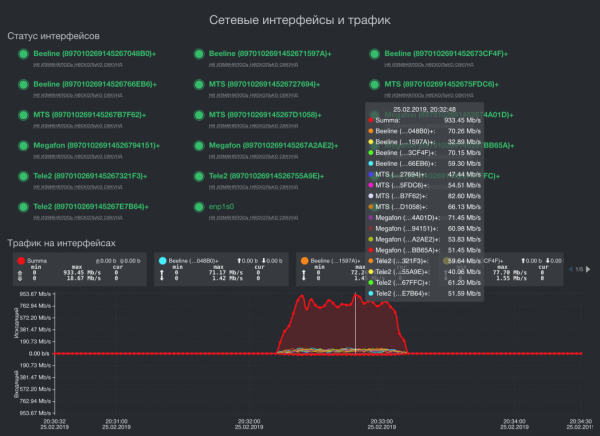
16 modems, 4 operators de celular = Velocidade de upload 933,45 Mbit/s
Introdução
Olá! Este é um artigo sobre como escrevemos um novo sistema de monitoramento para nós. Ele se diferencia dos existentes pela capacidade de obter métricas de forma síncrona e em alta frequência, com um consumo de recursos muito baixo. A frequência de consulta pode atingir 0,1 milissegundos com precisão de sincronização entre as métricas de 10 nanossegundos. Todos os arquivos binários ocupam 6 megabytes.
Sobre o projeto
Temos um produto bastante específico. Produzimos uma solução integrada para somar a largura de banda e a resiliência dos canais de transmissão de dados. Isso ocorre quando há vários canais, por exemplo, Operador1 (40 Mbit/s) + Operador2 (30 Mbit/s) + Algo mais (5 Mbit/s), resultando em um único canal estável e rápido, cuja velocidade será aproximadamente: (40+30+5)x0.92=75×0.92=69 Mbit/s.
Essas soluções são demandadas onde a capacidade de um único canal é insuficiente. Por exemplo, transporte, sistemas de videovigilância e transmissão de vídeo em tempo real, transmissão ao vivo de programas de rádio e TV, e em qualquer propriedade rural onde os provedores de serviços são apenas as grandes operadoras e a velocidade em um modem/canal é inadequada.
Para cada uma dessas áreas, lançamos uma linha exclusiva de dispositivos, no entanto, a parte de software deles é quase idêntica, e um sistema de monitoramento de qualidade é um dos principais módulos, sem a implementação correta da qual o produto não seria viável.
Em poucos anos, conseguimos criar um sistema de monitoramento multilayer, rápido, multiplataforma e leve. É isso que queremos compartilhar com a respeitável comunidade.
Formulação do problema
O sistema de monitoramento fornece métricas de dois tipos fundamentalmente diferentes: métricas em tempo real e todas as outras. As seguintes exigências foram estabelecidas para o sistema de monitoramento:
- Obtenção síncrona de métricas em tempo real e transmissão para o sistema de gerenciamento de comunicação sem atrasos.
Alta frequência e sincronização de diferentes métricas não são apenas importantes, são vitalmente necessárias para a análise da entropia dos canais de transmissão de dados. Se em um canal de transmissão de dados a latência média é de 30 milissegundos, um erro de sincronização entre as outras métricas de apenas um milissegundo levará à degradação da velocidade do canal resultante em cerca de 5%. Se errarmos na sincronização em 1 milissegundo em 4 canais, a degradação da velocidade pode cair facilmente até 30%. Além disso, a entropia nos canais muda muito rapidamente, então, se medirmos com menos frequência do que uma vez a cada 0,5 milissegundos, em canais rápidos com baixa latência, obteremos uma alta degradação da velocidade. É claro que tal precisão não é necessária para todas as métricas e em todas as condições. Quando a latência no canal for de 500 milissegundos, e estamos lidando com tais casos, um erro de 1 milissegundo quase não será perceptível. Além disso, para métricas de sistemas de suporte à vida, precisamos de uma frequência de amostragem e sincronização de 2 segundos, contudo, o próprio sistema de monitoramento deve ser capaz de operar com frequências de amostragem extremamente altas e sincronização extremamente precisa de métricas. - Mínimo consumo de recursos e uma única pilha.
O dispositivo final pode ser tanto um poderoso complexo embarcado, capaz de analisar a situação na estrada ou realizar a captura biométrica de pessoas, quanto um computador de placa única do tamanho de uma palma, que um soldado de operações especiais transporta sob o colete à prova de balas para transmitir vídeo em tempo real em condições de má conexão. Apesar dessa diversidade de arquiteturas e capacidades computacionais, gostaríamos de ter uma pilha de software uniforme. - Arquitetura em camadas
As métricas devem ser coletadas e agregadas no dispositivo final, ter um sistema local de armazenamento e visualização em tempo real e retrospectiva. Em caso de conexão, os dados devem ser enviados para o sistema de monitoramento central. Quando não há conexão, a fila de envio deve ser acumulada e não consumir memória operacional. - API para integração no sistema de monitoramento do cliente, pois ninguém precisa de muitos sistemas de monitoramento. O cliente deve coletar dados de quaisquer dispositivos e redes em um único monitoramento.
O que foi produzido
Para não sobrecarregar este extenso artigo, não fornecerei exemplos e medições de todos os sistemas de monitoramento. Isso requereria outro artigo. Apenas direi que não conseguimos encontrar um sistema de monitoramento que consiga capturar duas métricas simultaneamente com uma margem de erro inferior a 1 milissegundo e que funcione de forma igualmente eficaz tanto na arquitetura ARM com 64 MB de RAM quanto na arquitetura x86_64 com 32 GB de RAM. Portanto, decidimos escrever o nosso próprio, que faz tudo isso. Aqui está o que conseguimos:
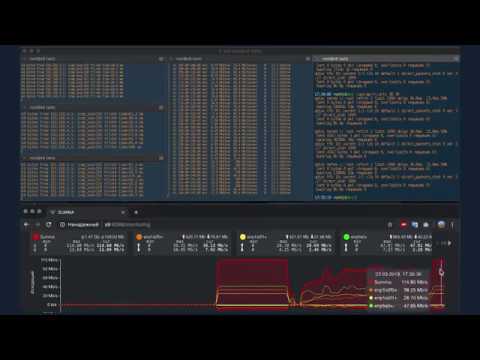
Soma da largura de banda de três canais para diferentes topologias de rede
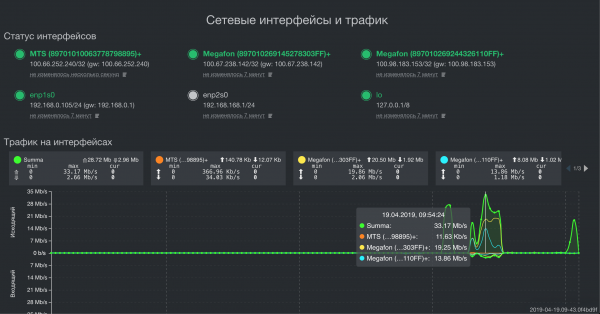
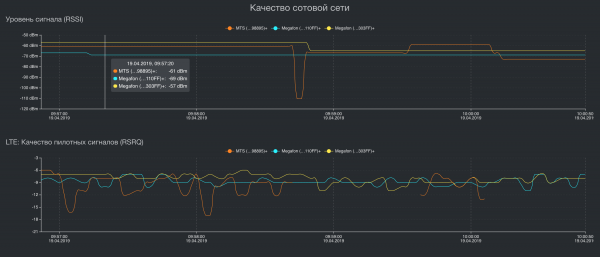
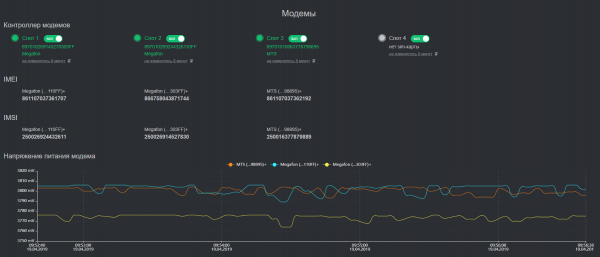
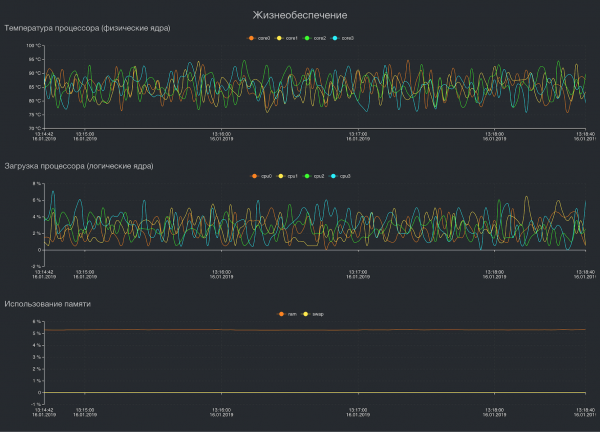
Visualização de algumas métricas-chave
Arquitetura
Como linguagem de programação principal, tanto no dispositivo quanto no data center, usamos Golang. Isso simplificou bastante a vida com sua implementação de multitarefa e a possibilidade de obter um único arquivo binário executável estaticamente vinculado para cada serviço. Como resultado, economizamos significativamente em recursos, métodos e tráfego de implantação do serviço em dispositivos finais, além de tempo de desenvolvimento e depuração de código.
O sistema é implementado de acordo com o princípio modular clássico e contém várias subsistemas:
- Registro de métricas.
Cada métrica é gerenciada por sua própria thread e sincronizada através de canais. Conseguimos alcançar uma precisão de sincronização de até 10 nanosegundos. - Armazenamento de métricas
Nós estávamos decidindo entre criar nosso próprio armazenamento para séries temporais ou usar algo existente. O banco de dados é necessário para dados retrospectivos que serão utilizados posteriormente para visualização. Ou seja, não contém dados de latência no canal a cada 0,5 milissegundos ou leituras de erros na rede de transporte, mas sim a velocidade em cada interface a cada 500 milissegundos. Além dos altos requisitos de compatibilidade entre plataformas e baixo consumo de recursos, é extremamente importante para nós ter a capacidade de processar os dados onde eles são armazenados. Isso economiza drasticamente recursos computacionais. Desde 2016, usamos o SGBD Tarantool neste projeto e, por enquanto, não vemos uma substituição à vista. É flexível, com consumo otimizado de recursos e suporte técnico mais do que adequado. O Tarantool também implementou um módulo GIS. Claro, não é tão poderoso quanto o PostGIS, mas é suficiente para nossas necessidades de armazenamento de algumas métricas relacionadas à localização (relevante para transporte). - Visualização de métricas
Aqui tudo é relativamente simples. Pegamos os dados do armazenamento e os exibimos em tempo real ou retrospectivamente. - Sincronização de dados com o sistema central de monitoramento.
O sistema central de monitoramento recebe dados de todos os dispositivos, os armazena com uma retrospectiva definida e os fornece ao sistema de monitoramento do Cliente através de API. Diferente dos sistemas de monitoramento clássicos, onde o 'cabeça' coleta os dados, temos um esquema inverso. Os dispositivos enviam os dados sozinhos quando há conexão. Este é um ponto muito importante, pois permite obter dados do dispositivo durante os períodos em que ele estava indisponível e não sobrecarregar os canais e recursos enquanto o dispositivo está fora do ar. Como sistema central de monitoramento, usamos o servidor de monitoramento Influx. Ao contrário de outros, ele pode importar dados retrospectivos (ou seja, com um carimbo de data/hora diferente do momento da coleta da métrica). As métricas coletadas são visualizadas no Grafana aprimorado. Este stack padrão foi escolhido também porque possui APIs de integração prontas para praticamente qualquer sistema de monitoramento do cliente. - Sincronização de dados com o sistema central de gestão de dispositivos.
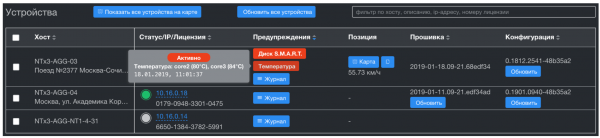
O sistema de gerenciamento de dispositivos implementa o Zero Touch Provisioning (atualização de firmware, configuração, etc.) e, ao contrário do sistema de monitoramento, recebe apenas problemas relacionados aos dispositivos. Esses são os gatilhos para o funcionamento dos serviços de vigilância de hardware a bordo e todas as métricas dos sistemas de suporte à vida: temperatura da CPU e SSD, carga da CPU, espaço livre e a saúde S.M.A.R.T nos discos. O armazenamento da subsistema é também baseado no Tarantool. Isso nos proporciona uma velocidade significativa na agregação de séries temporais por milhares de dispositivos, além de resolver completamente a questão da sincronização de dados com esses dispositivos. O Tarantool possui um excelente sistema de filas e entrega garantida. Essa importante funcionalidade nós recebemos pronta, excelente!
Sistema de gerenciamento de rede
O que vem a seguir
Até agora, o elo mais fraco é o sistema central de monitoramento. Ele é implementado em 99,9% com um stack padrão e tem uma série de desvantagens:
- O InfluxDB perde dados em caso de desligamento. Normalmente, o cliente retira rapidamente tudo o que chega dos dispositivos e no próprio banco de dados não há dados com mais de 5 minutos, no entanto, isso pode se tornar um problema no futuro.
- O Grafana tem uma série de problemas com a agregação de dados e a sincronização de sua exibição. O problema mais comum é quando há uma série temporal na base com um intervalo de 2 segundos começando, digamos, às 00:00:00, e o Grafana começa a mostrar os dados na agregação com +1 segundo. Como resultado, o usuário vê um gráfico oscilante.
- Uma quantidade excessiva de código para a integração da API com sistemas de monitoramento externos. Pode ser feito de forma muito mais compacta e, claro, reescrito em Go)
Acredito que todos vocês já viram como o Grafana se parece e, sem mim, conhecem seus problemas, então não irei sobrecarregar o post com imagens.
Conclusão
Decidi não descrever os detalhes técnicos, mas apenas comentar sobre o design de referência desse sistema. Primeiro, para descrever tecnicamente o sistema, seria necessário um artigo adicional. Em segundo lugar, nem todos estarão interessados. Escrevam nos comentários quais detalhes técnicos vocês gostariam de saber.
Se alguém tiver perguntas além deste artigo, podem me escrever para o endereço a.rodin @ qedr.com
Fonte: habr.com
