

este é um padrão (ISO, ITU-T, GOST) da linguagem que descreve informações estruturadas, bem como regras de codificação dessas informações. Para mim, como programador, isso é apenas mais um formato de serialização e representação de dados, assim como JSON, XML, XDR e outros. É extremamente comum em nossas vidas cotidianas, e muitos com ele se deparam: em comunicações móveis, telefônicas e VoIP (UMTS, LTE, WiMAX, SS7, H.323), em protocolos de rede (LDAP, SNMP, Kerberos), em tudo que diz respeito à criptografia (X.509, CMS, padrões PKCS), em cartões bancários e passaportes biométricos, entre outros muitos lugares.
Este artigo discute : biblioteca Python ASN.1 amplamente utilizada em projetos relacionados à criptografia em .
Na verdade, não se recomenda utilizar ASN.1 para tarefas criptográficas: ASN.1 e seus codecs são complexos. Isso significa que o código não será simples, e isso sempre representa um vetor extra de ataque. Basta olhar de vulnerabilidades nas bibliotecas ASN.1. Bruce Schneier em seu também não aconselha o uso deste padrão devido à sua complexidade: “A codificação TLV mais conhecida é ASN.1, mas é extremamente complexa e evitamos usá-la”. Mas, infelizmente, hoje temos onde são amplamente utilizados , CRL, OCSP, TSP, protocolos CMP, , mensagens , e uma série de padrões . Portanto, é necessário saber trabalhar com ASN.1 se você está envolvido em algo relacionado à criptografia.
ASN.1 pode ser codificado de várias maneiras/codificadores:
- (Regras de Codificação Básicas)
- (Regras de Codificação Canônica)
- (Regras de Codificação Distinguida)
- (Regras de Codificação de String Genéricas)
- (Regras de Codificação JSON)
- LWER (Regras de Codificação Leve)
- (Regras de Codificação Octet)
- (Regras de Codificação Compacta)
- SER (Regras de Codificação Específica de Sinalização)
- (Regras de Codificação XML)
e vários outros. Mas em tarefas criptográficas, na prática, dois são utilizados: BER e DER. Mesmo em documentos XML assinados (, ) ainda haverá objetos ASN.1 DER codificados em Base64, assim como no protocolo orientado a JSON da Let’s Encrypt. É melhor entender todos esses codecs e princípios de codificação BER/CER/DER em artigos e livros: , , .
BER é um formato TLV binário orientado a bytes (por exemplo, PER, popular em comunicações móveis — orientado a bits). Cada elemento é codificado na forma: tag (Tag), identificando o tipo do elemento codificado (inteiro, string, data, etc.), comprimento (Lcomprimento) do conteúdo e do próprio conteúdo (Vvalor). O BER opcionalmente permite não especificar o valor do comprimento, atribuindo um valor especial de comprimento indefinido e finalizando a mensagem com um marcador End-Of-Octets. Além da codificação do comprimento, o BER oferece muita variabilidade na forma de codificar tipos de dados, como por exemplo:
- INTEGER, IDENTIFICADOR DE OBJETO, STRING DE BIT e o comprimento do elemento podem não ser normalizados (não codificados na forma mínima);
- BOOLEAN é verdadeiro para qualquer conteúdo não nulo;
- STRING DE BIT pode conter bits nulos 'extras';
- STRING DE BIT, STRING OCTET e todos os seus tipos de string derivados, incluindo data/hora, podem ser divididos em pedaços (chunk) de comprimento variável, cujo comprimento durante a (de)codificação não é conhecido previamente;
- UTCTime/GeneralizedTime podem ter diferentes maneiras de especificar o deslocamento do fuso horário e 'extras' frações de segundos nulos;
- Os valores DEFAULT da SEQUENCE podem ser codificados ou não;
- Os valores nomeados dos últimos bits na STRING DE BIT podem opcionalmente não ser codificados;
- SEQUENCE (OF)/SET (OF) podem ter uma ordem arbitrária de elementos.
Devido a tudo que foi mencionado, codificar dados de forma que sejam idênticos à forma original nem sempre é possível. Portanto, um subconjunto de regras foi concebido: DER - que regulamenta estritamente apenas uma maneira válida de codificação, o que é crítico para tarefas criptográficas, onde, por exemplo, a alteração de um bit tornaria a assinatura ou a soma de verificação inválidas. O DER tem uma desvantagem significativa: os comprimentos de todos os elementos devem ser conhecidos previamente durante a codificação, o que não permite a serialização de dados em fluxo. O codec CER não possui essa desvantagem, garantindo igualmente uma representação única dos dados. Infelizmente (ou felizmente, pois não temos decodificadores ainda mais complexos?), ele não se tornou popular. Portanto, na prática, encontramos uso 'misto' de dados codificados em BER e DER. Como CER e DER são subconjuntos de BER, qualquer decodificador BER pode processá-los.
Problemas com pyasn1
No trabalho, escrevemos muitos programas em Python relacionados à criptografia. E há alguns anos, praticamente não havia escolhas de bibliotecas gratuitas: ou eram bibliotecas de nível muito baixo, permitindo apenas codificar/decodificar, por exemplo, um número inteiro e um cabeçalho de estrutura, ou era a biblioteca . Nós moramos lá por alguns anos e, no começo, ficamos bastante satisfeitos, pois ele permite trabalhar com estruturas ASN.1 como se fossem objetos de alto nível: por exemplo, um objeto decodificado de um certificado X.509 permite acessar seus campos através de uma interface de dicionário: cert[«tbsCertificate»][«serialNumber»] nos mostrará o número de série desse certificado. Da mesma forma, é possível "construir" objetos complexos trabalhando com eles como se fossem listas ou dicionários, e depois simplesmente chamar a função pyasn1.codec.der.encoder.encode e obter a representação serializada do documento.
No entanto, começaram a surgir desvantagens, problemas e limitações. Havia e, infelizmente, ainda existem erros no pyasn1: no momento da escrita deste artigo, um dos tipos básicos — GeneralizedTime — decodificado e codificado.
Em nossos projetos, para economizar espaço, frequentemente armazenamos apenas o caminho do arquivo, o deslocamento e o comprimento em bytes do objeto ao qual queremos nos referir. Por exemplo, um arquivo assinado arbitrário estará certamente na estrutura ASN.1 SignedData da CMS:
  0     [1,3,1018]  ContentInfo SEQUENCE
  4     [1,1,   9]   . contentType: ContentType OBJECT IDENTIFIER 1.2.840.113549.1.7.2 (id_signedData)
 19-4   [0,0,1003]   . content: [0] EXPLICIT [UNIV 16] ANY
 19     [1,3, 999]   . . DEFINED BY id_signedData: SignedData SEQUENCE
 23     [1,1,   1]   . . . version: CMSVersion INTEGER v3 (03)
 26     [1,1,  19]   . . . digestAlgorithms: DigestAlgorithmIdentifiers SET OF
                           [...]
 47     [1,3, 769]   . . . encapContentInfo: EncapsulatedContentInfo SEQUENCE
 51     [1,1,   8]   . . . . eContentType: ContentType OBJECT IDENTIFIER 1.3.6.1.5.5.7.12.2 (id_cct_PKIData)
 65-4   [1,3, 751]   . . . . eContent: [0] EXPLICIT OCTET STRING 751 bytes OPTIONAL

                 AQUI ESTÁ O CONTEÚDO DO ARQUIVO ASSINADO COM UM TAMANHO DE 751 bytes

820     [1,2, 199]   . . . signerInfos: SignerInfos SET OF
823     [1,2, 196]   . . . . 0: SignerInfo SEQUENCE
826     [1,1,   1]   . . . . . version: CMSVersion INTEGER v3 (03)
829     [0,0,  22]   . . . . . sid: SignerIdentifier CHOICE subjectKeyIdentifier
                               [...]
956     [1,1,  64]   . . . . . signature: SignatureValue OCTET STRING 64 bytes
                     . . . . . . C1:B3:88:BA:F8:92:1C:E6:3E:41:9B:E0:D3:E9:AF:D8
                     . . . . . . 47:4A:8A:9D:94:5D:56:6B:F0:C1:20:38:D2:72:22:12
                     . . . . . . 9F:76:46:F6:51:5F:9A:8D:BF:D7:A6:9B:FD:C5:DA:D2
                     . . . . . . F3:6B:00:14:A4:9D:D7:B5:E1:A6:86:44:86:A7:E8:C9
E podemos obter o arquivo assinado original com um deslocamento de 65 bytes, com tamanho de 751 bytes. O pyasn1 não armazena essas informações em seus objetos decodificados. Foi desenvolvida uma pequena biblioteca chamada TLVSeeker, que permite decodificar tags e tamanhos de objetos, na qual nós dávamos comandos como "ir para a próxima tag", "entrar na tag" (nós entramos no objeto SEQUENCE), "ir para a próxima tag", "reportar seu offset e o tamanho do objeto em que estamos". Isso foi uma navegação "manual" pelos dados serializados em ASN.1 DER. Mas não era possível trabalhar assim com dados serializados em BER, pois, por exemplo, uma string de bytes OCTET STRING poderia ser codificada em vários pedaços.
Outra limitação do pyasn1 para nossas tarefas é a incapacidade de compreender, com base nos objetos decodificados, se um determinado campo estava presente no SEQUENCE ou não. Por exemplo, se a estrutura contém o campo Field SEQUENCE OF Smth OPTIONAL, ele poderia estar completamente ausente nos dados recebidos (OPTIONAL), ou poderia estar presente, mas com comprimento zero (lista vazia). Em geral, isso não podia ser determinado. E isso é necessário para uma verificação rigorosa da validade dos dados recebidos. Imagine que algum certificado de autoridade tivesse emitido um certificado com dados "não exatamente" válidos do ponto de vista do esquema ASN.1! Por exemplo, a autoridade certificadora "TÜRKTRUST Elektronik Sertifika Hizmet Sağlayıcısı" em seu certificado raiz ultrapassou os limites permitidos. dos limites de comprimento do componente subject — não é possível decodificá-lo honestamente segundo o esquema. O codec DER exige que um campo, cujo valor é igual ao padrão DEFAULT, não seja codificado durante a transmissão — na prática, documentos assim existem, e a primeira versão do PyDERASN até permitia conscientemente esse comportamento inválido (do ponto de vista do DER) em nome da compatibilidade retroativa.
Outra limitação é a dificuldade em saber facilmente em que formato (BER/DER) um determinado objeto foi codificado na estrutura. Por exemplo, o padrão CMS diz que a mensagem deve ser codificada em BER, mas o campo signedAttrs, sobre o qual é gerada a assinatura criptográfica, deve estar em DER. Se decodificarmos em DER, teremos problemas ao processar o próprio CMS, e se decodificarmos em BER, não saberemos em que formato foi o signedAttrs. No final, teremos que usar o TLVSeeker (não há análogo no pyasn1) para localizar cada um dos campos signedAttrs e, separadamente, extraí-los da representação serializada e decodificá-los em DER.
Para nós, era muito desejável ter a possibilidade de processar automaticamente os campos DEFINED BY, que aparecem com bastante frequência. Após a decodificação da estrutura ASN.1, podemos acabar com vários campos ANY, que devem ser processados de acordo com um esquema, escolhido com base no OBJECT IDENTIFIER fornecido no campo da estrutura. No código Python, isso significa escrever um if e, em seguida, chamar o decodificador para o campo ANY.
Aparição do PyDERASN
No Atlas, regularmente, ao encontrar problemas ou ao melhorar os programas livres que usamos, enviamos patches para cima. No pyasn1, enviamos melhorias algumas vezes, mas o código do pyasn1 não é dos mais fáceis de entender e, às vezes, ocorria mudanças incompatíveis na API, que nos prejudicavam. Além disso, estávamos acostumados a escrever testes com geração de testes, o que não havia no pyasn1.
Um belo dia, decidi que era hora de parar de tolerar isso e tentar escrever minha própria biblioteca com __slots__, offsets e blobs perfeitamente exibidos! Apenas criar um codec ASN.1 não seria suficiente — seria necessário migrar todos os nossos projetos interdependentes para ela, o que envolve centenas de milhares de linhas de código que lidam com estruturas ASN.1. Portanto, uma das exigências para ela era a fácil transição do código atual do pyasn1. Gastando todas as minhas férias, escrevi esta biblioteca e migrei todos os projetos para ela. Como esses projetos têm praticamente 100% de cobertura de testes, isso significava a completa funcionalidade da biblioteca.
O PyDERASN, da mesma forma, tem praticamente 100% de cobertura de testes. Utiliza testes gerados com uma biblioteca maravilhosa chamada . Também foi realizado -em em máquinas com 32 núcleos. Embora praticamente não tenhamos mais código Python2, o PyDERASN ainda mantém compatibilidade com ele, e por isso tem apenas um dependência. Além disso, foi testado em relação a .
O princípio de funcionamento é semelhante ao pyasn1 — trabalho com objetos Python de alto nível. A descrição dos esquemas ASN.1 é similar.
class TBSCertificate(Sequence):
    schema = (
        ("version", Version(expl=tag_ctxc(0), default="v1")),
        ("serialNumber", CertificateSerialNumber()),
        ("signature", AlgorithmIdentifier()),
        ("issuer", Name()),
        ("validity", Validity()),
        ("subject", Name()),
        ("subjectPublicKeyInfo", SubjectPublicKeyInfo()),
        ("issuerUniqueID", UniqueIdentifier(impl=tag_ctxp(1), optional=True)),
        ("subjectUniqueID", UniqueIdentifier(impl=tag_ctxp(2), optional=True)),
        ("extensions", Extensions(expl=tag_ctxc(3), optional=True)),
    )
No entanto, o PyDERASN possui uma forma de tipagem rígida. No pyasn1, se um campo tinha o tipo CMSVersion(INTEGER), era possível atribuir um int ou INTEGER. O PyDERASN exige que o objeto atribuído fosse exatamente CMSVersion. Além do fato de estarmos escrevendo código Python3, nós também usamos , portanto, nas nossas funções não teremos argumentos confusos como def func(serial, contents), mas sim def func(serial: CertificateSerialNumber, contents: EncapsulatedContentInfo), e o PyDERASN ajuda a manter tal código.
Além disso, o PyDERASN oferece convenientes exceções relacionadas a essa tipagem. O pyasn1 não permitia que no SubjectKeyIdentifier().subtype(implicitTag=Tag(...)) fosse atribuído um objeto SubjectKeyIdentifier() (sem o necessário IMPLICIT TAG) e frequentemente era necessário copiar e recriar objetos apenas por causa de tags IMPLICIT/EXPLICIT alteradas. O PyDERASN monitora rigorosamente apenas o tipo básico — ele automaticamente substituirá as tags com base na estrutura já existente do esquema ASN.1. Isso simplifica significativamente o código das aplicações.
Se ocorrer um erro durante a decodificação, no pyasn1 é difícil entender exatamente onde isso aconteceu. Por exemplo, no certificado turco mencionado anteriormente, receberemos o seguinte erro: UTF8String (tbsCertificate:issuer:rdnSequence:3:0:value:DEFINED BY 2.5.4.10:utf8String) (at 138) limites não satisfeitos: 1 ⇐ 77 ⇐ 64 Ao escrever estruturas ASN.1, as pessoas podem cometer erros, e isso facilita a depuração de aplicações ou a identificação de problemas em documentos codificados pela parte oposta.
Na primeira versão, o PyDERASN não tinha suporte para codificação BER. Isso surgiu muito depois e ainda não suporta o tratamento de UTCTime/GeneralizedTime com fusos horários. Isso virá no futuro, já que o projeto está sendo desenvolvido principalmente em tempo livre.
Na primeira versão, não havia suporte para campos DEFINED BY. Após alguns meses, essa e começou a ser amplamente utilizada, reduzindo significativamente o código das aplicações — em uma única operação de decodificação, era possível obter toda a estrutura analisada até a sua profundidade máxima. Para isso, no esquema, são definidos quais campos 'definem' o que. Por exemplo, descrição do esquema CMS:
class ContentInfo(Sequence):
    schema = (
        ("contentType", ContentType(defines=((("content",), {
            id_authenticatedData: AuthenticatedData(),
            id_digestedData: DigestedData(),
            id_encryptedData: EncryptedData(),
            id_envelopedData: EnvelopedData(),
            id_signedData: SignedData(),
        }),))),
        ("content", Any(expl=tag_ctxc(0))),
    )
isso significa que se contentType contiver OID com o valor id_signedData, o campo content (localizado neste mesmo SEQUENCE) deve ser decodificado pelo esquema SignedData. Por que tantas parênteses? Um campo pode 'definir' vários campos ao mesmo tempo, como acontece nas estruturas EnvelopedData. Os campos definidos são identificados pelo chamado decode path — ele determina a localização exata de qualquer elemento em todas as estruturas.
Nem sempre é desejável ou é possível inserir esses defines diretamente no esquema. Podem existir casos específicos de aplicação em que OIDs e estruturas sejam conhecidos apenas em um projeto externo. PyDERASN oferece a possibilidade de definir esses defines diretamente no momento da decodificação da estrutura:
ContentInfo().decode(data, ctx={"defines_by_path": ((
    (
        "content", DecodePathDefBy(id_signedData),
        "certificates", any, "certificate", "tbsCertificate",
        "extensions", any, "extnID",
    ),
    ((("extnValue",), {
        id_ce_authorityKeyIdentifier: AuthorityKeyIdentifier(),
        id_ce_basicConstraints: BasicConstraints(),
        [...]
        id_ru_subjectSignTool: SubjectSignTool(),
    }),),
),)})
Aqui, estamos afirmando que no CMS SignedData para todos os certificados anexados, devemos decodificar todas as suas extensões (AuthorityKeyIdentifier, BasicConstraints, SubjectSignTool, etc.). Estamos especificando através do decode path, a qual elemento precisamos 'substituir' os defines, como se tivesse sido definido no esquema.
Finalmente, o PyDERASN tem a capacidade de operar a partir da para decodificação de arquivos ASN.1 e possui uma rica . É possível decodificar qualquer ASN.1, ou você pode definir um esquema específico e ver algo parecido:
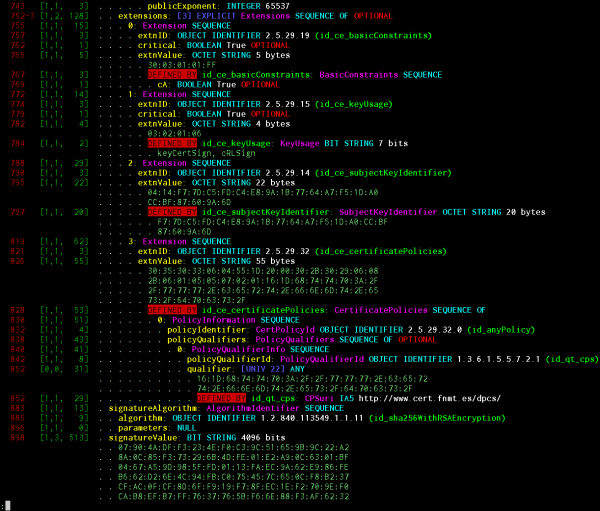
Informações exibidas: deslocamento do objeto, comprimento da tag, comprimento do comprimento, comprimento do conteúdo, presença de EOC (end-of-octetos), sinalização de codificação BER, sinalização de codificação de comprimento indefinido, comprimento e deslocamento da tag EXPLICIT (se houver), profundidade de aninhamento do objeto nas estruturas, valor de tag IMPLICIT/EXPLICIT, nome do objeto conforme o esquema, seu tipo básico ASN.1, número sequencial dentro de SEQUENCE/SET OF, valor de CHOICE (se houver), nome legível por humanos INTEGER/ENUMERATED/BIT STRING conforme o esquema, valor de qualquer tipo básico, sinalizador DEFAULT/OPTIONAL do esquema, sinalização de que o objeto foi automaticamente decodificado como DEFINED BY e por qual OID isso ocorreu, OID legível por humanos.
O sistema de pretty printing foi projetado para gerar uma sequência de objetos PP, que são visualizados separadamente. No screenshot, é mostrado o renderizador em texto simples colorido. Existem também renderizadores nos formatos JSON/HTML, permitindo que isso seja visualizado com destaque no navegador ASN.1 como em projeto.
Outras bibliotecas
Isso não era o objetivo, mas o PyDERASN acabou sendo significativamente do que o pyasn1. Por exemplo, a decodificação de arquivos CRL de tamanhos megabyte pode levar tanto tempo que será necessário pensar em formatos intermediários de armazenamento (rápidos) e mudar a arquitetura dos aplicativos. O pyasn1 decodifica CRL em meu laptop em mais de 20 minutos, enquanto o PyDERASN leva apenas 28 segundos! Existe um projeto , focado em trabalhar rapidamente com estruturas criptográficas: ele decodifica (completamente, não de forma preguiçosa) o mesmo CRL em 29 segundos, mas consome quase o dobro da memória RAM ao ser executado sob Python3 (983 MiB contra 498), e 3,5 vezes mais sob Python2 (1677 contra 488), enquanto o pyasn1 consome até 4,3 vezes mais (2093 contra 488).
O asn1crypto, que mencionei, não consideramos, pois o projeto ainda estava apenas começando, e não ouvimos falar sobre ele. Agora também não olharíamos para esse lado, já que constatei imediatamente que o mesmo GeneralizedTime não aceita formato arbitrário, e ao serializar, ele silenciosamente remove frações de segundo. Isso é aceitável para trabalhar com certificados X.509, mas não é adequado em geral.
Atualmente, o PyDERASN é o decodificador DER de Python/Go mais rigoroso que conheço. Na biblioteca encoding/asn1 do meu Go favorito IDENTIFICADOR DE OBJETO e UTCTime/GeneralizedTime strings. Às vezes, a rigidez pode ser um obstáculo (principalmente devido à compatibilidade retroativa com aplicativos antigos que ninguém vai corrigir), por isso no PyDERASN é possível passar opções durante a decodificação. para relaxar as verificações.
O código do projeto procura ser o mais simples possível. Toda a biblioteca é um único arquivo. O código é escrito com foco na clareza de entendimento, sem excessivas otimizações de performance e código DRY. Não há, como já mencionado, suporte completo para a decodificação BER de UTCTime/GeneralizedTime strings, bem como tipos de dados REAL, RELATIVE OID, EXTERNAL, INSTANCE OF, EMBEDDED PDV, CHARACTER STRING. Em todos os outros casos, pessoalmente, não vejo sentido em usar outras bibliotecas Python.
Como todos os meus projetos, tipo , , , , o PyDERASN é totalmente , distribuído sob os termos da , e está disponível para download gratuito. Exemplos de uso estão disponíveis e no .
, , membro , desenvolvedor Python/Go, especialista chefe .
Fonte: habr.com
