

Serverless não significa ausência física de servidores. Não é um "assassino" de contêineres e não é uma tendência passageira. É uma nova abordagem para a construção de sistemas na nuvem. No artigo de hoje, discutiremos a arquitetura de aplicativos Serverless, ver como o provedor de serviços Serverless e projetos de código aberto desempenham seus papéis. No final, abordaremos questões sobre a aplicação do Serverless.
Quero escrever a parte de servidor de um aplicativo (mesmo que seja uma loja virtual). Pode ser um chat, um serviço de publicação de conteúdo ou um balanceador de carga. De qualquer forma, haverá muita dor de cabeça: precisarei preparar a infraestrutura, definir as dependências do aplicativo e pensar no sistema operacional do host. Depois, será necessário atualizar pequenos componentes que não afetam o restante do monólito. E não vamos esquecer sobre escalabilidade sob carga.
E se pegarmos contêineres efêmeros, onde as dependências necessárias já estão pré-instaladas e os contêineres são isolados uns dos outros e do sistema operacional do host? Vamos dividir o monólito em microsserviços, cada um dos quais pode ser atualizado e escalado independentemente dos outros. Colocando o código em um desses contêineres, poderei executá-lo em qualquer infraestrutura. Já é uma melhora.
E se não quero configurar contêineres? Não quero pensar em escalabilidade do aplicativo. Não quero pagar por contêineres em execução que estão ociosos quando a carga no serviço é mínima. Quero escrever código. Focar na lógica de negócios e lançar produtos no mercado a toda velocidade.
Esses pensamentos me levaram à computação serverless. Serverless, neste caso, significa não ausência física de servidores, mas ausência de dor de cabeça com a gestão da infraestrutura.
A ideia é que a lógica do aplicativo seja dividida em funções independentes. Elas têm uma estrutura orientada a eventos. Cada função executa uma "microtarefa". Tudo o que é necessário do desenvolvedor é carregar as funções na console fornecida pelo provedor de nuvem e vinculá-las às fontes de eventos. O código será executado sob demanda em um contêiner automaticamente preparado, e eu pagarei apenas pelo tempo de execução.
Vamos ver como será o processo de desenvolvimento do aplicativo agora.
Do ponto de vista do desenvolvedor
Anteriormente, começamos a falar sobre a aplicação para a loja online. Na abordagem tradicional, a lógica principal do sistema é executada por um aplicativo monolítico. E o servidor com o aplicativo está sempre ativo, mesmo quando não há carga.
Para migrar para o serverless, dividimos a aplicação em micros tarefas. Para cada uma delas, escrevemos uma função. As funções são independentes entre si e não armazenam informações sobre o estado (stateless). Elas podem até ser escritas em diferentes linguagens. Se uma delas "falhar", a aplicação como um todo não será interrompida. A arquitetura da aplicação ficará assim:
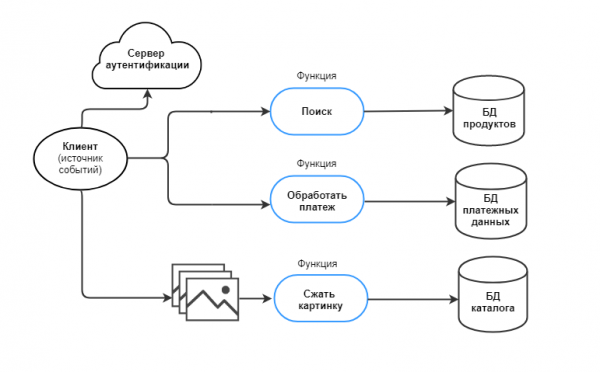
A divisão em funções no Serverless é semelhante ao trabalho com microsserviços. Mas um microsserviço pode executar várias tarefas, enquanto uma função, idealmente, deve executar uma única. Vamos imaginar que há uma tarefa de coletar estatísticas e retornar conforme o pedido do usuário. Na abordagem de microsserviços, essa tarefa é realizada por um único serviço com dois pontos de entrada: para gravação e para leitura. Em computação sem servidor, serão duas funções distintas, não relacionadas entre si. O desenvolvedor economiza recursos computacionais, por exemplo, se as estatísticas são atualizadas com mais frequência do que são solicitadas.
As funções Serverless devem ser executadas em um curto espaço de tempo (timeout), que é definido pelo provedor de serviços. Por exemplo, para a AWS, o timeout é de 15 minutos. Portanto, funções de longa duração precisarão ser ajustadas às exigências — isso é o que torna o Serverless diferente de outras tecnologias populares hoje (contenedores e Platform as a Service).
A cada função, atribuímos um evento. Evento – é um gatilho para a ação:
Evento
Ação que a função executa
Uma imagem do produto foi carregada no armazenamento
Compactar a imagem e descarregar no diretório
O endereço da loja física foi atualizado no banco de dados
Atualizar no mapa a nova localização
O cliente paga pelo produto
Iniciar o processamento do pagamento
Eventos podem ser solicitações HTTP, dados em fluxo, filas de mensagens, e assim por diante. As fontes de eventos são alterações ou a aparição de dados. Além disso, funções podem ser acionadas por um cronômetro.
A arquitetura foi desenvolvida, e a aplicação quase se tornou serverless. Agora, seguimos para o provedor de serviços.
Do lado do provedor
Normalmente, as computações serverless são oferecidas por provedores de serviços em nuvem. Eles têm diferentes nomes: Azure Functions, AWS Lambda, Google Cloud Functions, IBM Cloud Functions.
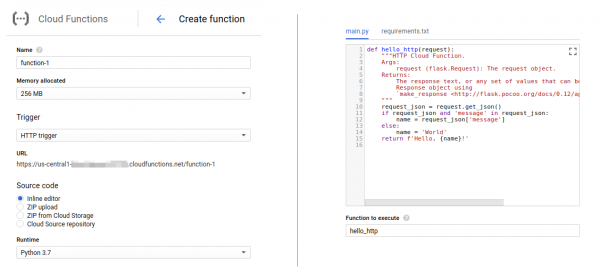
Vamos utilizar o serviço através do console ou do painel do provedor. O código das funções pode ser carregado de uma das seguintes maneiras:
- escrever o código em editores embutidos através do console web,
- carregar um arquivo zip com o código,
- trabalhar com repositórios git públicos ou privados.
Aqui também configuramos os eventos que acionam a função. O conjunto de eventos pode variar entre diferentes provedores.
O provedor construiu e automatizou um sistema de Function as a Service (FaaS) em sua infraestrutura:
- O código das funções é armazenado no lado do provedor.
- Quando um evento ocorre, contêineres com o ambiente preparado são automaticamente implementados no servidor. Cada instância da função tem seu próprio contêiner isolado.
- Da loja, a função é enviada para o contêiner, é processada e retorna o resultado.
- O número de eventos paralelos aumenta ― portanto, o número de contêineres cresce. O sistema se escala automaticamente. Se os usuários não acessam a função, ela permanece inativa.
- O provedor define o tempo de inatividade dos contêineres ― se, durante esse período, as funções não são acionadas no contêiner, ele é encerrado.
Assim, obtemos Serverless ‘pronto para uso’. Pagaremos pelo serviço sob o modelo pay-as-you-go e apenas pelas funções que são utilizadas, e somente pelo tempo em que foram utilizadas.
Para apresentar o serviço aos desenvolvedores, os provedores oferecem até 12 meses de testes gratuitos, mas limitam o tempo total de computação, o número de solicitações por mês, a quantia em dinheiro ou os recursos consumidos.
A principal vantagem de trabalhar com um provedor é a possibilidade de não se preocupar com a infraestrutura (servidores, máquinas virtuais, contêineres). Por sua vez, o provedor pode implementar FaaS tanto com suas próprias soluções quanto com ferramentas open-source. Vamos discutir isso a seguir.
Do lado do open source
Nos últimos dois anos, a comunidade open-source tem trabalhado ativamente em ferramentas Serverless. Entre os maiores jogadores do mercado que contribuem para o desenvolvimento de plataformas sem servidor estão:
- Google oferece aos desenvolvedores sua ferramenta open-source ― . No seu desenvolvimento participaram IBM, RedHat, Pivotal e SAP;
- IBM trabalhou na plataforma Serverless , que depois se tornou um projeto da Apache Foundation;
- Microsoft parte do código da plataforma foi aberto .
Os desenvolvimentos também estão avançando na direção de frameworks serverless. e são implantados dentro de clusters Kubernetes pré-configurados, funciona tanto com Kubernetes quanto com Docker Swarm. O framework atua como uma espécie de controlador - preparando, sob demanda, um ambiente de execução dentro do cluster, e depois executando a função lá.
Os frameworks oferecem flexibilidade para configurar a ferramenta às suas necessidades. Por exemplo, em Kubeless, o desenvolvedor pode configurar o timeout da execução da função (o valor padrão é de 180 segundos). O Fission, na tentativa de resolver o problema do cold start, sugere manter uma parte dos contêineres sempre em execução (embora isso acarretasse custos de recursos ociosos). Já o OpenFaaS oferece uma variedade de gatilhos: HTTP, Kafka, Redis, MQTT, Cron, AWS SQS, NATs, entre outros.
As instruções para começar podem ser encontradas na documentação oficial dos frameworks. Trabalhar com eles requer um pouco mais de habilidades do que trabalhar com um provedor - isso é, no mínimo, a capacidade de iniciar um cluster Kubernetes pela CLI. No máximo, incluir outros ferramentas open-source no trabalho (como, por exemplo, gerenciador de filas Kafka).
Independentemente de como trabalhamos com Serverless - seja através de um provedor ou utilizando soluções open-source, teremos uma série de vantagens e desvantagens do enfoque Serverless.
Do ponto de vista de vantagens e desvantagens
Serverless desenvolve as ideias da infraestrutura em contêineres e da abordagem de microserviços, onde as equipes podem trabalhar em modo multilíngue, sem se prender a uma única plataforma. A construção do sistema é simplificada e a correção de erros se torna mais fácil. A arquitetura de micro-serviços permite adicionar novas funcionalidades ao sistema muito mais rapidamente do que em uma aplicação monolítica.
Serverless reduz ainda mais o tempo de desenvolvimento, permitindo que o desenvolvedor se concentre exclusivamente na lógica de negócios da aplicação e na escrita de código. Como resultado, o tempo para o lançamento das soluções no mercado é encurtado.
Como bônus, temos escalonamento automático sob carga, e pagamos apenas pelos recursos utilizados e apenas durante o tempo em que são utilizados.
Como qualquer tecnologia, Serverless tem desvantagens.
Por exemplo, uma desvantagem pode ser o tempo de cold start (em média até 1 segundo para linguagens como JavaScript, Python, Go, Java, Ruby).
Por um lado, na prática, o tempo de inicialização a frio depende de muitas variáveis: a linguagem em que a função é escrita, o número de bibliotecas, o volume de código, a comunicação com recursos adicionais (como bancos de dados ou servidores de autenticação). Como o desenvolvedor controla essas variáveis, ele pode reduzir o tempo de inicialização. Mas, por outro lado, o desenvolvedor não pode controlar o tempo de inicialização do contêiner — isso depende do provedor.
O início a frio pode se tornar ‘quente’ quando a função reutiliza um contêiner que foi iniciado por um evento anterior. Essa situação ocorrerá em três casos:
- se os clientes usam frequentemente o serviço e aumenta o número de chamadas à função;
- se o provedor, a plataforma ou o framework permitem que parte dos contêineres permaneçam sempre ativos;
- se o desenvolvedor executa funções por um cronômetro (digamos, a cada 3 minutos).
Para muitas aplicações, o início a frio não é um problema. Aqui é preciso considerar o tipo e as tarefas do serviço. Um atraso na inicialização de um segundo nem sempre é crítico para uma aplicação empresarial, mas pode ser crítico para serviços médicos. Provavelmente, nesse caso, a abordagem sem servidor já não será adequada.
Outra desvantagem do Serverless é o curto tempo de vida da função (timeout, pelo qual a função deve ser executada).
Mas, se é necessário lidar com tarefas de longa duração, pode-se usar uma arquitetura híbrida — combinando o Serverless com outra tecnologia.
Nem todos os sistemas poderão operar sob o esquema Serverless.
Algumas aplicações ainda armazenarão dados e estados durante a execução. Algumas arquiteturas permanecerão monolíticas, e algumas funções terão longa duração. No entanto (como aconteceu com tecnologias de nuvem e, posteriormente, com contêineres), o Serverless é uma tecnologia com um grande futuro.
Nesse sentido, gostaria de fazer uma transição suave para a questão da aplicação da abordagem Serverless.
Do ponto de vista da aplicação
Em 2018, a porcentagem de uso do Serverless . Entre as empresas que já implementaram a tecnologia em seus serviços, estão gigantes do mercado como Twitter, PayPal, Netflix, T-Mobile, Coca-Cola. É preciso entender que o Serverless não é uma panaceia, mas uma ferramenta para resolver um determinado conjunto de tarefas:
- Reduzir o tempo ocioso dos recursos. Não é necessário manter uma máquina virtual para serviços que têm pouca demanda.
- Processar dados "em tempo real". Comprimir imagens, remover fundo, alterar a codificação de vídeos, trabalhar com sensores IoT, realizar operações matemáticas.
- "Unir" outros serviços. Repositório Git com programas internos, chatbot no Slack integrado ao Jira e ao calendário.
- Balancear carga. Aqui vamos parar um pouco mais detalhadamente.
Suponha que existe um serviço que recebe 50 visitantes. Para ele, existe uma máquina virtual com hardware fraco. Periodicamente, a carga sobre o serviço aumenta várias vezes. Nesse caso, o hardware fraco não consegue lidar.
É possível incluir um balanceador no sistema, que distribuirá a carga, por exemplo, entre três máquinas virtuais. Neste momento, não conseguimos prever a carga com precisão, então mantemos uma quantidade de recursos ativos "de reserva". E pagamos mais pelocios.
Nessa situação, podemos otimizar o sistema através de uma abordagem híbrida: deixamos uma máquina virtual atrás do balanceador de carga e colocamos um link para um Endpoint Serverless com funções. Se a carga exceder o limite, o balanceador inicia instâncias de funções que lidam com parte dos pedidos.
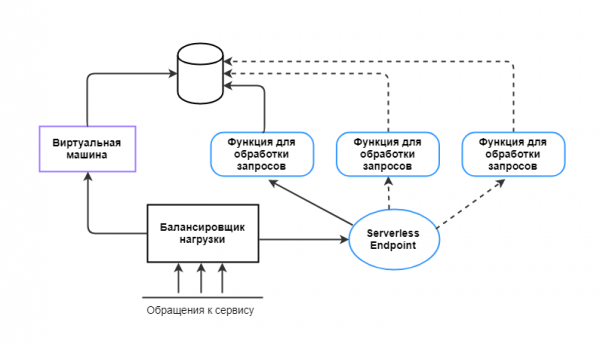
Dessa forma, o Serverless pode ser usado em situações em que é necessário processar um grande número de solicitações, mas não com frequência. Nesse caso, iniciar várias funções por 15 minutos é mais econômico do que manter uma máquina virtual ou servidor constantemente ativo.
Apesar de todas as vantagens da computação serverless, antes de implementar, é importante avaliar a lógica do aplicativo e entender quais tarefas o Serverless pode resolver em cada caso específico.
Serverless e Selectel
Na Selectel já através do nosso painel de controle. Agora estamos construindo nossa própria plataforma FaaS. Queremos que os desenvolvedores possam resolver suas tarefas usando Serverless através de uma interface conveniente e flexível.
Se você tem ideias sobre como deve ser a plataforma FaaS ideal e como gostaria de usar Serverless em seus projetos, compartilhe-as nos comentários. Levaremos suas sugestões em consideração ao desenvolver a plataforma.
Materiais utilizados no artigo:
Fonte: habr.com
