

Atualmente, a alta disponibilidade dos serviços é uma exigência em todos os lugares, não apenas em projetos grandes e caros. Sites temporariamente indisponíveis com a mensagem 'Desculpe, em manutenção técnica' ainda são comuns, mas geralmente causam um sorriso condescendente. Adicione a isso a vida nas nuvens, onde para lançar um servidor extra é necessário apenas uma chamada à API, e não é preciso se preocupar com a operação 'física'. Já não existem justificativas para não ter um sistema crítico implementado de forma confiável com tecnologias de cluster e redundância.
Vamos falar sobre as soluções que consideramos para garantir a confiabilidade dos bancos de dados em nossos serviços e as conclusões que chegamos. Além disso, teremos uma demonstração com implicações significativas.
Legado na arquitetura de alta disponibilidade
Isso é ainda mais evidente quando analisamos a evolução de vários sistemas opensource. Soluções antigas foram obrigadas a adicionar tecnologias de alta disponibilidade à medida que a demanda aumentava, e a qualidade delas variava. As soluções de nova geração colocam a alta disponibilidade como base de sua arquitetura. Por exemplo, o MongoDB posiciona o cluster como a principal opção de uso. O cluster é escalável horizontalmente, o que representa uma grande vantagem competitiva para este SGBD.
Voltando ao PostgreSQL. Este é um dos projetos opensource mais antigos e populares, com seu primeiro lançamento ocorrido em 1995. A equipe do projeto, por muito tempo, não considerou a alta disponibilidade uma tarefa necessária a ser resolvida pela própria sistema. Por isso, a tecnologia de replicação para a criação de cópias de dados só foi incorporada na versão 8.2 em 2006, mas era baseada em arquivos (log shipping). Em 2010, na versão 9.0, surgiu a replicação em streaming, que se tornou a base para a criação de diferentes clusters. Isso, de fato, surpreende as pessoas que conhecem o PostgreSQL após o Enterprise SQL ou os modernos NoSQL — a solução padrão da comunidade é simplesmente um par master-replica com replicação síncrona ou assíncrona. Nesse caso, a mudança do mestre é feita manualmente, e a questão da transição de clientes também é deixada para ser resolvida de forma autônoma.
Como decidimos implementar um PostgreSQL confiável e o que escolhemos para isso.
No entanto, o PostgreSQL não teria se tornado tão popular se não fosse pela enorme quantidade de projetos e ferramentas que ajudam a construir uma solução resiliente que não requer atenção constante. Na nuvem (MCS) desde o início do DBaaS estavam disponíveis servidores individuais PostgreSQL e pares mestre-replicado com replicação assíncrona.
Naturalmente, queríamos simplificar a vida de todos e tornar acessível uma instalação de PostgreSQL que pudesse servir como base para serviços de alta disponibilidade, sem a necessidade de monitoramento contínuo e sem acordar à noite para realizar a troca. Nesse segmento, existem tanto soluções antigas comprovadas quanto uma nova geração de utilitários que utilizam as últimas inovações.
Hoje, o problema da alta disponibilidade não se resume apenas à redundância (isso é óbvio), mas sim ao consenso — o algoritmo para escolha de líder (Leader election). Frequentemente, grandes falhas não ocorrem por falta de servidores, mas por problemas de consenso: um novo líder não foi escolhido, apareceram dois líderes em diferentes data centers, etc. Um exemplo é a falha no cluster MySQL do Github — eles escreveram .
A base matemática sobre esse assunto é muito séria. Por um lado, existe a , que impõe limitações teóricas sobre a capacidade de construção de soluções HA, e por outro lado, algoritmos de consenso matematicamente comprovados, como e . Com base nisso, existem sistemas de consenso descentralizados bastante populares — Zookeeper, etcd, Consul. Portanto, se o sistema de tomada de decisão opera com algum algoritmo próprio, desenvolvido internamente, deve-se ter extrema cautela com ele. Após análise de um grande número de sistemas, optamos pelo Patroni — um sistema open-source, desenvolvido principalmente pela empresa Zalando.
Como um parêntese lírico, direi que também consideramos soluções multi-master, ou seja, clusters que podem ser escalados horizontalmente para gravação. No entanto, por duas razões principais, decidimos não implementar tal cluster. Primeiro, tais soluções têm alta complexidade e, consequentemente, mais pontos vulneráveis. Será difícil garantir uma solução estável para todos os casos. Em segundo lugar, nesse caso, o PostgreSQL deixa de ser puro (native), algumas funções estarão indisponíveis e alguns aplicativos podem apresentar bugs ocultos durante a operação.
Patroni
Então, como o Patroni funciona? Os desenvolvedores não reinventaram a roda e propuseram usar uma das soluções DCS comprovadas como base. Ele é responsável por todas as questões de sincronização de configurações, escolha do líder e quórum. Optamos pelo etcd para isso.
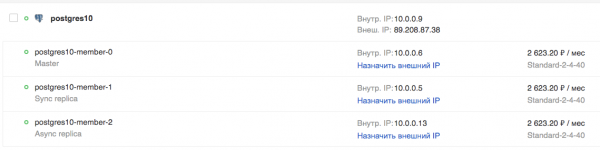
Em seguida, o Patroni cuida da aplicação correta de todas as configurações no PostgreSQL e das configurações de replicação, além da execução de comandos para switchover e failover (ou seja, troca de mestre em situações normais e anormais). No MCS em nuvem, é possível criar um cluster composto por um mestre, uma réplica síncrona e uma ou mais réplicas assíncronas. A presença de uma réplica síncrona garante a integridade dos dados em pelo menos 2 servidores, e essa réplica será a principal 'candidata a mestre'.
Como o etcd é implantado nos mesmos servidores, recomenda-se ter 3 ou 5 servidores para um quórum ideal. Tal cluster é escalável horizontalmente para leitura (sobre a escalabilidade para gravação, mencionei acima). No entanto, é importante considerar que as réplicas assíncronas tendem a ficar atrasadas, especialmente sob alta carga.
O uso dessas réplicas para leitura (hot standby) é justificado para tarefas de relatórios ou análises e alivia a carga do servidor mestre.
Se você quiser criar um cluster desse tipo por conta própria, será necessário:
- preparar 3 ou mais servidores, configurar os endereços IP e as regras de firewall entre eles;
- instalar os pacotes para os serviços etcd, Patroni, PostgreSQL;
- configurar o cluster etcd;
- configurar o serviço patroni para trabalhar com PostgreSQL.
Ou seja, no total, é preciso elaborar corretamente uma dezena de arquivos de configuração e não cometer erros em nenhum lugar. Para isso, definitivamente vale a pena usar uma ferramenta de gerenciamento de configuração, como o Ansible, por exemplo. Contudo, ainda assim não há um balanceador de carga TCP de alta disponibilidade. Criá-lo é um trabalho separado.
Para aqueles que precisam de um cluster pronto, mas não desejam se incomodar com todos esses detalhes, nós tentamos simplificar a vida e criamos um cluster pronto no Patroni em nossa nuvem, que pode ser testado gratuitamente. Além do próprio cluster, nós fizemos:
- Um balanceador de carga TCP; ele sempre aponta para o mestre atual, e a réplica síncrona ou assíncrona, conforme o caso;
- Uma API para alternar o mestre ativo do Patroni.
É possível configurá-los tanto pela API da nuvem MCS quanto pela console web.
Demonstração
Para testar as capacidades do cluster PostgreSQL na nuvem MCS, vamos ver como um aplicativo em execução se comporta diante de problemas com o SGBD.
A seguir, está o código do aplicativo que registrará eventos artificiais e os exibirá na tela. Em caso de erros, o aplicativo notificará e continuará seu trabalho em loop, enquanto não o pararmos com a combinação Ctrl + C.
from __future__ import print_function

from datetime import datetime
from random import randint
from time import sleep
import psycopg2


def main():
    try:
        connection = psycopg2.connect(user = "admin",
                                      password = "P@ssw0rd",
                                      host = "89.208.87.38",
                                      port = "5432",
                                      database = "myproddb")

        cursor = connection.cursor()
        cursor.execute("SELECT version();")
        record = cursor.fetchone()
        print("Connection opened to", record[0])

        cursor.execute(
            "INSERT INTO log VALUES ({});".format(randint(1, 10000)))
        connection.commit()
        cursor.execute("SELECT COUNT(event_id) from log;")
        record = cursor.fetchone()
        print("Logged a value, overall count: {}".format(record[0]))
    except Exception as error:
        print ("Error while connecting to PostgreSQL", error)
    finally:
        if connection:
            cursor.close()
            connection.close()
            print("Connection closed")


if __name__ == '__main__':
    try:
        while True:
            try:
                print(datetime.now())
                main()
                sleep(3)
            except Exception as e:
                print("Caught error:n", e)
                sleep(1)
    except KeyboardInterrupt:
        print("exit")
O aplicativo requer o PostgreSQL para funcionar. Vamos criar um cluster na nuvem MCS, usando a API. No terminal habitual, onde a variável OS_TOKEN contém o token de acesso à API (pode ser obtido com o comando openstack token issue), digitaremos os comandos:
Criando o cluster:
cat < pgc10.json
{"cluster":{"name":"postgres10","allow_remote_access":true,"datastore":{"type":"postgresql","version":"10"},"databases":[{"name":"myproddb"}],"users":[{"databases":[{"name":"myproddb"}],"name":"admin","password":"P@ssw0rd"}],"instances":[{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}}]}}
EOF

curl -s -H "X-Auth-Token: $OS_TOKEN"
-H 'Accept: application/json'
-H 'Content-Type: application/json'
-d @pgc10.json https://infra.mail.ru:8779/v1.0/ce2a41bbd1434013b85bdf0ba07c770f/clusters
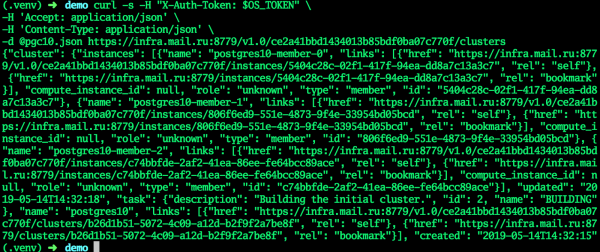
Quando o cluster mudar para o status ACTIVE, todos os campos receberão valores atualizados — o cluster estará pronto.
Na GUI:
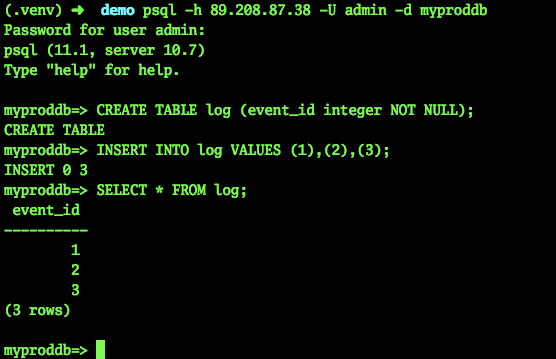
Vamos tentar conectar e criar uma tabela:
psql -h 89.208.87.38 -U admin -d myproddb
Senha para o usuário admin:
psql (11.1, servidor 10.7)
Digite "help" para ajuda.

myproddb=> CREATE TABLE log (event_id integer NOT NULL);
CREATE TABLE
myproddb=> INSERT INTO log VALUES (1),(2),(3);
INSERT 0 3
myproddb=> SELECT * FROM log;
 event_id
----------
        1
        2
        3
(3 rows)

myproddb=>
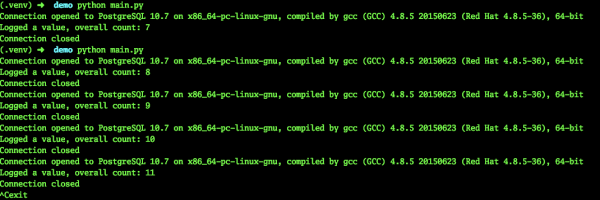
No aplicativo, vamos inserir as configurações atuais para a conexão com PostgreSQL. Vamos indicar o endereço do balanceador de carga TCP, eliminando assim a necessidade de alternar manualmente para o endereço do mestre. Vamos iniciá-lo. Como pode ser visto, os eventos estão sendo registrados com sucesso no banco de dados.
Mudança programada do mestre
Agora vamos testar o funcionamento do nosso aplicativo durante a mudança programada do mestre:
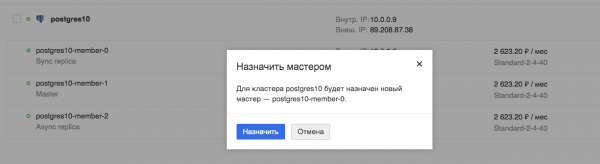
Estamos monitorando o aplicativo. Vemos que a operação do aplicativo realmente é interrompida, mas isso leva apenas alguns segundos, neste caso específico, no máximo 9.
Queda da máquina
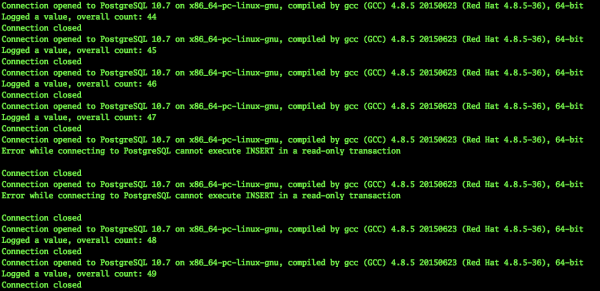
Agora vamos tentar simular a queda da máquina virtual, do atual mestre. Poderíamos simplesmente desligar a máquina virtual através da interface Horizon, mas isso seria um desligamento regular. Tal mudança seria processada por todos os serviços, incluindo o Patroni.
Precisamos de um desligamento inesperado. Então eu pedi aos nossos administradores que desligassem a máquina virtual — o atual mestre — de forma não planejada, para fins de teste.
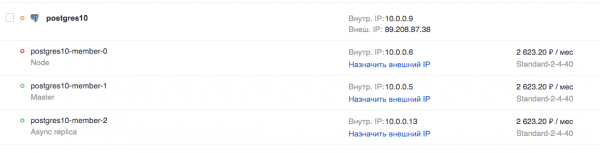
Enquanto isso, nosso aplicativo continuava funcionando. Naturalmente, tal mudança de mestre de emergência não poderia passar despercebida.
2019-03-29 10:45:56.071234
Conexão aberta ao PostgreSQL 10.7 em x86_64-pc-linux-gnu, compilado pelo gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64 bits
Valor registrado, contagem total: 453
Conexão fechada
2019-03-29 10:45:59.205463
Conexão aberta ao PostgreSQL 10.7 em x86_64-pc-linux-gnu, compilado pelo gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64 bits
Valor registrado, contagem total: 454

Conexão fechada
2019-03-29 10:46:02.661440
Erro ao conectar ao servidor PostgreSQL, conexão fechada inesperadamente
        Isso provavelmente significa que o servidor terminou anormalmente
        antes ou enquanto processava o pedido.

Erro capturado:
 variável local 'connection' referenciada antes da atribuição
……………………………………………………….. - aqui estão alguns erros
2019-03-29 10:46:30.930445
Erro ao conectar ao servidor PostgreSQL, conexão fechada inesperadamente
        Isso provavelmente significa que o servidor terminou anormalmente
        antes ou enquanto processava o pedido.

Erro capturado:
 variável local 'connection' referenciada antes da atribuição
2019-03-29 10:46:31.954399
Conexão aberta ao PostgreSQL 10.7 em x86_64-pc-linux-gnu, compilado pelo gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64 bits
Valor registrado, contagem total: 455
Conexão fechada
2019-03-29 10:46:35.409800
Conexão aberta ao PostgreSQL 10.7 em x86_64-pc-linux-gnu, compilado pelo gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64 bits
Valor registrado, contagem total: 456
Conexão fechada
^Cexit
Como pode ser visto, o aplicativo conseguiu continuar sua operação em menos de 30 segundos. Sim, uma certa quantidade de usuários do serviço pode notar problemas. No entanto, essa é uma falha grave do servidor, que não acontece com frequência. Além disso, a pessoa (administrador) dificilmente conseguiria reagir tão rapidamente, a menos que estivesse na console pronta com um script de mudança.
Saída
Acredito que um cluster desse tipo oferece uma vantagem colossal para os administradores. Essencialmente, falhas sérias e queda de servidores de banco de dados não serão percebidas pelo aplicativo e, consequentemente, pelo usuário. Não será necessário consertar algo às pressas ou mudar para configurações temporárias, servidores, etc. E se essa solução for utilizada na forma de um serviço pronto na nuvem, não será preciso perder tempo com sua preparação. Poderá se dedicar a coisas mais interessantes.
Fonte: habr.com
