

O tema de grandes falhas em centros de dados modernos levanta questões que não foram respondidas no primeiro artigo — decidimos expandi-lo.
Se acreditarmos nas estatísticas do Uptime Institute, a maior parte dos incidentes em data centers está relacionada a falhas no sistema de fornecimento de energia — essas representam 39% dos casos. O fator humano vem em seguida, contribuindo com mais 24% das falhas. A terceira causa mais significativa (15%) foram falhas no sistema de climatização, enquanto desastres naturais ocuparam o quarto lugar (12%). A soma de outros imprevistos representa apenas 10%. Sem questionar os dados de uma organização respeitável, vamos destacar um aspecto comum entre diferentes incidentes e tentar entender se poderiam ter sido evitados. Spoiler: na maioria dos casos, poderiam.
A ciência dos contatos
Simplificando, existem apenas dois problemas com o fornecimento de energia: ou não há contato onde deveria haver, ou há contato onde não deveria. Pode-se discutir por muito tempo sobre a confiabilidade dos modernos sistemas de fornecimento de energia ininterrupta, mas eles não salvam sempre. Um exemplo é o famoso caso do centro de processamento de dados da British Airways, pertencente à empresa-mãe International Airlines Group. Nas proximidades do aeroporto de Heathrow, estão localizados dois desses centros — Boadicea House e Comet House. No primeiro, em 27 de maio de 2017, ocorreu uma interrupção acidental de energia, que levou a uma sobrecarga e falha do sistema de UPS. Como resultado, parte do equipamento de TI foi fisicamente danificada, e a recuperação dessa falha levou três dias.
A companhia aérea teve que cancelar ou adiar mais de mil voos, cerca de 75 mil passageiros não conseguiram decolar a tempo — o pagamento de indenizações custou $128 milhões, sem contar os gastos necessários para restaurar a funcionalidade dos data centers. A história sobre as causas da falha de energia é confusa. Se acreditarmos nos resultados da investigação interna divulgados pelo CEO da International Airlines Group, Willie Walsh, o incidente ocorreu devido a um erro dos engenheiros. No entanto, o sistema de fornecimento de energia ininterrupta deveria ter suportado tal desligamento — foi para isso que foi instalado. Os centros de dados eram geridos por especialistas da empresa de outsourcing CBRE Managed Services, por isso a British Airways tentou recuperar o valor dos danos através da corte de Londres.
Faltas de energia ocorrem de forma semelhante: primeiro há uma interrupção causada pelo fornecedor de eletricidade, às vezes devido a condições climáticas adversas ou problemas internos (incluindo erros humanos), e então o sistema de energia ininterrupta não suporta a carga ou uma breve interrupção na sinusoide provoca falhas em muitos serviços, cujo restabelecimento leva muito tempo e dinheiro. É possível evitar tais falhas? Sem dúvida. Se o sistema for projetado corretamente, no entanto, até mesmo os criadores de grandes datacenters não estão isentos de erros.
Fator humano
Quando a causa imediata do incidente é a ação inadequada da equipe do datacenter, os problemas geralmente (mas nem sempre) afetam a parte de software da infraestrutura de TI. Esses acidentes acontecem até mesmo em grandes corporações. Em fevereiro de 2017, devido a um comando digitado incorretamente por um membro da equipe técnica de um dos datacenters, parte dos servidores da Amazon Web Services foi desligada. O erro ocorreu durante a depuração do processo de faturamento para os clientes do serviço de armazenamento em nuvem Amazon Simple Storage Service (S3). O colaborador tentava remover um determinado número de servidores virtuais utilizados pelo sistema de faturamento, mas atingiu um cluster maior.
Como resultado do erro do engenheiro, servidores que hospedavam módulos importantes do serviço de armazenamento em nuvem da Amazon foram deletados. Em primeiro lugar, o subsistema de indexação, que continha informações sobre metadados e localização de todos os objetos S3 na região americana US-EAST-1, foi afetado. O incidente também impactou o subsistema utilizado para armazenar dados e gerenciar o espaço de armazenamento disponível. Após a exclusão das máquinas virtuais, esses dois subsistemas exigiram um reinício completo, e em seguida os engenheiros da Amazon enfrentaram uma surpresa — durante um longo período, o serviço de armazenamento em nuvem público não conseguiu atender aos pedidos dos clientes.
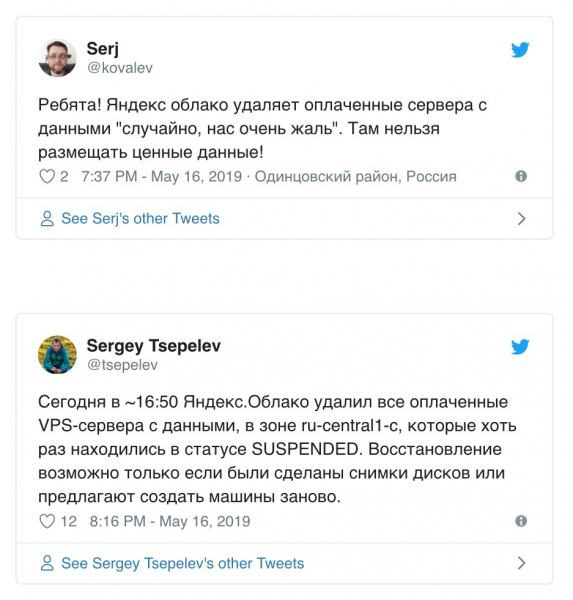
O efeito foi significativo, pois muitos grandes recursos utilizam o Amazon S3. As falhas afetaram o Trello, Coursera, IFTTT e, o que é ainda mais preocupante, os serviços de grandes parceiros da Amazon na lista do S&P 500. Calcular os danos nessas situações é complicado, mas a estimativa girou em torno de centenas de milhões de dólares. Como você pode ver, para derrubar o serviço da maior plataforma de nuvem, uma única linha de comando errada é suficiente. Este não é um caso isolado, em 16 de maio de 2019, durante manutenção programada, o serviço Yandex.Cloud máquinas virtuais de usuários na zona ru-central1-c que estiveram uma vez no status SUSPENDED. Aqui, os dados dos clientes já foram comprometidos, parte dos quais foi permanentemente perdida. Claro, as pessoas não são perfeitas, mas os sistemas modernos de segurança da informação já podem controlar as ações de usuários privilegiados antes da execução de seus comandos. Se soluções como essas forem implementadas na Yandex ou na Amazon, incidentes semelhantes poderão ser evitados.
Resfriamento congelado
Em janeiro de 2017, ocorreu um grande acidente no data center da empresa ‘MegaFon’ em Dmitrov. Naquela época, a temperatura na região de Moscou caiu para -35 °C, o que levou à falha dos sistemas de resfriamento da instalação. O serviço de imprensa da operadora não divulgou amplamente as causas do incidente — as empresas russas são extremamente relutantes em falar sobre acidentes em suas instalações; em termos de transparência, estamos muito atrás do Ocidente. Nos meios sociais, havia uma versão de que o fluido de aquecimento havia congelado nos tubos enterrados nas ruas, resultando na fuga de etilenoglicol. Se acreditarmos nisso, o serviço de manutenção não conseguiu obter rapidamente 30 toneladas de refrigerante devido ao longo feriado e teve que improvisar usando recursos disponíveis, organizando um resfriamento improvisado, violando as regras de operação do sistema. O frio intenso agravou o problema - em janeiro, a Rússia passou a ter uma inesperada onda de frio, embora ninguém a esperasse. No final, a equipe teve que desligar parte dos racks de servidores, o que fez com que alguns serviços da operadora ficassem indisponíveis por dois dias.
Provavelmente, aqui também se pode falar de anomalias meteorológicas, mas temperaturas tão baixas não são incomuns para a região metropolitana. No inverno, a temperatura em Moscou pode cair ainda mais, por isso, os data centers são projetados para operar de forma estável a −42°C. Com frequência, os sistemas de resfriamento falham no frio devido à concentração insuficiente de glicóis e ao excesso de água na solução do fluido térmico. Problemas com a instalação de tubulações ou erros de cálculo no projeto e teste do sistema também ocorrem, geralmente relacionados ao desejo de economizar. Como resultado, ocorre um acidente sério que poderia ser evitado.
Desastres naturais
Com frequência, tempestades e/ou furacões interrompem a operação da infraestrutura do data center, levando à parada dos serviços e/ou danos físicos aos equipamentos. Incidentes provocados por condições meteorológicas adversas ocorrem com bastante frequência. Em 2012, o furacão Sandy passou pela costa oeste dos EUA, trazendo fortes chuvas. O data center da Peer 1, localizado em um edifício alto no Lower Manhattan, , após a água do mar salgada inundar os porões. Os geradores de emergência estavam localizados no 18º andar, e o fornecimento de combustível para eles era limitado — as regras implementadas em Nova York após os ataques de 11 de setembro proíbem o armazenamento de grandes quantidades de combustível nos andares superiores.
A bomba de combustível também falhou, então a equipe passou vários dias transportando diesel para os geradores manualmente. O heroísmo da equipe salvou o data center de um acidente sério, mas era realmente necessário? Vivemos em um planeta com uma atmosfera de nitrogênio-oxigênio e uma grande quantidade de água. Tempestades e furacões são comuns aqui (especialmente em áreas costeiras). Os projetistas deveriam considerar os riscos associados e construir um sistema de fornecimento de energia ininterrupto adequado. Ou pelo menos escolher um local mais apropriado para o data center do que um arranha-céu em uma ilha.
Tudo o mais
Nesta categoria, o Uptime Institute destaca uma variedade de incidentes, entre os quais é difícil escolher um típico. Roubo de cabos de cobre, invasões em data centers, postes de linhas de transmissão e subestações transformadoras, carros, incêndios que danificam fibras ópticas por escavadeiras, roedores (ratos, coelhos e até mesmo wombats, que pertencem aos marsupiais) e entusiastas que praticam tiro em fios — o menu é extenso. Falhas na alimentação elétrica podem ser causadas até mesmo por energia elétrica ilegal de maconha. Na maioria dos casos, os responsáveis pelo incidente são pessoas específicas, ou seja, estamos novamente lidando com o fator humano, quando o problema tem um nome e sobrenome. Mesmo que à primeira vista o acidente esteja relacionado a uma falha técnica ou a desastres naturais, pode ser evitado com um bom projeto do objeto e uma operação adequada. As exceções são casos de danos críticos à infraestrutura do data center ou destruição de edifícios e estruturas devido a desastres naturais. Essas são realmente circunstâncias de força maior, enquanto todos os outros problemas são causados pela conexão entre o computador e a cadeira — talvez esta seja a parte mais falha de qualquer sistema complexo.
Fonte: habr.com
