

A primeira API do MeuArmazém surgiu há 10 anos. Durante todo esse tempo, temos trabalhado nas versões existentes da API e desenvolvido novas. E já enterramos várias versões da API.
Este artigo trará muitos tópicos: como criamos a API, por que ela é necessária para um serviço em nuvem, o que oferece aos usuários, em quais armadilhas já caímos e o que queremos fazer a seguir.
Meu nome é Oleg Alexeev , sou diretor técnico e cofundador do MeuArmazém.
Por que criar uma API para o serviço
Nossos clientes, que somam dezenas de milhares de empreendedores, utilizam ativamente soluções em nuvem: serviços bancários, lojas online, controle de inventário, CRM. Após conectar-se a um, é difícil parar. E assim, o quinto, oitavo, décimo serviço facilita o trabalho do empreendedor, mas os dados entre esses serviços em nuvem têm que ser transferidos manualmente. O trabalho se torna um pesadelo.
A solução óbvia é dar aos usuários a possibilidade de transferir dados entre serviços em nuvem. Por exemplo, importar e exportar dados como arquivos que podem ser carregados no serviço desejado. Os arquivos geralmente precisam ser adaptados ao formato de cada serviço. Isso é um trabalho manual relativamente simples, mas, com o aumento do número desses serviços, torna-se cada vez mais complicado realizá-lo.
Portanto, o próximo passo é a API. Com ela, o serviço em nuvem se beneficia ao conectar vários serviços em um único ponto. O surgimento de um ecossistema assim atrai novos clientes, oferecendo possibilidades adicionais. Um produto com novas funcionalidades torna-se mais rentável e útil.
Se você criar suas próprias interfaces de programação, isso atrai vendedores externos na forma de programadores que conhecem seu produto graças à API. Eles começam a construir soluções com base na API oferecida e ganham dinheiro automatizando as tarefas de seus clientes.
O sistema de contabilidade do MeuArmazém é construído sobre processos simples. O principal é trabalhar com documentos primários, permitir receber e despachar mercadorias, e gerar relatórios de negócios com base nesses documentos. Também há transferência de dados, por exemplo, para contabilidade em nuvem, e recebimento de informações de sistemas bancários ou pontos de venda. Além disso, trabalhamos com lojas online: obtemos informações sobre produtos e enviamos dados sobre estoques.
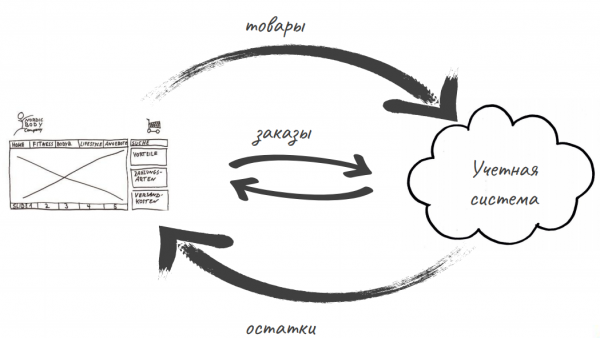
Primeiro API do MeuArmazém
Ao longo de 10 anos trabalhando com o API do MeuArmazém, desenvolvemos diversas integrações que permitem a troca de dados, interação com bancos, processamento de pagamentos e uso de telefonia externa.
No primeiro ano, tornamos possível exportar quaisquer dados no formato XML. Naquela época, os usuários entendiam melhor e preferiam manter os dados offline, ao invés de em alguma nuvem, e por isso oferecemos essa opção. A exportação era iniciada manualmente pelo interface. Assim, não podíamos ainda chamá-lo de API.
Foi também nesse período que começamos a colaborar com a empresa Rusagro — eles já utilizavam um ERP ‘maduro’ para planejamento de produção e distribuição, mas a carga dos vagões nas fábricas foi automatizada no MeuArmazém. Assim, surgiram as primeiras sementes de uma verdadeira API: a troca entre nosso serviço e o ERP era feita pela transmissão de um grande arquivo com dados de todos os tipos de documentos.
Essa é uma boa opção para troca em lote de dados, mas junto com os documentos era necessário enviar suas dependências: informações sobre produtos, contrapartes e armazéns. Essa bagunça é fácil de gerar na exportação, mas bastante difícil de lidar na importação, uma vez que em um único pacote chegam todas as informações: tanto sobre novos documentos quanto sobre os já existentes.
O primeiro API XML não sobreviveu por muito tempo — dois anos depois, começamos sua reestruturação. Desde o início de sua operação, cometemos alguns erros na construção da interface programática.
Como foi feito o API XML: ilustração de um dos nossos arquitetos. Aliás, fiquem atentos aos artigos dele.
Aqui estão nossos principais erros:
- A marcação JAXB foi feita diretamente nos beans de entidade. Para comunicação com o banco de dados, usamos Hibernate, e a mesma marcação JAXB foi aplicada a esses beans. Esse erro se manifestou quase imediatamente: qualquer atualização na estrutura de dados exigia uma notificação urgente a todos que utilizavam a API, ou a construção de gambiarras que garantissem a compatibilidade com a estrutura de dados anterior.
- A API surgiu como um complemento e, inicialmente, não definimos qual parte do produto ela formava. Não pensamos também se a API era algo importante ou se era necessário manter a compatibilidade retroativa para os seus primeiros clientes. Em certo momento, o número de usuários da API representou cerca de 5% do pequeno total, e não recebemos atenção. A filtragem universal feita na época levou a que nos usassem como backend. Essa filtragem não era exatamente GraphQL, mas algo parecido — funcionava através de inúmeros parâmetros na string de consulta. Com uma ferramenta tão poderosa, os usuários acharam difícil resistir, e as solicitações começaram a ser enviadas diretamente do UI de suas lojas online. A situação se tornou uma desagradável surpresa, pois fornecer tal serviço deveria exigir uma tarifação diferente e, de modo geral, uma compreensão diferente da própria API como produto.
- Devido ao fato de que a API não se desenvolveu como um produto principal, a documentação da API foi criada e publicada por um processo secundário — através de engenharia reversa. Esse caminho parece bastante simples e conveniente, mas contradiz o trabalho baseado em contrato. Isso é quando existe um componente com um esquema de trabalho pré-estabelecido. O desenvolvedor o realiza de acordo com esse esquema e tarefa, o componente é testado, e o cliente recebe um produto que corresponde à ideia do analista. Já a engenharia reversa joga no mercado um produto que simplesmente existe: com gambiarras, soluções estranhas e bicicletas no lugar da funcionalidade necessária.
- Todo o fluxo de solicitações que chegava pela API só podia ser analisado como um log do Nginx ou do servidor de aplicação. Isso não permitiu identificar áreas temáticas, exceto para segmentar por usuários e assinantes. Se não há como regular o registro de aplicativos ou clientes, torna-se impossível analisar a situação. Esse problema afetou o desenvolvimento da API em menor grau, ele está mais relacionado à compreensão da sua demanda e ao preenchimento de funcionalidades.
Tentativa número dois: REST API
Em 2010, tentamos construir um sistema de troca com a contabilidade online - BukhSoft. Não decolou. No entanto, durante o processo de integração, surgiu uma API completa: um serviço REST de intercâmbio, onde não havia arbitrariedades como chamadas de operações em forma de RPC. Toda a comunicação com a API foi reduzida ao modo padrão para REST: na string de requisição, contém-se o nome da entidade, e a operação realizada com ela é definida através do método HTTP. Adicionamos filtragem com base no momento da atualização das entidades, permitindo aos usuários construir replicações com seus sistemas.
No mesmo ano, foi lançada a API para exportar saldos de estoque e produtos. As partes mais valiosas do sistema tornaram-se disponíveis para os usuários através da API - a troca de documentos primários e dados de cálculos sobre saldos e custo dos produtos.
Em dezembro de 2015, a RetailCRM publicou a primeira biblioteca de terceiros para acesso à nossa API. Ela passou a ser utilizada de forma bastante ativa, e a popularidade do serviço, como um todo, cresceu, com a carga na API aumentando mais rapidamente do que no interface web. Em um certo momento, o crescimento se transformou em um salto na carga.
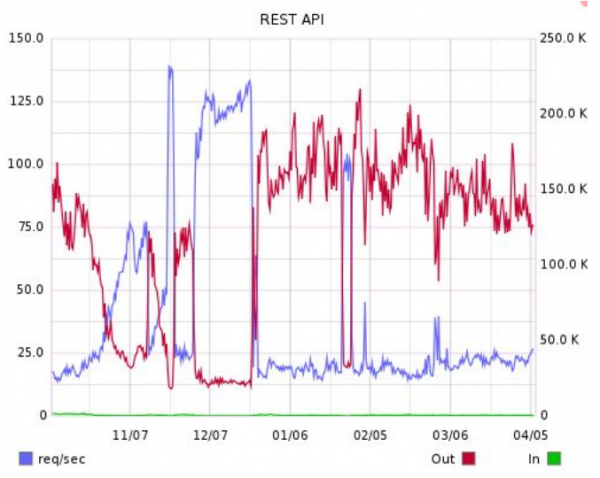
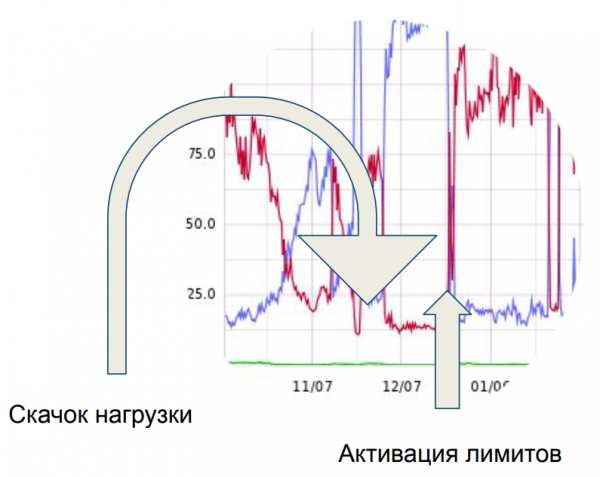
E esse salto, indicado pela seta à esquerda, deixou o servidor que atende nossa API completamente perplexo. Passamos uma semana tentando entender o que exatamente estava gerando essa carga. Descobrimos que eram aquelas mesmas requisições, transmitidas para nossa API a partir das frentes dos clientes. Cerca de 50 clientes geraram tudo isso. Foi então que percebemos um de nossos erros - a completa ausência de limites.
Como resultado, introduzimos um limite no número de requisições simultâneas. De uma conta, agora era possível abrir no máximo duas requisições ao mesmo tempo. Isso é suficiente para trabalhar em modo de replicação para troca de dados em modo em lote. E aqueles que queriam nos utilizar como backend foram forçados a se adaptar mais aos planos, uma vez que introduzimos em suas ferramentas de software o trabalho com várias contas.
Organizando
Desde 2014, a demanda pela API existente tornou-se uma parte importante do negócio, e a própria API gerava o maior volume de dados na troca de informações com os clientes. Em 2015, iniciamos o projeto de organização da API. Escolhemos o formato JSON em vez de XML e começamos a construí-lo com base nas particularidades que identificamos ao implementar a versão anterior:
- Capacidade de gerenciar versões. A versão permite desenvolver uma nova versão sem afetar o aplicativo existente e sem interromper o funcionamento dos usuários.
- Capacidade do usuário de visualizar os metadados na própria resposta que recebe.
- Capacidade de compartilhar grandes documentos. Quando processamos um documento com mais de 4-5 mil itens, isso se torna um problema para o servidor: transações longas, solicitações HTTP longas. Desenvolvemos um mecanismo especial que permite atualizar o documento em partes e gerenciar itens individuais desse documento, enviando-os para o servidor.
- Ferramentas para replicação — já existiam na versão anterior.
- Limites de carga — como legado dos erros cometidos na versão anterior. Introduzimos limites na quantidade de solicitações em um intervalo de tempo, na quantidade de solicitações simultâneas e nas solicitações de um único endereço IP.
Desde então, lançamos duas versões menores da API e iniciamos várias APIs especializadas, mas de forma geral a abordagem permaneceu inalterada. O formato de troca atualizado e a nova arquitetura permitiram corrigir falhas na API muito mais rapidamente.
API do Meu Estoque hoje
Hoje, a API do Meu Estoque resolve muitas tarefas:
- troca de dados com lojas online, sistemas de contabilidade, bancos;
- obtendo dados de cálculos, relatórios;
- uso como backend para aplicativos clientes — nossos aplicativos móveis e o caixa desktop operam através da API
- envio de notificações sobre alterações de dados no Meu Estoque — webhooks;
- telefonia;
- sistemas de fidelidade.
Com base na API, nosso CEO Askar Rakhimberdieff em quatro horas escreveu um bot para Telegram que puxa os dados de estoque através da API:
Agora, os números secos.
Aqui estão nossas estatísticas sobre a antiga API REST:
- 400 empresas;
- 600 usuários;
- 2 milhões de solicitações por dia;
- 200 GB/dia de tráfego de saída.
E aqui está o que conseguimos com todas as APIs do Meu Estoque:
- mais de 70 integrações (parte delas pode ser vista aqui );
- 8500 empresas;
- 12.000 usuários;
- 46 milhões de solicitações por dia;
- 2 TB/dia de tráfego de saída.
O que vem a seguir
Os planos de desenvolvimento da API estão em ativa discussão. Estamos tentando levar em conta a experiência de operação que nossos usuários nos fornecem. Nem sempre conseguimos fazer tudo de uma vez, mas não está longe uma nova versão da API com metadados mais amigáveis e uma estrutura menos complicada, OAuth para autenticação e uma API para aplicações integradas na interface.
Você pode acompanhar as novidades em um site especial para desenvolvedores de integrações com o MeuArmazém: .
Fonte: habr.com
