

Antecedentes
Ocorreu que o servidor foi atacado por um vírus de ransomware, que por "sorte", deixou parcialmente intactos os arquivos .ibd (arquivos de dados brutos das tabelas innodb), mas criptografou completamente os arquivos .fpm (arquivos de estrutura). Assim, os .idb puderam ser classificados como:
- passíveis de recuperação através de ferramentas e guias padrão. Para esses casos, há uma excelente ;
- tabelas parcialmente criptografadas. Principalmente, são grandes tabelas que, como eu entendi, os criminosos não tiveram memória suficiente para a criptografia completa;
- e tabelas completamente criptografadas, que não podem ser recuperadas.
Determinar a qual desses casos pertencem as tabelas foi conseguido de maneira simples, abrindo em qualquer editor de texto com a codificação necessária (no meu caso, UTF8) e apenas visualizando o arquivo em busca de campos de texto, por exemplo:
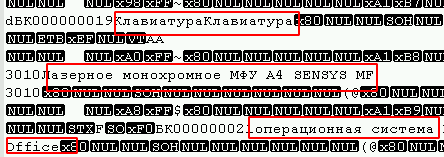
Além disso, no início do arquivo, é possível observar uma grande quantidade de bytes 0, e vírus que utilizam algoritmos de criptografia de bloco (os mais comuns) geralmente também os afetam.

No meu caso, os criminosos deixavam no final de cada arquivo criptografado uma sequência de 4 bytes (1, 0, 0, 0), o que facilitou a tarefa. Para encontrar arquivos não infectados, um script foi suficiente:
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) - 4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
Dessa forma, consegui encontrar os arquivos pertencentes ao primeiro tipo. O segundo implica um longo trabalho manual, mas já encontrei o suficiente. Tudo estaria bem, mas é necessário saber a estrutura exata e (claro) surgiu o caso em que tive que trabalhar com uma tabela que mudava frequentemente. Ninguém se lembrava se o tipo de campo havia mudado ou se havia sido adicionado uma nova coluna.
Infelizmente, a equipe da Debris City não pôde ajudar com esse caso, por isso estou escrevendo este artigo.
Voltando ao assunto
A estrutura da tabela há 3 meses não coincide com a atual (possivelmente em um campo ou talvez mais). A estrutura da tabela:
CRIE A TABELA `table_1` (
    `id` INT (11),
    `data` DATETIME ,
    `descrição` TEXT ,
    `id_ponto` INT (11),
    `id_usuario` INT (11),
    `data_inicio` DATETIME ,
    `data_fim` DATETIME ,
    `foto` INT (1),
    `id_cliente` INT (11),
    `status` INT (1),
    `tempo_lead` TIME ,
    `status_envio` TINYINT (4)
);
nesse caso, é necessário extrair:
id_pontoINT (11);id_usuarioINT (11);data_inicioDATETIME ;data_fimDATETIME .
Para a recuperação, utiliza-se a análise byte a byte do arquivo .ibd, seguida da conversão em um formato mais legível. Como para encontrar o que é necessário, basta analisar tipos de dados como int e datetime, o artigo descreverá apenas eles, mas às vezes farei referência a outros tipos de dados, que podem ajudar em outras situações semelhantes.
Problema 1: nos campos com tipos DATETIME e TEXT, havia valores NULL, e eles simplesmente são omitidos no arquivo, por isso, não consegui determinar a estrutura para a recuperação no meu caso. Nas novas colunas, o valor padrão foi null, e parte da transação pode ter sido perdida devido à configuração innodb_flush_log_at_trx_commit = 0, portanto, levaria mais tempo para determinar a estrutura.
Problema 2: deve-se considerar que as linhas excluídas através do DELETE ainda estarão no arquivo ibd, mas ao fazer ALTER TABLE, sua estrutura não será atualizada. Como resultado, a estrutura dos dados pode variar do início ao fim do arquivo. Se você usa frequentemente OPTIMIZE TABLE, provavelmente não enfrentará esse tipo de problema.
Note que, a versão do SGBD influencia a forma de armazenamento dos dados, e este exemplo pode não funcionar para outras versões principais. No meu caso, foi utilizada a versão Windows do mariadb 10.1.24. Além disso, mesmo que você trabalhe com tabelas InnoDB no mariadb, na prática, elas são , o que exclui a aplicabilidade do método com InnoDB mysql.
Análise do arquivo
Em Python, o tipo de dados representa dados em unicode em vez de um conjunto comum de números. Embora o arquivo possa ser visualizado dessa maneira, para conveniência, pode-se converter bytes em formato numérico, transformando o array de bytes em um array comum (list(example_byte_array)). De qualquer forma, ambos os métodos serão úteis para análise.
Após examinar vários arquivos ibd, podem-se encontrar os seguintes:
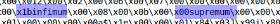
Além disso, se dividirmos o arquivo por essas palavras-chave, obteremos predominantemente blocos de dados razoavelmente uniformes. Usaremos infimum como divisor.
table = table.split("infimum".encode())Uma observação interessante é que, para tabelas com uma pequena quantidade de dados, entre o infimum e o supremum há um indicador do número de linhas no bloco.
 — tabela de teste com 1 linha
 — tabela de teste com 2 linhas
O array de linhas table[0] pode ser ignorado. Ao visualizá-lo, não consegui encontrar os dados brutos das tabelas. Provavelmente, este bloco serve para armazenar índices e chaves.
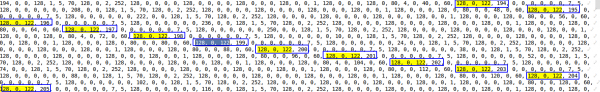
A partir de table[1] e convertendo-a em um array numérico, já é possível notar certas regularidades, a saber:
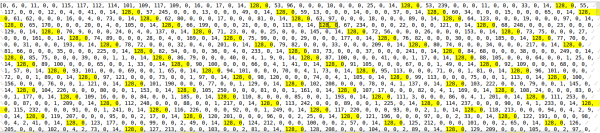
Estes são valores inteiros armazenados na linha. O primeiro byte indica se o número é positivo ou negativo. No meu caso, todos os números são positivos. Dos outros 3 bytes, é possível determinar o número usando a seguinte função. Script:
def find_int(val: str):  # exemplo '128, 1, 2, 3'
    val = [int(v) for v in  val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
Por exemplo, 128, 0, 0, 1 = 1, ou 128, 0, 75, 108 = 19308.
A tabela tinha uma chave primária com auto-incremento, e aqui também é possível encontrá-la.
Ao correlacionar os dados das tabelas de teste, foi identificado que o objeto DATETIME consiste em 5 bytes, começando com 153 (provavelmente indica intervalos de ano). Como o intervalo DATTIME vai de '1000-01-01' a '9999-12-31', penso que o número de bytes pode variar, mas no meu caso, os dados estão no intervalo de 2016 a 2019, portanto vamos considerar que 5 bytes são suficientes.
Para determinar o tempo sem segundos, foram escritas as seguintes funções. Script:
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    if x1 % 2 == 0:
        return x2 // 16
    elif x1 % 2 == 1:
        return x2 // 16 + 16
    else:
        raise ValueError

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
Para o ano e o mês, não consegui escrever uma função que funcionasse corretamente, então precisei codificar à mão. Script:
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 // 64 == value[2] // 64:
            return key
    return 0, 0
Tenho certeza de que, se gastarmos um certo tempo, essa confusão pode ser resolvida.
A seguir, uma função que retorna um objeto datetime a partir de uma string. Script:
def find_data_time(val:str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Conseguimos identificar valores frequentemente repetidos de int, int, datetime, datetime 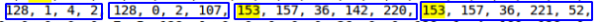 , parece que isso é o que precisamos. E, além disso, tal sequência não se repete duas vezes na string.
Usando uma expressão regular, encontramos os dados necessários:
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Observe que ao buscar por esta expressão, não será possível identificar valores NULL nos campos requeridos, mas, no meu caso, isso não é crítico. Depois, iteramos sobre o encontrado. Script:
resultado = []
for val in fined:
    pre_result = []
    bd_int = re.findall(r"128, d*, d*, d*", val)
    bd_date = re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    for it in bd_int:
        pre_result.append(find_int(bd_int[it]))
    for bd in bd_date:
        pre_result.append(find_data_time(bd))
    result.append(pre_result)
Na verdade, todos os dados do array result são os dados que precisamos. ###PS.###
Entendo que esse método pode não ser adequado para todos, mas o principal objetivo do artigo é mais inspirar a ação do que resolver todos os seus problemas. Acredito que a solução mais correta seria começar a estudar o código fonte em si. , mas devido ao tempo limitado, o método atual pareceu ser o mais rápido.
Em alguns casos, analisando o arquivo, você poderá determinar a estrutura aproximada e restaurá-la de uma das maneiras padrão mencionadas acima. Isso será muito mais correto e causará menos problemas.
Fonte: habr.com
