

Nós fizemos isso!
«O objetivo deste curso é prepará-lo para seu futuro técnico.»
 Olá, Habr. Lembra daquela incrível artigo (+219, 2588 nos favoritos, 429k leituras)?
Então, sobre os Códigos de Hamming (sim, sim, autocorrigidos e autocorretivos ) existe um , escrito com base em suas palestras. Estamos traduzindo-o, porque o cara fala a verdade.
Este livro não é apenas sobre TI, é um livro sobre o estilo de pensamento de pessoas incrivelmente legais. «Não é apenas uma carga de pensamento positivo; descreve as condições que aumentam as chances de fazer um grande trabalho.»
A tradução é agradecida a Andrey Pakhomov.
A Teoria da Informação foi desenvolvida por C. E. Shannon no final dos anos 1940. A direção dos Laboratórios Bell insistiu para que ele a chamasse de «Teoria da Comunicação», pois esse é um título muito mais preciso. Por razões óbvias, o título «Teoria da Informação» tem um impacto significativamente maior sobre o público, por isso Shannon escolheu esse, e é assim que ela é conhecida até hoje. O próprio nome sugere que a teoria lida com informação, e isso é o que a torna importante, pois estamos cada vez mais imersos na era da informação. Neste capítulo, mencionarei algumas conclusões principais dessa teoria, fornecerei provas não rigorosas, mas mais intuitivas de algumas seções individuais dessa teoria, para que você entenda o que realmente é a «Teoria da Informação», onde você pode aplicá-la e onde não pode.
Primeiro de tudo, o que é “informação”? Shannon identifica informação com incerteza. Ele escolheu o logaritmo negativo da probabilidade de um evento como medida quantitativa da informação que você obtém quando um evento com probabilidade p ocorre. Por exemplo, se eu lhe disser que em Los Angeles o clima está nebuloso, então p está próximo de 1, o que de fato não nos dá muita informação. Mas se eu disser que em junho em Monterey está chovendo, então essa informação terá uma incerteza, e conterá mais informação. Um evento certo não contém informação, pois log 1 = 0.
Vamos nos aprofundar nisso. Shannon acreditava que a medida quantitativa da informação deveria ser uma função contínua da probabilidade do evento p, e para eventos independentes, deveria ser aditiva – a quantidade de informação obtida ao realizar dois eventos independentes deveria ser igual à quantidade de informação obtida ao realizar um evento conjunto. Por exemplo, o resultado do lançamento de um dado e de uma moeda é geralmente considerado como eventos independentes. Vamos traduzir o que foi dito para a linguagem matemática. Se I(p) é a quantidade de informação contida em um evento com probabilidade p, então, para um evento conjunto que consiste em dois eventos independentes x com probabilidade p1 e y com probabilidade p2, obtemos
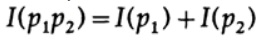
(x e y são eventos independentes)
Esta é a equação funcional de Cauchy, verdadeira para todos p1 e p2. Para resolver esta equação funcional, suponhamos que
p1 = p2 = p,
isso nos dá
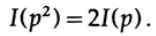
Se p1 = p2 e p2 = p, então
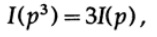
e assim por diante. Expandindo esse processo, usando o método padrão para exponenciais, para todos os números racionais m/n, temos o seguinte
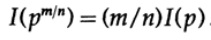
Da suposta continuidade da medida de informação, verifica-se que a função logarítmica é a única solução contínua da equação funcional de Cauchy.
Na teoria da informação, é comum tomar a base do logaritmo igual a 2, portanto, uma escolha binária contém exatamente 1 bit de informação. Assim, a informação é medida pela fórmula
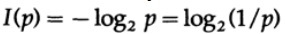
Vamos parar e entender o que aconteceu acima. Primeiro, não definimos o conceito de “informação”, apenas definimos a fórmula para sua medida quantitativa.
Em segundo lugar, essa medida depende da incerteza e, embora seja adequada para máquinas – como sistemas telefônicos, rádio, televisão, computadores, etc. – ela não reflete a relação normal dos humanos com a informação.
Em terceiro lugar, é uma medida relativa, dependendo do estado atual do seu conhecimento. Se você observa um fluxo de “números aleatórios” de um gerador de números aleatórios, você presume que cada número seguinte é incerto, mas, se você conhece a fórmula para calcular os
Assim, a definição dada por Shannon para informação, em muitos casos, se aplica a máquinas, mas parece não corresponder ao entendimento humano dessa palavra. Por esse motivo, a "Teoria da Informação" deveria ter sido chamada de "Teoria da Comunicação". No entanto, já é tarde demais para mudar as definições (graças às quais a teoria ganhou popularidade inicial e que ainda fazem as pessoas pensarem que essa teoria lida com "informação"), portanto, temos que nos conformar com elas, mas você deve entender claramente o quão distante está a definição de informação dada por Shannon de seu significado comum. A informação de Shannon lida com algo completamente diferente, a saber, incerteza.
Aqui está algo para se considerar ao propor qualquer terminologia. Quão bem a definição proposta, por exemplo, a definição de informação dada por Shannon, se alinha à sua ideia original e quão diferente ela é? Quase não há termos que reflitam exatamente sua visão anterior do conceito, mas, no final, a terminologia utilizada reflete o significado do conceito, portanto, a formalização de algo por meio de definições claras sempre introduz algum ruído.
Vamos considerar um sistema cujo alfabeto consiste em símbolos q com probabilidades pi. Nesse caso, a quantidade média de informação no sistema (seu valor esperado) é igual a:
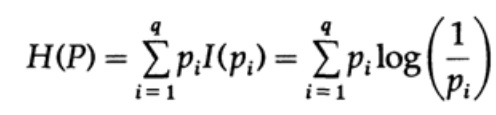
Isso é chamado de entropia do sistema com a distribuição de probabilidade {pi}. Usamos o termo "entropia" porque a mesma forma matemática aparece na termodinâmica e na mecânica estatística. É por isso que o termo "entropia" cria uma certa aura de importância que, em última análise, não é justificada. A mesma forma matemática de registro não implica na mesma interpretação dos símbolos!
A entropia da distribuição de probabilidade desempenha um papel central na teoria da codificação. A desigualdade de Gibbs para duas distribuições de probabilidade diferentes pi e qi é uma das consequências importantes dessa teoria. Portanto, devemos provar que
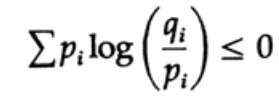
A prova se baseia em um gráfico óbvio, fig. 13.I, que mostra que
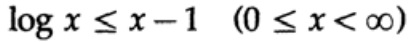
e a igualdade é alcançada apenas quando x = 1. Apliquemos a desigualdade a cada termo da soma do lado esquerdo:
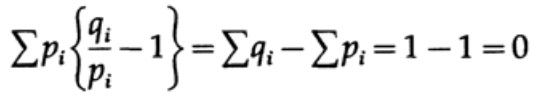
Se o alfabeto do sistema de comunicação consiste em q símbolos, então, assumindo a probabilidade de transmissão de cada símbolo qi = 1/q e substituindo q, obtemos a partir da desigualdade de Gibbs.
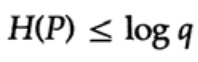
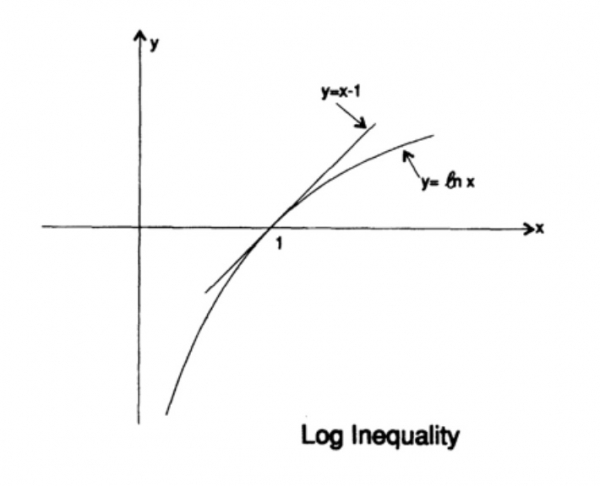
Figura 13.I
Isso significa que se a probabilidade de transmissão de todos os q símbolos é igual a 1/q, a entropia máxima é igual a ln q; caso contrário, a desigualdade é satisfeita.
No caso de um código decodificável único, temos a desigualdade de Kraft.
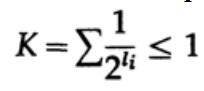
Agora, se definirmos as pseudoprobabilidades
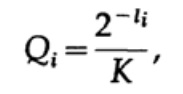
onde é finito 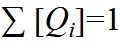 = 1, o que se segue da desigualdade de Gibbs,
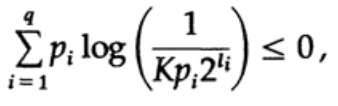
e aplicando um pouco de álgebra (lembre-se de que K ≤ 1, portanto podemos descartar o termo logarítmico, e talvez fortalecer a desigualdade mais tarde), obtemos
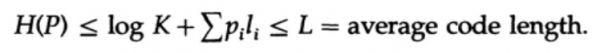
onde L é o comprimento médio do código.
Assim, a entropia é um limite mínimo para qualquer código caracter por caracter com comprimento médio do código L. Este é o teorema de Shannon para um canal sem ruído.
Agora, consideremos o teorema principal sobre as limitações dos sistemas de comunicação, onde a informação é transmitida como um fluxo de bits independentes e há ruído presente. Presume-se que a probabilidade de transmissão correta de um bit P > 1/2, e a probabilidade de que o valor do bit seja invertido durante a transmissão (ocorra um erro) é Q = 1 - P. Para conveniência, vamos supor que os erros são independentes e que a probabilidade de erro é a mesma para cada bit enviado — ou seja, há um "ruído branco" no canal de comunicação.
Temos um longo fluxo de n bits codificados em uma única mensagem — uma extensão n-dimensional de um código de um bit. O valor de n será definido mais tarde. Consideremos a mensagem composta por n bits como um ponto em um espaço n-dimensional. Como temos um espaço n-dimensional — e para simplificar, vamos supor que cada mensagem tem a mesma probabilidade de ocorrência — existe M mensagens possíveis (M também será definido mais tarde); portanto, a probabilidade de qualquer mensagem enviada é

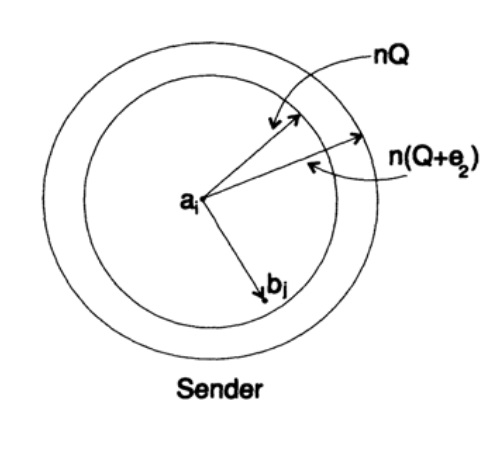
(remetente)
Gráfico 13.II
Vamos agora examinar a ideia da largura de banda do canal. Sem entrar em detalhes, a largura de banda do canal é definida como a quantidade máxima de informação que pode ser transmitida de forma confiável por um canal de comunicação, considerando o uso de codificação máxima e eficiente. Não há argumentos a favor de que mais informação possa ser transmitida por um canal de comunicação do que sua capacidade. Isso pode ser provado para um canal binário simétrico (que é o que estamos usando neste caso). A capacidade do canal, em transmissão bit a bit, é dada como
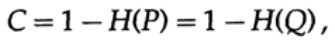
onde, como antes, P é a probabilidade de não haver erro em qualquer bit enviado. Ao enviar n bits independentes, a capacidade do canal é definida como
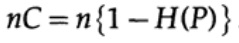
Se estamos próximos da largura de banda do canal, devemos enviar quase a mesma quantidade de informação para cada um dos símbolos ai, i = 1, …, M. Considerando que a probabilidade de ocorrência de cada símbolo ai é 1 / M, chegamos à conclusão que
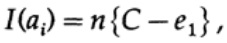
quando enviamos uma das M mensagens igualmente prováveis ai, temos
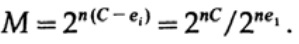
Ao enviar n bits, esperamos a ocorrência de nQ erros. Na prática, para uma mensagem composta por n bits, teremos aproximadamente nQ erros na mensagem recebida. Com grandes n, a variação relativa ( variação = largura da distribuição, )
da distribuição do número de erros se tornará cada vez mais estreita com o aumento de n.
Assim, do lado do transmissor, eu pego a mensagem ai para enviar e traço uma esfera ao seu redor com um raio de
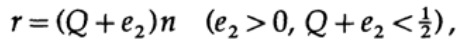
que é ligeiramente maior do que a quantidade igual a e2, do que o número esperado de erros Q, (figura 13.II). Se n for grande o suficiente, existe uma probabilidade tão pequena quanto se queira da ocorrência do ponto da mensagem bj no lado do receptor, que ultrapassa os limites dessa esfera. Vamos ilustrar a situação, como a vejo do ponto de vista do transmissor: temos quaisquer raios da mensagem enviada ai até a mensagem recebida bj com a probabilidade de erro igual (ou quase igual) à distribuição normal, atingindo seu pico em nQ. Para qualquer e2 dado, existe n suficientemente grande, de modo que a probabilidade de que o ponto recebido bj, que ultrapassa os limites da minha esfera, será tão pequena quanto desejarem.
Agora vamos considerar essa mesma situação do seu lado (fig. 13.III). Do lado do receptor, há uma esfera S( r) do mesmo raio r ao redor do ponto recebido bj no espaço de n dimensões, tal que se a mensagem recebida bj estiver dentro da minha esfera, então a mensagem enviada por mim ai está dentro da sua esfera.
Como pode ocorrer um erro? Um erro pode ocorrer nos casos descritos na tabela abaixo:
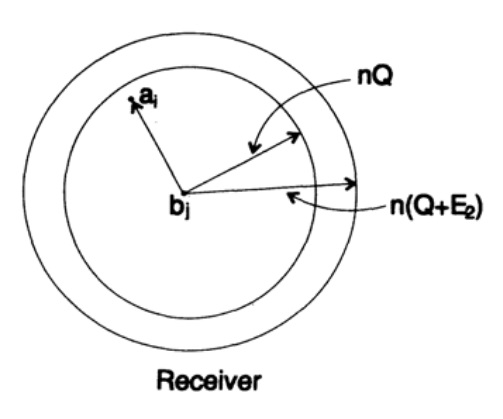
Figura 13.III
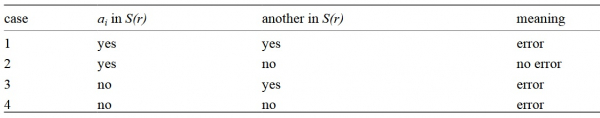
Aqui vemos que, se existir pelo menos mais um ponto na esfera construída em torno do ponto recebido, correspondente a uma possível mensagem enviada não codificada, então ocorreu um erro na transmissão, pois você não pode determinar qual das mensagens foi de fato transmitida. A mensagem enviada não contém erro, apenas se o ponto correspondente a ela está na esfera, e não existem outros pontos possíveis no código que estejam na mesma esfera.
Temos uma equação matemática para a probabilidade de erro Pe, se a mensagem ai foi enviada
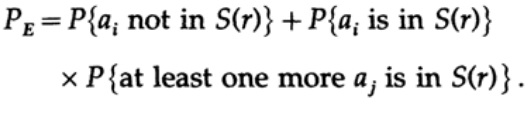
Podemos descartar o primeiro fator no segundo termo, considerando-o como 1. Assim, obtemos uma desigualdade
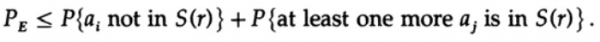
É evidente que
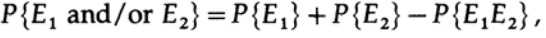
Portanto
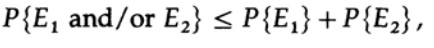
aplicamos novamente ao último termo à direita
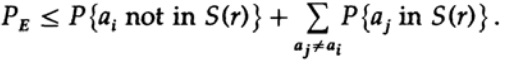
Considerando n suficientemente grande, o primeiro termo pode ser considerado tão pequeno quanto desejarmos, digamos, menor que um certo número d. Portanto, temos
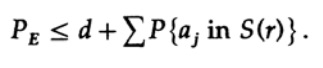
Agora vamos considerar como podemos construir um código de substituição simples para codificar M mensagens compostas de n bits. Sem ter uma ideia clara de como construir o código (códigos com correção de erro ainda não tinham sido inventados), Shannon escolheu a codificação aleatória. Lançamos uma moeda para cada um dos n bits na mensagem e repetimos o processo para M mensagens. No total, fazemos nM lançamentos de moeda, portanto, são possíveis

dicionários de código, todos com a mesma probabilidade de ½nM. Claro, o processo aleatório de criação do dicionário de código significa que existe a probabilidade de aparecimento de duplicatas, bem como de pontos de código que estarão próximos uns dos outros e, consequentemente, serão fontes prováveis de erros. É necessário provar que, se isso não ocorrer com uma probabilidade superior a qualquer nível de erro pequeno escolhido, então o dado n é suficientemente grande.
O ponto decisivo é que Shannon média todas as possíveis tabelas de códigos para encontrar o erro médio! Vamos usar o símbolo Av [.], para denotar a média de um conjunto de todos os possíveis dicionários de palavras de código aleatórias. A média por uma constante d, obviamente, resulta em uma constante, pois para a média cada membro coincide com qualquer outro membro na soma.
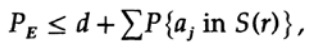
que pode ser aumentado (M–1 passa a M)
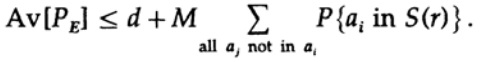
Para qualquer mensagem específica, ao fazer a média de todos os livros de códigos, a codificação percorre todos os valores possíveis, portanto, a probabilidade média de que um ponto esteja na esfera é a relação entre o volume da esfera e o volume total do espaço. O volume da esfera é dado por
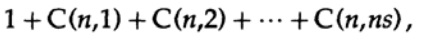
onde s=Q+e2 <1/2 e ns deve ser um número inteiro.
O último termo à direita é o maior desta soma. Primeiro, avaliaremos seu valor pela fórmula de Stirling para fatoriais. Em seguida, examinaremos o coeficiente de diminuição do termo anterior, observando que esse coeficiente aumenta ao mover-se para a esquerda, e, portanto, podemos: (1) limitar o valor da soma com a soma de uma progressão geométrica com esse coeficiente inicial, (2) expandir a progressão geométrica com ns termos para um número infinito de termos, (3) calcular a soma da progressão geométrica infinita (álgebra padrão, nada de substancial) e, finalmente, obter o valor limite (para n suficientemente grande):
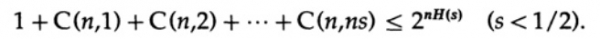
Observe como a entropia H(s) surgiu na identidade binomial. Note que a expansão em série de Taylor H(s)=H(Q+e2) dá uma estimativa que considera apenas a primeira derivada e ignora todas as restantes. Agora, vamos reunir a expressão final:
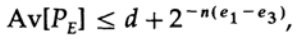
onde
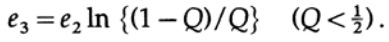
Tudo o que precisamos fazer é escolher e2 de modo que e3 < e1, e então o último termo pode ser tão pequeno quanto quisermos, com n suficientemente grande. Portanto, o erro médio PE pode ser obtido tão pequeno quanto desejarmos com uma largura de banda do canal o mais próxima possível de C.
Se o valor médio para todos os códigos tiver um erro suficientemente pequeno, pelo menos um código deve ser adequado; portanto, existe pelo menos um sistema de codificação apropriado. Este é um resultado importante obtido por Shannon — "teorema de Shannon para canais ruidosos", embora deva ser notado que ele provou isso para um caso muito mais geral do que o simples canal binário simétrico que usei. Para o caso geral, os cálculos matemáticos são muito mais complexos, mas as ideias não são tão diferentes, então muitas vezes é possível revelar o verdadeiro significado do teorema através de um exemplo particular.
Vamos criticar o resultado. Repetimos várias vezes: "Para n suficientemente grande". Mas quão grande deve ser n? Muito, muito grande, se você realmente quer estar simultaneamente perto da capacidade do canal e ter certeza na transmissão correta dos dados! Tão grande que, na verdade, você vai ter que esperar muito tempo para acumular uma mensagem de tal número de bits para depois codificá-la. Nesse momento, o tamanho do dicionário do código aleatório será simplesmente enorme (afinal, tal dicionário não pode ser representado de forma mais curta do que uma lista completa de todos os bits Mn, considerando que n e M são muito grandes)!
Os códigos de correção de erros evitam esperar uma mensagem muito longa, com sua subsequente codificação e decodificação através de livros de códigos muito grandes, porque evitam livros de códigos como tal e usam em vez disso cálculos comuns. Na teoria simples, tais códigos geralmente perdem a capacidade de se aproximar da capacidade do canal e ao mesmo tempo manter uma frequência de erros suficientemente baixa, mas, quando o código corrige um grande número de erros, eles apresentam bons resultados. Em outras palavras, se você aloca alguma capacidade do canal para correção de erros, você deve usar a capacidade de correção de erros na maior parte do tempo, ou seja, em cada mensagem enviada, um grande número de erros deve ser corrigido, caso contrário, você perde essa capacidade em vão.
No entanto, o teorema comprovado acima ainda não é sem sentido! Ele mostra que sistemas de transmissão eficazes devem utilizar esquemas elaborados de codificação para sequências de bits muito longas. Um exemplo são os satélites que se afastaram das planetas externas; à medida que se afastam da Terra e do Sol, são forçados a corrigir um número cada vez maior de erros em um bloco de dados: alguns satélites utilizam painéis solares que fornecem cerca de 5 W, outros utilizam fontes de alimentação atômicas que fornecem aproximadamente a mesma potência. A fraca potência da fonte de alimentação, o pequeno tamanho das antenas transmissoras e as dimensões limitadas das antenas receptoras na Terra, e a enorme distância que o sinal deve percorrer — tudo isso exige a utilização de códigos com alto nível de correção de erros para construir um sistema de comunicação eficaz.
Voltemos ao espaço n-dimensional que utilizamos na prova acima. Discutindo isso, mostramos que quase todo o volume da esfera está concentrado na superfície externa, — assim, é quase certo que o sinal enviado estará localizado na superfície da esfera construída em torno do sinal recebido, mesmo com um raio relativamente pequeno dessa esfera. Portanto, não é surpreendente que o sinal recebido, após a correção de um número arbitrariamente grande de erros, nQ, se aproxime do sinal sem erros. A capacidade do canal de comunicação que consideramos anteriormente é a chave para entender esse fenômeno. Note que esferas semelhantes, construídas para códigos de Hamming com correção de erros, não se sobrepõem. Um grande número de dimensões praticamente ortogonais no espaço n-dimensional mostra por que podemos acomodar M esferas no espaço com pouca sobreposição. Se permitirmos uma pequena sobreposição, que pode levar apenas a um pequeno número de erros durante a decodificação, é possível obter uma disposição densa de esferas no espaço. Hamming garantiu um certo nível de correção de erros, Shannon — uma baixa probabilidade de erro, mas ao mesmo tempo mantendo a capacidade efetiva tão próxima quanto possível da capacidade do canal de comunicação, algo que os códigos de Hamming não podem fazer.
A teoria da informação não diz como projetar um sistema eficiente, mas indica a direção a seguir em direção a sistemas de comunicação eficazes. É uma ferramenta valiosa para construir sistemas de comunicação entre máquinas, mas, como mencionado anteriormente, tem pouco a ver com a forma como as pessoas trocam informações entre si. O grau em que a herança biológica é semelhante a sistemas de comunicação técnicos é simplesmente desconhecido, portanto, neste momento, não está claro o quanto a teoria da informação é aplicável aos genes. Não temos outra opção a não ser tentar, e se o sucesso nos mostrar a natureza semelhante à máquina desse fenômeno, a falha indicará outros aspectos importantes da natureza da informação.
Vamos nos desviar um pouco. Vimos que todas as definições iniciais, em maior ou menor grau, devem expressar a essência de nossas crenças fundamentais, mas elas apresentam um certo grau de distorção, e, portanto, tornam-se ineficazes. Tradicionalmente, acredita-se que, em última análise, a definição que usamos realmente define a essência; mas isso apenas nos indica como tratar as coisas e de maneira alguma carrega algum significado. A abordagem postulacional, muito aprovada em círculos matemáticos, deixa a desejar na prática.
Agora vamos considerar um exemplo de testes de QI, onde a definição é tão cíclica quanto você quiser, e isso acaba te confundindo. Um teste é criado, que supostamente deve medir a inteligência. Depois, ele é revisto para ser o mais consistente possível, e então publicado e calibrado de um modo simples, para que a "inteligência" medida seja normalmente distribuída (é claro, seguindo a curva de calibração). Todas as definições devem ser revisitadas, não apenas quando são inicialmente propostas, mas também muito tempo depois, quando são usadas em conclusões feitas. Em que medida as fronteiras das definições são adequadas para a tarefa em questão? Com que frequência as definições fornecidas em determinadas condições começam a ser aplicadas em condições suficientemente diferentes? Isso acontece com bastante frequência! Nas ciências humanas, com as quais você inevitavelmente se deparará em sua vida, isso ocorre com mais frequência.
Assim, um dos objetivos desta apresentação sobre a teoria da informação, além de demonstrar sua utilidade, foi alertá-lo sobre esse perigo, ou mostrar como utilizá-la para obter o resultado desejado. Há muito se observa que as definições iniciais condicionam muito do que você encontra no final, muitas vezes mais do que parece. As definições iniciais exigem de você muita atenção não apenas em cada nova situação, mas também em áreas que você já conhece há muito tempo. Isso permitirá que você compreenda em que medida os resultados obtidos são uma tautologia, e não algo útil.
A famosa história de Eddington fala sobre pessoas que pescavam no mar com uma rede. Ao estudarem o tamanho dos peixes que capturaram, definiram o tamanho mínimo do peixe que habita o mar! Sua conclusão foi condicionada pela ferramenta utilizada, e não pela realidade.
Continua…
Quem quiser ajudar com a tradução, layout e publicação do livro, entre em contato comigo pessoalmente ou pelo e-mail magisterludi2016@yandex.ru
A propósito, também iniciamos a tradução de mais um livro incrível — )
Estamos especialmente à procura de pessoas que ajudem a traduzir . (traduzimos 10 minutos, os primeiros 20 já foram feitos)
Conteúdo do livro e capítulos traduzidos
- Introdução à Arte de Fazer Ciência e Engenharia: Aprendendo a Aprender (28 de março de 1995)
- «Fundamentos da Revolução Digital (Discreta)» (30 de março de 1995)
- «História dos Computadores — Hardware» (31 de março de 1995)
- «História dos Computadores — Software» (4 de abril de 1995)
- «História dos Computadores — Aplicações» (6 de abril de 1995)
- «Inteligência Artificial — Parte I» (7 de abril de 1995)
- «Inteligência Artificial — Parte II» (11 de abril de 1995)
- «Inteligência Artificial III» (13 de abril de 1995)
- «Espaço n-dimensional» (14 de abril de 1995)
- «Teoria da Codificação — A Representação da Informação, Parte I» (18 de abril de 1995)
- «Teoria da Codificação — A Representação da Informação, Parte II» (20 de abril de 1995)
- «Códigos de Correção de Erros» (21 de abril de 1995)
- «Teoria da Informação» (25 de abril de 1995)
- «Filtros Digitais, Parte I» (27 de abril de 1995)
- «Filtros Digitais, Parte II» (28 de abril de 1995)
- «Filtros Digitais, Parte III» (2 de maio de 1995)
- «Filtros Digitais, Parte IV» (4 de maio de 1995)
- «Simulação, Parte I» (5 de maio de 1995)
- «Simulação, Parte II» (9 de maio de 1995)
- «Simulação, Parte III» (11 de maio de 1995)
- «Fibra Óptica» (12 de maio de 1995)
- «Instrução Assistida por Computador» (16 de maio de 1995)
- «Matemática» (18 de maio de 1995)
- «Mecânica Quântica» (19 de maio de 1995)
- «Criatividade» (23 de maio de 1995). Tradução:
- «Especialistas» (25 de maio de 1995)
- «Dados Não Confiáveis» (26 de maio de 1995)
- «Engenharia de Sistemas» (30 de maio de 1995)
- «Você Recebe o Que Mede» (1 de junho de 1995)
- (2 de junho de 1995) traduzimos em pedaços de 10 minutos
- Hamming, «Você e Sua Pesquisa» (6 de junho de 1995).
Quem quiser ajudar com a tradução, layout e publicação do livro, entre em contato comigo pessoalmente ou pelo e-mail magisterludi2016@yandex.ru
Fonte: habr.com
