

Atualmente, o serviço "Bitrix24" não possui centenas de gigabits de tráfego, nem um enorme parque de servidores (embora haja, é claro, uma quantidade considerável). Mas para muitos clientes, ele é uma ferramenta essencial para o trabalho na empresa, sendo um verdadeiro aplicativo crítico para os negócios. Portanto, falhar — de jeito nenhum. E se a falha realmente ocorrer, mas o serviço "ressuscitar" tão rapidamente que ninguém perceba? E como é possível implementar o failover sem perder a qualidade do serviço e o número de clientes? Alexander Demidov, diretor da área de serviços em nuvem do "Bitrix24", nos contou sobre como a sistema de reserva evoluiu ao longo de 7 anos de existência do produto.
"Lançamos o 'Bitrix24' na forma de SaaS há 7 anos. A principal dificuldade, provavelmente, estava no seguinte: antes do lançamento público como SaaS, este produto existia apenas na forma de solução de caixa. Os clientes o compravam de nós, instalavam em seus próprios servidores, criavam o portal corporativo — uma solução geral para a comunicação dos funcionários, armazenamento de arquivos, gerenciamento de tarefas, CRM, tudo isso. E até 2012, decidimos que queríamos lançá-lo como SaaS, administrando de forma autônoma, garantindo a continuidade e confiabilidade. Acumulamos experiência ao longo do processo, pois até aquele momento não a tínhamos — éramos apenas produtores de software, não provedores de serviços.
Ao lançar o serviço, entendíamos que o mais importante era garantir a confiabilidade, continuidade e disponibilidade constante do serviço, porque se você tiver um site comum, uma loja, por exemplo, e ela cair por uma hora — você só sofre por isso, perde pedidos, perde clientes, mas para o seu cliente — isso não é tão crítico. Ele fica triste, claro, mas vai e compra em outro site. Mas se for um aplicativo que é vital para o funcionamento da empresa, comunicação e decisões, o mais importante é conquistar a confiança dos usuários, ou seja, não deixá-los na mão e não falhar. Porque todo o trabalho pode parar se algo interno não funcionar.
Bitrix24 como SaaS
O primeiro protótipo foi montado um ano antes do lançamento público, em 2011. Levou cerca de uma semana, testamos e rodamos — ele funcionava. Ou seja, era possível entrar no formulário, inserir o nome do portal e um novo portal era criado, com uma base de usuários estabelecida. Analisamos o produto em si, avaliamos e, em seguida, passamos um ano aprimorando. Porque tínhamos uma grande tarefa: não queríamos criar duas bases de código diferentes, não queríamos manter um produto de caixa separado de soluções em nuvem — queríamos fazer tudo isso dentro de um único código.
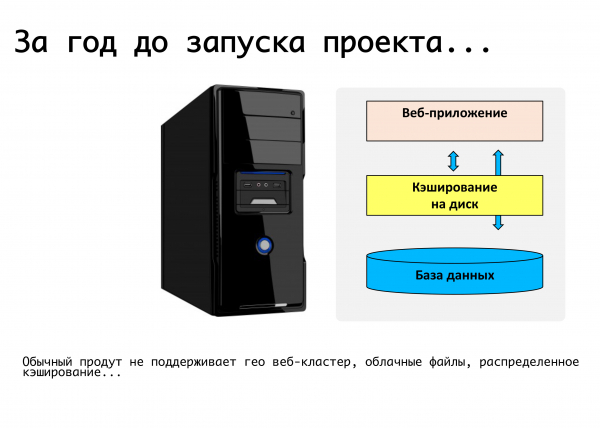
Um aplicativo web típico na época consistia em um único servidor, onde rodava algum código PHP, uma base MySQL, arquivos eram carregados, documentos e imagens eram colocados na pasta upload — e era isso. Infelizmente, não é possível lançar um serviço web criticamente resiliente assim. O cache distribuído não é suportado, a replicação de bases de dados não é suportada.
Formulamos os requisitos: a capacidade de se posicionar em diferentes locais, suportar replicação, idealmente ser distribuído em diferentes data centers geograficamente. Separar a lógica do produto do armazenamento de dados. Ser capaz de escalar dinamicamente, levando em conta a carga, e retirar a parte estática completamente. Com base nesses princípios, foram elaborados os requisitos para o produto, que aprimoramos durante um ano. Nesse tempo, na plataforma que resultou única — para soluções de caixa e para nosso próprio serviço — implementamos o suporte para as ferramentas necessárias. O suporte à replicação MySQL foi integrado ao nível do próprio produto: ou seja, o desenvolvedor, ao escrever o código, não precisa se preocupar em como suas solicitações serão distribuídas, ele usa nossa API, e nós sabemos como distribuir corretamente as solicitações de gravação e leitura entre mestres e escravos.
Implementamos o suporte para diferentes armazenamento de objetos em nuvem no nível do produto: Google Storage, Amazon S3 — além disso, suporte ao OpenStack Swift. Portanto, isso foi conveniente tanto para nós como serviço, quanto para os desenvolvedores que trabalham com a solução de caixa: se eles simplesmente utilizam nossa API, não precisam se preocupar com onde o arquivo será salvo, se localmente no sistema de arquivos ou se irá para um armazenamento de objetos.
Decidimos imediatamente que faríamos reservas a nível de um data center inteiro. Em 2012, começamos totalmente na Amazon AWS, pois já tínhamos experiência com essa plataforma — nosso próprio site estava hospedado lá. O que nos atraía era que em cada região da Amazon existem várias zonas de disponibilidade — essencialmente, (na terminologia deles) vários data centers que são mais ou menos independentes entre si e nos permitem fazer reservas a nível de um data center inteiro: se um deles falhar, os bancos de dados se replicam master-master, os servidores de aplicações web são reservados, e a estática é movida para o armazenamento de objetos S3. A carga é balanceada — naquele momento pelo ELB da Amazon, mas logo depois chegamos a nossos próprios balanceadores, pois precisávamos de uma lógica mais complexa.
O que queríamos, conseguimos…
Todas as coisas básicas que queríamos garantir — a resiliência dos próprios servidores, aplicações web, bancos de dados — tudo funcionava bem. O cenário mais simples: se uma das aplicações web falhasse, era bem simples — elas eram desligadas do balanceamento.
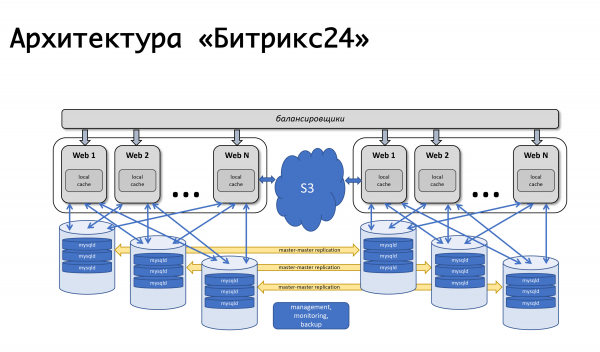
As máquinas que falhavam eram marcadas como unhealthy pelo balanceador (naquele momento era o ELB da Amazon), que desligava a distribuição da carga para elas. O autoescalonamento da Amazon funcionava: quando a carga aumentava, novas máquinas eram adicionadas ao grupo de autoescalonamento, e a carga era distribuída entre as novas máquinas — tudo estava bem. Com nossos balanceadores, a lógica é mais ou menos a mesma: se algo acontecer com o servidor de aplicações, retiramos as solicitações dele, descartamos essas máquinas, iniciamos novas e continuamos a trabalhar. O esquema mudou um pouco ao longo dos anos, mas continua funcionando: é simples, claro, e não há dificuldades com isso.
Nós operamos em todo o mundo, com picos de carga muito diferentes entre os clientes, e, idealmente, devemos ter a capacidade de realizar qualquer tipo de manutenção em qualquer componente de nosso sistema a qualquer momento — sem que os clientes percebam. Portanto, temos a possibilidade de desligar o banco de dados, redistribuindo a carga para o segundo data center.
Como tudo isso funciona? — Nós redirecionamos o tráfego para um data center em funcionamento — se houver uma falha no data center, redirecionamos completamente; se forem nossas manutenções programadas em uma base específica, redirecionamos parte do tráfego dos clientes desse data center para o segundo, suspendendo a replicação. Se forem necessárias novas máquinas para aplicativos da web, devido ao aumento da carga no segundo data center, elas são iniciadas automaticamente. Concluímos as operações, a replicação é restaurada e retornamos toda a carga. Se precisarmos realizar operações sincronizadas no segundo data center, como instalar atualizações do sistema ou alterar configurações na segunda base de dados, repetimos todo o processo, apenas na direção oposta. Em caso de falha, fazemos tudo de maneira simples: usamos mecanismos de event-handlers no sistema de monitoramento. Se várias verificações falharem e o status mudar para crítico, esse handler é acionado, executando a lógica apropriada. Para cada base, definimos qual servidor é o failover e para onde devemos redirecionar o tráfego em caso de não disponibilidade. Historicamente, usamos de alguma forma o Nagios ou seus forks. Basicamente, mecanismos semelhantes estão disponíveis em quase todos os sistemas de monitoramento; ainda não utilizamos algo mais complexo, mas é possível que o façamos no futuro. Atualmente, o monitoramento é acionado pela indisponibilidade e tem a capacidade de redirecionar algo.
Reservamos tudo?
Temos muitos clientes dos EUA, muitos clientes da Europa, muitos clientes mais próximos do Oriente — Japão, Singapura e assim por diante. Naturalmente, uma grande parte dos clientes está na Rússia. Ou seja, o trabalho não se limita a uma única região. Os usuários desejam uma resposta rápida, há requisitos para atender a diferentes leis locais, e dentro de cada região reservamos dois data centers, além de haver alguns serviços adicionais que, novamente, são convenientes de localizar em uma única região — para os clientes que operam nessa região. Processadores REST, servidores de autorização, são menos críticos para a operação do cliente como um todo, e é possível alternar entre eles com um pequeno atraso aceitável, mas não queremos reinventar a roda em termos de como monitorá-los e o que fazer com eles. Portanto, sempre que possível, tentamos usar soluções já existentes, e não desenvolver uma competência para produtos adicionais. Em alguns casos, usamos simplesmente a alternância a nível de DNS, e a vitalidade do serviço é definida pelo mesmo DNS. No Amazon, existe o serviço Route 53, mas não é apenas um DNS onde você pode adicionar registros e pronto — ele é muito mais flexível e conveniente. Através dele, é possível construir serviços geograficamente distribuídos com geolocalizações, onde você, com a sua ajuda, determina de onde veio o cliente e fornece os registros adequados — é possível construir arquiteturas de failover com ele. Os mesmo health-checks são configurados diretamente no Route 53, onde você define o endpoint que será monitorado, define as métricas, define quais protocolos usar para determinar a 'vitalidade' do serviço — tcp, http, https; define a periodicidade das verificações que determinam se o serviço está ativo ou não. E no próprio DNS, você especifica qual será o primário, qual será o secundário, para onde alternar caso um health-check seja acionado dentro do Route 53. Tudo isso pode ser feito com outras ferramentas, mas a vantagem é que você configura uma vez e depois não pensa mais em como estão as verificações, como se dá a alternância: tudo funciona automaticamente.
A primeira 'mas': e como e com o que reservar o próprio Route 53? Afinal, nunca se sabe quando algo pode acontecer com ele. Felizmente, nunca tivemos esse problema, mas novamente, eu terei uma história sobre por que pensamos que é necessário fazer reservas. Aqui, estamos nos precavendo. Várias vezes ao dia, fazemos um backup completo de todas as zonas que temos no Route 53. A API da Amazon permite exportá-las em JSON, e temos vários servidores de backup onde convertemos isso, exportamos como configurações e, grosso modo, temos uma configuração de backup. Se necessário, podemos rapidamente restaurá-la manualmente, sem perder os dados das configurações DNS.
O segundo "mas": o que ainda não está reservado nessa situação? O próprio balanceador de carga! A distribuição de clientes por regiões foi feita de maneira bastante simples. Temos os domínios bitrix24.ru, bitrix24.com, .de — atualmente são cerca de 13 diferentes, operando em várias zonas. Chegamos à seguinte solução: em cada região, temos seus próprios balanceadores. É mais conveniente distribuir por regiões, dependendo da carga máxima de rede em cada uma. Se houver uma falha em um único balanceador, ele simplesmente é retirado de operação e removido do DNS. Se ocorrer um problema com um grupo de balanceadores, eles são reservados em outras localidades, e a troca entre eles é feita utilizando o próprio Route 53, pois devido ao TTL curto, a troca acontece no máximo em 2, 3 ou 5 minutos.
O terceiro "mas": o que mais não está reservado? S3, certo. Ao armazenarmos arquivos que temos de usuários no S3, acreditávamos sinceramente que ele era à prova de balas e que não precisava de reservas. Mas a história mostra que as coisas costumam ser diferentes. De fato, a Amazon descreve o S3 como um serviço fundamental, porque a própria Amazon utiliza o S3 para armazenar imagens de máquinas, configurações, imagens AMI, snapshots… E se o S3 falha, como aconteceu uma vez nos últimos 7 anos em que utilizamos o Bitrix24, ele acaba arrastando uma série de problemas — indisponibilidade de inicialização de VMs, falhas no funcionamento da API, e assim por diante.
E a S3 pode falhar — isso já aconteceu uma vez. Portanto, chegamos à seguinte abordagem: há alguns anos, não havia repositórios públicos de objetos sérios na Rússia, e consideramos a opção de criar algo próprio... Felizmente, não começamos a fazê-lo, pois nos teríamos enredado em uma especialização da qual não dispunhamos e, com certeza, teríamos cometido erros. Agora, há repositórios compatíveis com S3 na Mail.ru, na Yandex e em vários outros provedores. No final, chegamos à conclusão de que queríamos ter, em primeiro lugar, redundância, e em segundo lugar, a possibilidade de trabalhar com cópias locais. Para a região específica da Rússia, usamos o serviço Mail.ru Hotbox, que é compatível com S3 via API. Não precisávamos de grandes ajustes no código dentro do aplicativo, e implementamos o seguinte mecanismo: no S3, existem gatilhos que são ativados na criação/removal de objetos; a Amazon tem um serviço chamado Lambda — é uma execução de código serverless, que será realizada exatamente quando certos gatilhos forem acionados.
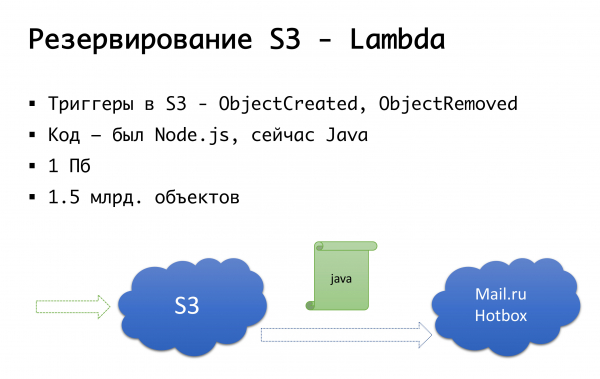
Fizemos de forma bem simples: se um gatilho é acionado, executamos um código que copia o objeto para o repositório Mail.ru. Para iniciar plenamente o trabalho com cópias locais de dados, precisamos também de sincronização reversa, para que os clientes situados no segmento russo possam trabalhar com um repositório que esteja mais próximo deles. A Mail está prestes a concluir os gatilhos em seu repositório — será possível realizar a sincronização reversa no nível da infraestrutura; por enquanto, estamos fazendo isso em nível de nosso próprio código. Se vemos que um cliente carregou um arquivo, adicionamos um evento em uma fila a nível de código, processamos isso e realizamos a replicação inversa. O problema é que, se ocorrer alguma manipulação com nossos objetos fora do nosso produto, usando algum meio externo, isso não será contabilizado. Portanto, estamos aguardando até o final, quando os gatilhos no nível do repositório estiverem disponíveis, para que, independentemente de onde executamos o código, o objeto que chega a nós seja copiado na outra direção.
No nível do código, temos os dois armazéns configurados para cada cliente: um considerado principal e o outro de backup. Se tudo vai bem, trabalhamos com o armazém que está mais próximo de nós: ou seja, nossos clientes que estão na Amazon trabalham com S3, enquanto aqueles que operam na Rússia utilizam Hotbox. Se um sinalizador é acionado, devemos ativar o failover, e mudamos os clientes para outro armazém. Podemos ativar esse sinalizador independentemente por regiões e podemos alterná-los. Na prática, ainda não usamos isso, mas o mecanismo foi previsto e acreditamos que um dia precisaremos dessa troca. Isso já aconteceu uma vez.
Oh, parece que sua Amazon fugiu...
Neste abril, comemoramos o aniversário do início das limitações do Telegram na Rússia. O provedor mais afetado por isso foi a Amazon. E, infelizmente, as empresas russas que operavam globalmente sofreram mais.
Se a empresa é global e a Rússia representa apenas uma fração pequena, de 3 a 5%, de qualquer forma, elas podem ser sacrificadas.
Se for uma empresa completamente russa — estou certo de que é necessário operar localmente — simplesmente será mais conveniente e confortável para os usuários, e haverá menos riscos.
E se essa empresa operar globalmente e tiver aproximadamente um número equilibrado de clientes na Rússia e em outras partes do mundo? A conectividade entre os segmentos é importante, e eles precisam trabalhar juntos de alguma forma.
No final de março de 2018, a Roskomnadzor enviou uma carta para os maiores provedores, informando que planejavam bloquear milhões de IPs da Amazon para bloquear... o mensageiro Zello. Agradecemos a esses próprios provedores — eles vazaram a carta, e surgiu a compreensão de que a conectividade com a Amazon poderia ruir. Era uma sexta-feira, e nós, em pânico, fomos até os colegas da servers.ru, dizendo: 'Amigos, precisamos de alguns servidores que não fiquem na Rússia, não na Amazon, mas, por exemplo, em algum lugar em Amsterdam', para que possamos, de alguma maneira, ter nossos próprios serviços lá. vpn E proxy para alguns endpoints, sobre os quais não podemos influenciar de forma alguma, como os endpoints do S3 — não podemos tentar levantar um novo serviço e obter um outro IP, ainda assim precisamos acessá-los. Em poucos dias, configuramos e levantamos esses servidores, e, no geral, quando as restrições começaram, já estávamos prontos. Curiosamente, o RKN, ao notar a agitação e a histeria geradas, disse: 'Não, agora não vamos bloquear nada.' (Mas isso durou até o momento em que começaram a bloquear o Telegram.) Depois de configurar as possibilidades de contorno e entender que a restrição não foi imposta, não começamos a desmontar tudo. Assim, por via das dúvidas.
E aqui estamos em 2019, vivendo sob restrições. Ontem à noite, observei: cerca de um milhão de IPs continuam sendo bloqueados. Na verdade, a Amazon foi quase totalmente desbloqueada, no pico chegamos a 20 milhões de endereços... Em suma, a realidade é que a conectividade, uma boa conectividade — pode não existir. De repente. Pode não existir por razões técnicas — incêndios, escavadeiras, tudo isso. Ou, como vimos, por razões que não são exatamente técnicas. Portanto, alguém grande e poderoso, com seus próprios AS, pode conseguir administrar isso de outras maneiras — direct connect e outras coisas já a nível L2. Mas na versão simples, como nós ou outras empresas menores, é bom ter uma redundância ao nível dos servidores, levantados em outros lugares, configurados previamente com VPNs, proxies, com a possibilidade de trocar rapidamente a configuração nas partes críticas que você tem em termos de conectividade. Isso nos foi útil várias vezes, especialmente quando começaram os bloqueios da Amazon, passando por eles, no pior dos casos, o tráfego do S3, mas tudo isso foi se resolvendo gradualmente.
E como fazer a redundância... de um provedor inteiro?
Atualmente, não temos um cenário para a falha total da Amazon. Temos um cenário semelhante para a Rússia. Na Rússia, estávamos alocados em um provedor que escolhemos para ter várias localizações. E há um ano, enfrentamos um problema: mesmo que fossem dois data centers, já no nível de configuração da rede do provedor, podem haver problemas que afetariam ambos os data centers. E podemos acabar enfrentando indisponibilidade em ambas as localizações. Claro, isso aconteceu. No final, reconsideramos a arquitetura interna. Ela não mudou muito, mas para a Rússia agora temos duas localizações que não estão sob um único provedor, mas sim em dois diferentes. Se um deles falhar, podemos mudar para o outro.
Hipoteticamente, para a Amazon, estamos considerando a possibilidade de fazer reservas em nível de outro provedor; talvez o Google, talvez algum outro... Mas até agora, observamos na prática que se ocorrerem falhas na Amazon em uma zona de disponibilidade, falhas em nível regional são fenômenos bastante raros. Portanto, temos uma ideia teórica de que talvez possamos fazer uma reserva 'Amazon - não Amazon', mas na prática isso ainda não existe.
Algumas palavras sobre automação
A automação é sempre necessária? Aqui é pertinente lembrar o efeito Dunning-Kruger. No eixo 'x', temos nosso conhecimento e experiência, que adquirimos, e no eixo 'y' — a confiança em nossas ações. No início, não sabemos nada e não temos confiança alguma. Depois, sabemos um pouco e nos tornamos mega-confiantes — isso é o que chamamos de 'pico da ignorância', bem ilustrado pela imagem 'imbecilidade e bravura'. Em seguida, aprendemos um pouco e estamos prontos para entrar em ação. Então, cometemos alguns erros sérios, caímos no vale da desesperança, onde parece que sabemos algo, mas na verdade sabemos muito pouco. Depois, à medida que adquirimos experiência, nos tornamos mais confiantes.
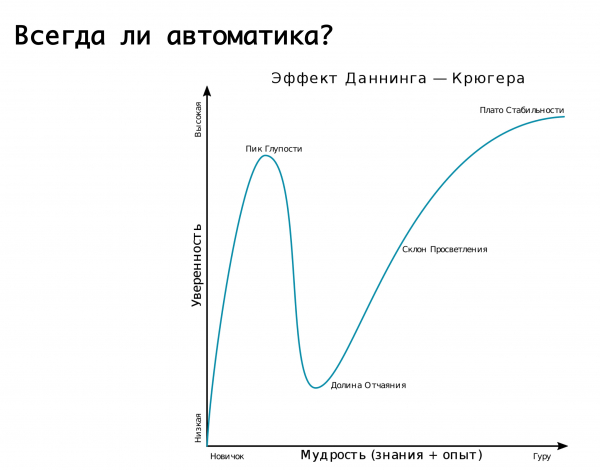
Nossa lógica sobre as diferentes alternâncias automaticamente em caso de falhas — é muito bem descrita por este gráfico. Começamos — não sabíamos nada, praticamente todo o trabalho era feito manualmente. Depois entendemos que era possível automatizar tudo e, assim, dormir tranquilos. E de repente encontramos um grande problema: temos um falso positivo e alternamos o tráfego de um lado para o outro, quando, na verdade, não tínhamos que fazer isso. Consequentemente, a replicação quebra ou outra coisa qualquer — essa é a verdadeira depressão. E, então, chegamos à compreensão de que devemos lidar com tudo com sabedoria. Ou seja, faz sentido confiar na automação, prevendo a possibilidade de um falso acionamento. Mas! Se as consequências podem ser devastadoras, é melhor deixar isso a cargo da equipe de plantão, dos engenheiros de plantão, que vão verificar, confirmar que realmente é uma falha e executar as ações necessárias manualmente...
Conclusão
Em 7 anos, passamos de momentos de pânico quando algo falhava, para uma compreensão de que não existem problemas, apenas tarefas que precisam — e podem — ser resolvidas. Quando você cria um serviço, olhe para ele de uma perspectiva elevada, avalie todos os riscos que podem surgir. Se você os vê de imediato — então, preveja a redundância e a possibilidade de construir uma infraestrutura tolerante a falhas, porque qualquer ponto que possa falhar e levar à inoperabilidade do serviço — definitivamente irá falhar. E mesmo que você ache que alguns elementos da infraestrutura, como o próprio S3, não vão falhar, tenha em mente que eles podem falhar. E, pelo menos em teoria, tenha uma ideia do que fará com eles se algo realmente acontecer. Tenha um plano para lidar com os riscos. Ao considerar se deve fazer tudo automaticamente ou manualmente, avalie os riscos: o que acontecerá se a automação começar a fazer todas as alternâncias — isso não levará a uma situação pior do que a falha original? Pode ser que, em alguns casos, seja necessário um compromisso razoável entre o uso da automação e a reação do engenheiro de plantão, que avaliará a situação real e entenderá se algo deve ser alternado imediatamente ou ‘sim, mas não agora’.
Um compromisso sensato entre o perfeccionismo e os recursos reais, o tempo e o dinheiro que você pode gastar na solução que você, no final, terá.
Este texto é uma versão aumentada e expandida da apresentação de Alexander Demidov na conferência. .
Fonte: habr.com
