

Neste artigo, vou explicar como abordamos a questão da disponibilidade do PostgreSQL, por que isso se tornou importante para nós e o que conseguimos no final.
Temos um serviço de alta demanda: 2,5 milhões de usuários em todo o mundo, mais de 50 mil usuários ativos todos os dias. Os servidores estão na Amazon em uma única região da Irlanda: operamos continuamente mais de 100 servidores diferentes, dos quais quase 50 têm bancos de dados.
Todo o backend é um grande aplicativo monolítico stateful em Java, que mantém uma conexão websocket permanente com o cliente. Com vários usuários trabalhando simultaneamente em um quadro, todos veem as alterações em tempo real, pois registramos cada mudança em nosso banco de dados. Temos aproximadamente 10 mil requisições por segundo em nossos bancos. Em picos de carga, escrevemos de 80 a 100 mil requisições por segundo no Redis.
Por que mudamos do Redis para o PostgreSQL
Inicialmente, nosso serviço operava com o Redis, um armazenamento chave-valor que mantém todos os dados na memória. servidor.
Vantagens do Redis:
- Alta velocidade de resposta, já que tudo está armazenado na memória;
- Facilidade de backup e replicação.
Desvantagens do Redis para nós:
- Não há transações reais. Tentamos simular isso no nível de nosso aplicativo. Infelizmente, isso nem sempre funcionou bem e exigia a escrita de um código muito complicado.
- O volume de dados é limitado pela quantidade de memória. Com o aumento da quantidade de dados, a memória cresce e, eventualmente, nos deparamos com as características da instância escolhida, o que na AWS requer a parada de nosso serviço para alterar o tipo de instância.
- É necessário manter constantemente um nível baixo de latência, já que temos um número muito alto de requisições. O nível de latência ideal para nós é de 17 a 20 ms. Com latências de 30 a 40 ms, recebemos respostas longas às requisições de nosso aplicativo e degradação do serviço. Infelizmente, isso ocorreu em setembro de 2018, quando uma das instâncias com Redis inexplicavelmente apresentou latência duas vezes maior que o normal. Para resolver o problema, paramos o serviço no meio do dia para manutenção não planejada e substituímos a instância problemática do Redis.
- É fácil obter inconsistências nos dados mesmo com erros mínimos no código e depois gastar muito tempo escrevendo código para corrigir esses dados.
Consideramos as desvantagens e entendemos que precisávamos migrar para algo mais conveniente, com transações normais e menor dependência de latência. Realizamos uma pesquisa, analisamos várias opções e escolhemos o PostgreSQL.
Estamos migrando para o novo banco de dados há 1,5 ano e apenas transportamos uma pequena parte dos dados, portanto, atualmente trabalhamos simultaneamente com Redis e PostgreSQL. Mais detalhes sobre as etapas da migração e a troca de dados entre os bancos de dados estão descritos na artigo do meu colega.
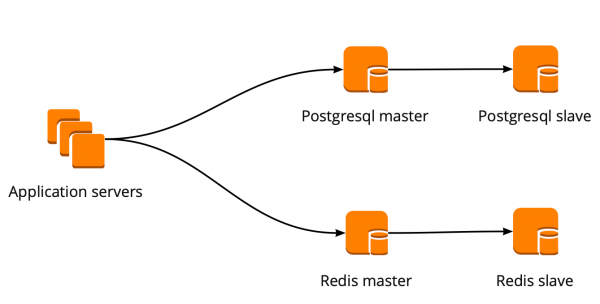
Quando começamos a migração, nosso aplicativo se conectava diretamente ao banco de dados, acessando o mestre do Redis e do PostgreSQL. O cluster PostgreSQL consistia em um mestre e uma réplica com replicação assíncrona. Assim era o esquema de trabalho com os bancos:
Implementação do PgBouncer
Enquanto migrávamos, o produto também estava se desenvolvendo: o número de usuários e a quantidade de servidores trabalhando com PostgreSQL aumentavam, e começamos a ficar sem conexões. O PostgreSQL cria um processo separado para cada conexão e consome recursos. O aumento do número de conexões pode ser feito até certo ponto; caso contrário, há risco de se obter um desempenho subótimo do banco de dados. A solução ideal nessa situação seria escolher um gerenciador de conexões que atuasse na frente do banco de dados.
Tínhamos duas opções para o gerenciador de conexões: Pgpool e PgBouncer. Mas o primeiro não suporta o modo de transações com o banco, então optamos pelo PgBouncer.
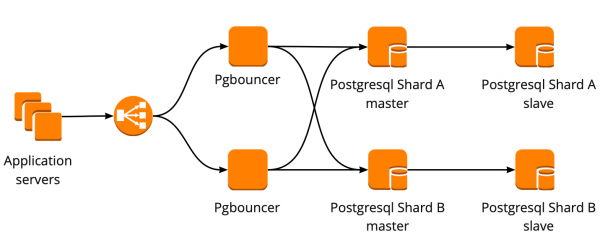
Configuramos o seguinte esquema de trabalho: nosso aplicativo se conecta a um PgBouncer, atrás do qual estão os mestres do PostgreSQL, e atrás de cada mestre há uma réplica com replicação assíncrona.
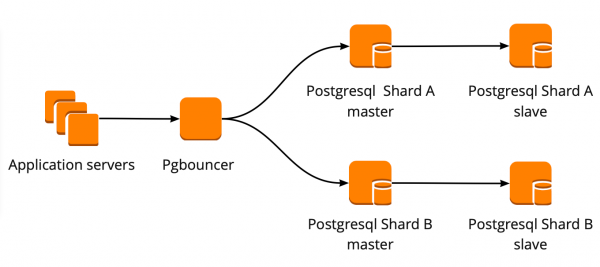
No entanto, não podíamos armazenar todo o volume de dados no PostgreSQL e a velocidade de acesso ao banco era importante para nós, então começamos a fragmentar o PostgreSQL no nível da aplicação. O esquema descrito acima é relativamente conveniente para isso: ao adicionar uma nova fragmentação, é suficiente atualizar a configuração do PgBouncer e o aplicativo pode começar a trabalhar imediatamente com a nova fragmentação.
Alta disponibilidade do PgBouncer
Este esquema funcionou até o momento em que a única instância do PgBouncer falhou. Estamos na AWS, onde todas as instâncias são executadas em hardware que falha periodicamente. Nesses casos, a instância simplesmente é movida para um novo hardware e volta a operar. O mesmo aconteceu com o PgBouncer, no entanto, ele se tornou inacessível. O resultado dessa falha foi a indisponibilidade do nosso serviço por 25 minutos. A AWS recomenda o uso de redundância do lado do usuário para essas situações, o que não tínhamos implementado até aquele momento.
Depois disso, começamos a considerar seriamente a resiliência do PgBouncer e dos clusters PostgreSQL, pois tal situação poderia se repetir com qualquer instância em nossa conta da AWS.
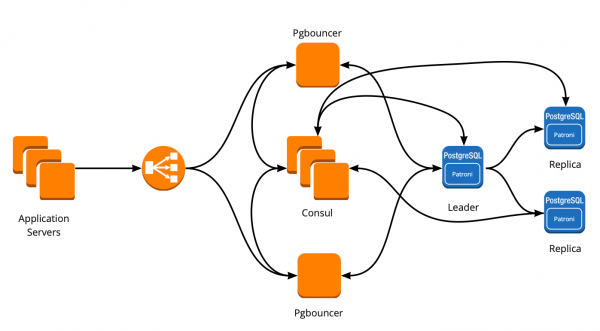
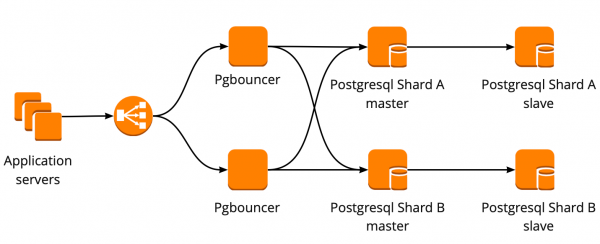
Construímos a arquitetura de resiliência do PgBouncer da seguinte maneira: todos os servidores de aplicação se conectam ao Network Load Balancer, que tem dois PgBouncer atrás dele. Cada PgBouncer monitora os mesmos master PostgreSQL de cada shard. Caso a situação de falha da instância da AWS se repita, todo o tráfego é redirecionado através de outro PgBouncer. A resiliência do Network Load Balancer é garantida pela AWS.
Esse esquema permite a adição sem problemas de novos servidores PgBouncer.
Criação de um cluster PostgreSQL resiliente
Ao resolver essa tarefa, consideramos diferentes opções: failover personalizado, repmgr, AWS RDS, Patroni.
Scripts personalizados
Podem monitorar a operação do master e, em caso de falha, promover a réplica a master e atualizar a configuração do PgBouncer.
Os pontos positivos dessa abordagem estão na máxima simplicidade, já que você mesmo escreve os scripts e entende exatamente como eles funcionam.
Pontos negativos:
- O master pode não ter falhado, ao invés disso, uma falha de rede pode ter ocorrido. O failover, sem saber disso, promoverá a réplica a master, enquanto o antigo master continuará funcionando. Como resultado, teremos dois servidores atuando como master e não saberemos em qual deles estão os dados mais recentes. Essa situação é chamada de split-brain;
- Ficamos sem réplica. Em nossa configuração, há um master e uma réplica, e após a troca, a réplica é promovida a master e não temos mais réplicas, então é necessário adicionar uma nova réplica manualmente;
- É necessário monitoramento adicional da operação do failover, e temos 12 shards PostgreSQL, o que significa que devemos monitorar 12 clusters. Ao aumentar o número de shards, não devemos esquecer de atualizar o failover.
Um failover personalizado parece muito complicado e exige suporte não trivial. Com um cluster PostgreSQL, esta será a opção mais simples, mas não escalável, portanto, não é adequada para nós.
Repmgr
Gerenciador de Replicação para clusters PostgreSQL, que pode gerenciar o funcionamento do cluster PostgreSQL. Porém, não possui failover automático 'pronto para uso', portanto, será necessário escrever uma 'camada' personalizada em cima da solução existente. Isso pode resultar em algo até mais complicado do que scripts personalizados, por isso nem sequer tentamos o Repmgr.
AWS RDS
Suporta tudo o que precisamos, realiza backups e oferece suporte a pool de conexões. Possui troca automática: quando o mestre falha, a réplica se torna o novo mestre, e a AWS altera o registro DNS para o novo mestre, enquanto as réplicas podem estar em diferentes AZs.
Entre os pontos negativos, está a falta de configurações detalhadas. Um exemplo de configurações detalhadas: nos nossos instâncias, há restrições para conexões tcp, o que, infelizmente, não pode ser feito no RDS:
net.ipv4.tcp_keepalive_time=10
net.ipv4.tcp_keepalive_intvl=1
net.ipv4.tcp_keepalive_probes=5
net.ipv4.tcp_retries2=3
Além disso, o preço do AWS RDS é quase o dobro do preço normal da instância, que foi a principal razão para desistirmos dessa solução.
Patroni
Este é um template em python para gerenciar PostgreSQL com boa documentação, failover automático e código fonte no github.
Vantagens do Patroni:
- Cada parâmetro de configuração é detalhado, e é fácil entender como funciona;
- O failover automático funciona pronto para uso;
- Escrito em python, e como nós mesmos escrevemos muito em python, será mais fácil lidarmos com problemas e até mesmo ajudar no desenvolvimento do projeto;
- Gerencia completamente o PostgreSQL, permitindo a alteração de configurações em todos os nós do cluster de uma vez, e se a nova configuração exigir a reinicialização do cluster, isso também pode ser feito com o Patroni.
Pontos negativos:
- A documentação não deixa claro como trabalhar corretamente com o PgBouncer. Embora isso seja difícil de chamar de desvantagem, já que a tarefa do Patroni é gerenciar o PostgreSQL, e como as conexões serão direcionadas ao Patroni é um problema nosso;
- Existem poucos exemplos de implementação do Patroni em grandes volumes, mas muitos exemplos de implantação desde o início.
Como resultado, escolhemos o Patroni para criar um cluster com alta disponibilidade.
O processo de implementação do Patroni
Antes do Patroni, tínhamos 12 shards do PostgreSQL na configuração de um mestre e uma réplica com replicação assíncrona. Os servidores de aplicação se conectavam aos bancos de dados através de um Network Load Balancer, que tinha dois instâncias com PgBouncer, seguidos por todos os servidores PostgreSQL.
Para implementar o Patroni, precisávamos escolher um armazenamento de configuração distribuído para o cluster. O Patroni funciona com sistemas de armazenamento de configurações distribuídas, como etcd, Zookeeper e Consul. Temos um cluster Consul completo em produção, que opera em conjunto com o Vault e não o utilizamos de outra forma. É uma ótima oportunidade para começar a utilizar o Consul para seu propósito planejado.
Como o Patroni funciona com o Consul
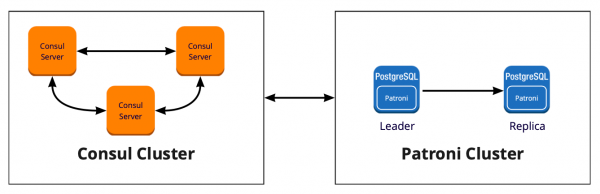
Temos um cluster Consul que consiste em três nós e um cluster Patroni, que é composto por um líder e uma réplica (no Patroni, o mestre é chamado de líder do cluster, e os escravos são as réplicas). Cada instância do cluster Patroni envia constantemente informações sobre o estado do cluster para o Consul. Portanto, é sempre possível consultar a configuração atual do cluster Patroni no Consul e quem é o líder no momento.
Para conectar o Patroni ao Consul, é suficiente consultar a documentação oficial, onde está escrito que precisamos fornecer um host no formato http ou https, dependendo de como estamos trabalhando com o Consul, e o esquema de conexão, opcionalmente:
host: o host:porta para o endpoint do Consul, no formato: http(s)://host:porta
scheme: (opcional) http ou https, padrão é http
Parece simples, mas aqui começam as armadilhas. Estamos trabalhando com o Consul através de uma conexão segura via https, e nossa configuração de conexão ficará assim:
consul:
  host: https://server.production.consul:8080
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Mas assim não funciona. Ao iniciar, o Patroni não consegue se conectar ao Consul, porque está tentando usar http.
Resolver o problema foi possível graças ao código-fonte do Patroni. Felizmente, ele é escrito em Python. Descobriu-se que o parâmetro host não é analisado, e o protocolo deve ser especificado no esquema. Veja como fica o bloco de configuração funcional para operar com o Consul em nosso caso:
consul:
  host: server.production.consul:8080
  scheme: https
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Consul-template
Assim, escolhemos o armazenamento para a configuração. Agora precisamos entender como o PgBouncer alternará sua configuração ao mudar o líder no cluster Patroni. Não há resposta para essa questão na documentação, já que não descreve a operação com o PgBouncer.
Na busca por uma solução, encontramos um artigo (não me lembro o nome, infelizmente), onde era mencionado que o Consul-template ajudou muito na integração entre PgBouncer e Patroni. Isso nos motivou a investigar o funcionamento do Consul-template.
Descobrimos que o Consul-template monitora continuamente a configuração do cluster PostgreSQL no Consul. Quando o líder muda, ele atualiza a configuração do PgBouncer e envia o comando para recarregá-la.
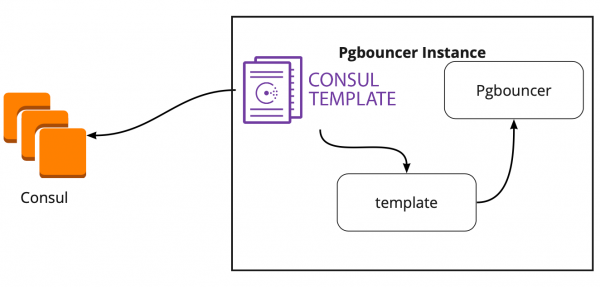
Uma grande vantagem do template é que ele é armazenado como código, portanto, ao adicionar um novo shard, basta fazer um novo commit e atualizar o template automaticamente, mantendo o princípio de Infrastructure as Code.
Nova arquitetura com Patroni
Como resultado, obtivemos o seguinte esquema de trabalho:
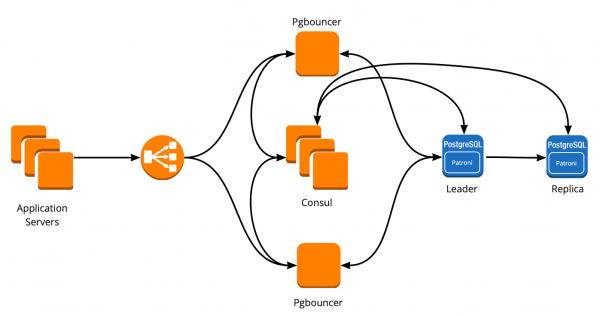
Todos os servidores da aplicação se conectam ao balanceador → atrás dele há duas instâncias do PgBouncer → em cada instância está em execução o Consul-template, que monitora o estado de cada cluster Patroni e verifica a atualidade da configuração do PgBouncer, que redireciona as solicitações para o atual líder de cada cluster.
Teste manual
Antes de implantar em produção, testamos esse esquema em um pequeno ambiente de teste e verificamos o funcionamento da troca automática. Abrimos um quadro, movemos um adesivo e, nesse momento, 'matamos' o líder do cluster. Na AWS, basta desligar a instância através do console.
O adesivo retornou ao seu lugar em 10-20 segundos e depois começou a se mover normalmente novamente. Isso significa que o cluster Patroni funcionou corretamente: trocou de líder, enviou as informações ao Consul, e o Consul-template imediatamente capturou essas informações, substituiu a configuração do PgBouncer e enviou o comando para reload.
Como sobreviver sob alta carga e manter o downtime mínimo?
Tudo está funcionando perfeitamente! Mas surgem novas perguntas: como isso funcionará sob alta carga? Como implantar tudo de forma rápida e segura em produção?
Responder à primeira pergunta é facilitado pelo ambiente de teste, onde realizamos testes de carga. Ele é idêntico à produção em termos de arquitetura e possui dados de teste gerados que são aproximadamente iguais em volume à produção. Decidimos "eliminar" um dos mestres PostgreSQL durante o teste e ver o que acontece. Mas antes disso, é importante verificar a automação, pois neste ambiente temos vários shards PostgreSQL, então teremos uma ótima testagem dos scripts de configuração antes de irem para a produção.
Ambas as tarefas parecem ambiciosas, mas estamos com o PostgreSQL 9.6. Podemos atualizar diretamente para a versão 11.2?
Decidimos fazer isso em duas etapas: primeiro atualizar para a versão 11.2, depois iniciar o Patroni.
Atualização do PostgreSQL
Para uma rápida atualização da versão do PostgreSQL, é necessário usar a opção -k, que cria hard links no disco, sem a necessidade de copiar seus dados. Em bancos de 300-400 GB, a atualização leva 1 segundo.
Temos muitos shards, por isso a atualização precisa ser feita de forma automática. Para isso, escrevemos um playbook do Ansible, que executa todo o processo de atualização para nós:
/usr/lib/postgresql/11/bin/pg_upgrade
<b>--link </b>
--old-datadir='' --new-datadir=''
 --old-bindir=''  --new-bindir=''
 --old-options=' -c config_file='
 --new-options=' -c config_file='
Aqui é importante notar que antes de iniciar a atualização, é necessário rodá-la com o parâmetro --check, para ter certeza de que a atualização é possível. Além disso, nosso script faz a substituição dos configs durante a atualização. O script foi executado em 30 segundos, o que é um ótimo resultado.
Início do Patroni
Para resolver o segundo problema, basta olhar a configuração do Patroni. No repositório oficial há um exemplo de configuração com initdb, que é responsável pela inicialização do novo banco na primeira execução do Patroni. Mas como já temos um banco pronto, apenas removemos essa seção da configuração.
Quando começamos a instalar o Patroni em um cluster PostgreSQL existente e a executá-lo, nos deparamos com um novo problema: ambos os servidores estavam sendo iniciados como líderes. O Patroni não tem conhecimento do estado anterior do cluster e tenta iniciar ambos os servidores como dois clusters separados com o mesmo nome. Para resolver esse problema, é necessário remover o diretório de dados no slave:
rm -rf /var/lib/postgresql/Isso deve ser feito apenas no slave!
Ao conectar uma réplica limpa, o Patroni faz um basebackup do líder e o restaura na réplica, e então sincroniza o estado atual pelos logs wal.
Mais uma dificuldade que encontramos é que todos os clusters PostgreSQL são nomeados como main por padrão. Quando cada cluster não sabe nada sobre o outro, isso é aceitável. Mas quando você quer usar o Patroni, todos os clusters devem ter um nome único. A solução é alterar o nome do cluster na configuração do PostgreSQL.
Teste de carga
Executamos um teste que simula o trabalho dos usuários em painéis. Quando a carga atingiu nossa média diária, repetimos exatamente o mesmo teste, desligando uma instância com o leader PostgreSQL. O failover automático funcionou como esperávamos: o Patroni trocou o líder, o Consul-template atualizou a configuração do PgBouncer e emitiu o comando para reload. Nossos gráficos no Grafana mostraram que havia atrasos de 20 a 30 segundos e um pequeno volume de erros dos servidores relacionados à conexão com o banco. Essa é uma situação normal, esses valores são aceitáveis para nosso failover e definitivamente melhores do que o tempo de inatividade do serviço.
Saída do Patroni em produção
No final, nosso plano ficou assim:
- Implantação do Consul-template nos servidores PgBouncer e início;
- Atualização do PostgreSQL para a versão 11.2;
- Mudança do nome do cluster;
- Início do cluster Patroni.
Ao mesmo tempo, nosso esquema permite que o primeiro ponto seja feito a qualquer momento, podemos remover cada PgBouncer da operação um por um e realizar a implantação e o início do consul-template. E foi isso que fizemos.
Para uma rápida implementação, usamos o Ansible, já que todos os playbooks foram testados em ambiente de teste, e o tempo de execução do cenário completo variou de 1,5 a 2 minutos por sharding. Poderíamos implantar cada sharding um por um sem parar nosso serviço, mas teríamos que desligar cada PostgreSQL por alguns minutos. Nesse caso, os usuários cujos dados estão nesse shard não poderiam trabalhar plenamente nesse intervalo, o que é inaceitável para nós.
A solução para essa situação foi uma manutenção programada que realizamos a cada 3 meses. Este é um período para trabalhos planejados, quando desligamos completamente nosso serviço e atualizamos as instâncias dos bancos de dados. Restava uma semana até a próxima janela, e decidimos apenas esperar e nos preparar mais. Durante o tempo de espera, tomamos algumas precauções: levantamos uma réplica de reserva para cada shard do PostgreSQL por precaução contra falhas, para manter os dados mais recentes, e adicionamos uma nova instância para cada shard, que deve se tornar uma nova réplica no cluster Patroni, de modo que não precisássemos executar o comando para excluir dados. Tudo isso ajudou a minimizar o risco de erro.
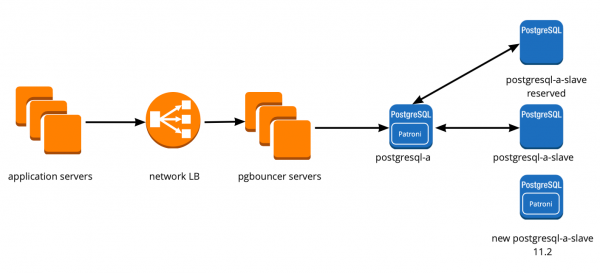
Reiniciamos nosso serviço, tudo funcionou como deveria, os usuários continuaram a trabalhar, mas notamos uma carga anormalmente alta nos servidores do Consul nos gráficos.
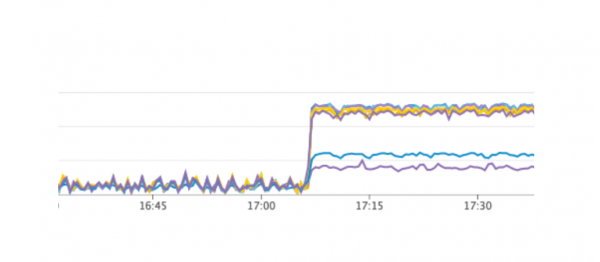
Por que não vimos isso no ambiente de teste? Este problema ilustra bem a necessidade de seguir o princípio de Infrastructure as Code e aprimorar toda a infraestrutura, desde os ambientes de teste até o de produção. Caso contrário, é muito fácil enfrentar um problema como o que tivemos. O que aconteceu? O Consul apareceu primeiro no ambiente de produção e depois nos ambientes de teste; no final, a versão do Consul nos ambientes de teste era mais alta que a do ambiente de produção. Em uma das versões, uma vazamento de CPU ao trabalhar com consul-template foi resolvido. Portanto, simplesmente atualizamos o Consul, resolvendo assim o problema.
Reiniciar o cluster Patroni
No entanto, encontramos um novo problema do qual nem suspeitávamos. Ao atualizar o Consul, simplesmente removemos o nó do Consul do cluster com o comando consul leave → o Patroni se conecta a outro servidor Consul → tudo funciona. Mas, quando chegamos à última instância do cluster Consul e enviamos a ele o comando consul leave, todos os clusters Patroni simplesmente reiniciaram, e nos logs vimos o seguinte erro:
ERRO: get_cluster
Rastreamento (chamada mais recente por último):
...
RetryFailedError: 'Prazo de repetição excedido'
ERRO: Erro na comunicação com DCS
<b>LOG: o sistema de banco de dados foi encerrado</b>
O cluster Patroni não conseguiu obter informações sobre o seu cluster e reiniciou.
Para encontrar uma solução, entramos em contato com os autores do Patroni através de uma issue no GitHub. Eles sugeriram melhorias em nossos arquivos de configuração:
consul:
 consul.checks: []
bootstrap:
 dcs:
   retry_timeout: 8
Conseguimos reproduzir o problema no ambiente de teste e testamos esses parâmetros lá, mas, infelizmente, eles não funcionaram.
O problema ainda não foi resolvido. Pretendemos tentar as seguintes opções de solução:
- Usar o agente Consul em cada instância do cluster Patroni;
- Corrigir o problema no código.
Entendemos onde a falha ocorre: provavelmente, o problema está no uso do timeout padrão, que não é redefinido através do arquivo de configuração. Ao remover o último servidor Consul do cluster, todo o cluster Consul congela por mais de um segundo, o que impede o Patroni de obter o estado do cluster e faz com que ele reinicie todo o cluster.
Felizmente, não encontramos mais erros.
Resultados do uso do Patroni
Após o lançamento bem-sucedido do Patroni, adicionamos uma réplica extra em cada cluster. Agora, cada cluster possui um tipo de quorum: um líder e duas réplicas, para garantir a segurança em caso de split-brain durante a troca.
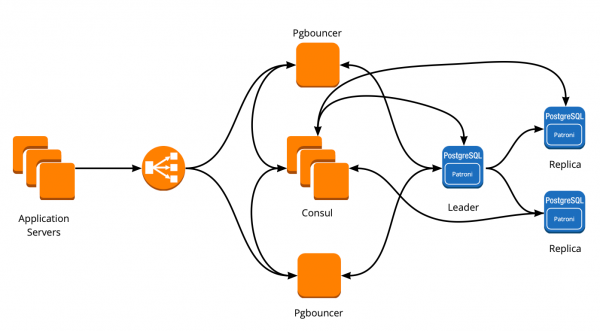
No ambiente de produção, o Patroni está em funcionamento há mais de três meses. Durante esse tempo, já nos ajudou bastante. Recentemente, o líder de um dos clusters na AWS falhou, e o failover automático ocorreu, permitindo que os usuários continuassem trabalhando. O Patroni cumpriu sua principal tarefa.
Um pequeno resumo do uso do Patroni:
- Facilidade de alteração da configuração. Basta alterar a configuração em uma instância e ela se aplicará ao todo o cluster. Se for necessária uma reinicialização para aplicar a nova configuração, o Patroni informará sobre isso. O Patroni pode reiniciar todo o cluster com um único comando, o que também é muito conveniente.
- O failover automático funciona e já nos ajudou.
- Atualização do PostgreSQL sem downtime da aplicação. Primeiro, é necessário atualizar as réplicas para a nova versão, em seguida, trocar o líder no cluster Patroni e atualizar o líder antigo. Durante esse processo, o teste do failover automático é realizado.
Fonte: habr.com
