

Olá, Habrojeitos! Este livro é adequado para qualquer desenvolvedor que deseja entender o processamento em fluxo. Compreender a programação distribuída ajudará a explorar melhor o Kafka e o Kafka Streams. Seria bom conhecer o próprio framework Kafka, mas não é obrigatório: eu irei explicar tudo o que você precisa saber. Desenvolvedores experientes em Kafka, assim como os iniciantes, dominarão a criação de aplicações interessantes para processamento em fluxo com a biblioteca Kafka Streams através deste livro. Desenvolvedores Java de nível médio e avançado, já familiarizados com conceitos como serialização, aprenderão a aplicar suas habilidades na criação de aplicações Kafka Streams. O código-fonte do livro está escrito em Java 8 e faz uso significativo da sintaxe de expressões lambda do Java 8, então a habilidade de trabalhar com funções lambda (mesmo em outra linguagem de programação) será útil para você.
Fragmento. 5.3. Agregação e operações de janela
Nesta seção, iremos abordar as partes mais promissoras do Kafka Streams. Até agora, examinamos os seguintes aspectos do Kafka Streams:
- criação da topologia de processamento;
- uso de estado em aplicações de fluxo;
- execução de junções de fluxos de dados;
- diferenças entre fluxos de eventos (KStream) e fluxos de atualizações (KTable).
Nos próximos exemplos, iremos unir todos esses elementos. Além disso, você será apresentado às operações de janela — mais uma capacidade notável das aplicações de fluxo. Nosso primeiro exemplo será uma agregação simples.
5.3.1. Agregação do volume de vendas de ações por setores da indústria
Agregação e agrupamento são ferramentas essenciais ao trabalhar com dados em fluxo. Analisar registros individuais à medida que chegam muitas vezes não é suficiente. Para extrair informações adicionais dos dados, é necessário agrupá-los e combiná-los.
Neste exemplo, você assumirá o papel de um trader intraday que precisa acompanhar os volumes de vendas das ações de empresas em vários setores da indústria. Em particular, você se interessará pelas cinco empresas com os maiores volumes de vendas em cada setor da indústria.
Para tal agregação, serão necessários alguns passos subsequentes para transformar os dados na forma desejada (falando de maneira geral).
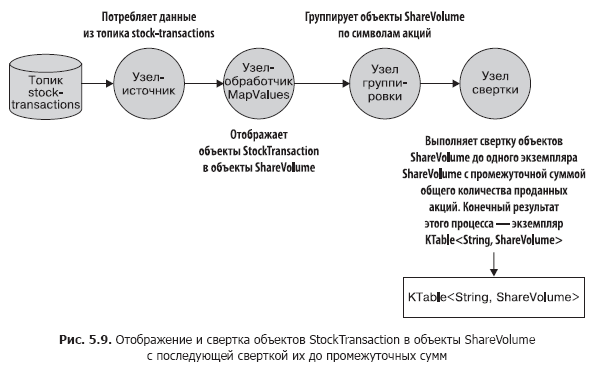
- Criar uma fonte baseada em tópicos que publique informações brutas sobre negociações de ações. Precisamos mapear o objeto do tipo StockTransaction para o objeto do tipo ShareVolume. O fato é que o objeto StockTransaction contém metadados de vendas, mas precisamos apenas dos dados sobre a quantidade de ações vendidas.
- Agrupar os dados de ShareVolume por símbolos das ações. Após a agregação pelos símbolos, podemos resumir esses dados em somas intermediárias dos volumes de vendas de ações. Vale ressaltar que o método KStream.groupBy retorna uma instância do tipo KGroupedStream. E para obter uma instância do KTable, devemos chamar o método KGroupedStream.reduce em seguida.
O que é a interface KGroupedStream?
Os métodos KStream.groupBy e KStream.groupByKey retornam uma instância de KGroupedStream. KGroupedStream é uma representação intermediária de um fluxo de eventos após a agregação por chaves. Ele não é destinado a ser trabalhado diretamente. Em vez disso, KGroupedStream é utilizado para operações de agregação, cujo resultado é sempre um KTable. E como o resultado das operações de agregação é um KTable e um armazenamento de estado é aplicado a elas, pode ser que nem todas as atualizações resultantes sejam enviadas adiante pelo pipeline.
O método KTable.groupBy retorna um KGroupedTable análogo — uma representação intermediária de um fluxo de atualizações, reorganizado por chave.
Faremos uma pequena pausa e olharemos para a Fig. 5.9, que mostra o que conseguimos. Esta topologia já deve ser familiar para você.
Agora vamos olhar para o código desta topologia (ele pode ser encontrado no arquivo src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listagem 5.2).
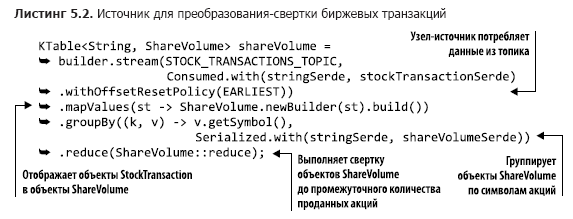
O código apresentado é conciso e realiza uma grande quantidade de operações em poucas linhas. No primeiro parâmetro do método builder.stream, você pode notar algo novo para você: o valor do tipo enumerado AutoOffsetReset.EARLIEST (também existe o LATEST), definido usando o método Consumed.withOffsetResetPolicy. Com este tipo enumerado, você pode especificar a estratégia de redefinição de deslocamentos para cada um dos KStream ou KTable, que tem prioridade sobre o parâmetro de redefinição de deslocamentos na configuração.
GroupByKey e GroupBy
Na interface KStream, existem dois métodos para agrupar registros: GroupByKey e GroupBy. Ambos retornam KGroupedTable, então você pode se perguntar: qual é a diferença entre eles e quando usar cada um?
O método GroupByKey é aplicado quando as chaves no KStream já não estão vazias. E o principal, a flag "exige novo particionamento" nunca foi definida.
O método GroupBy pressupõe que você mudou as chaves para agrupamento, então a flag de novo particionamento está definida como verdadeira. A execução após o método GroupBy de joins, agregações, etc., resultará em novo particionamento automático.
Resumo: deve-se usar o GroupByKey sempre que possível, ao invés do GroupBy.
O que os métodos mapValues e groupBy fazem é claro, então vamos dar uma olhada no método sum() (ele pode ser encontrado no arquivo src/main/java/bbejeck/model/ShareVolume.java) (listagem 5.3).
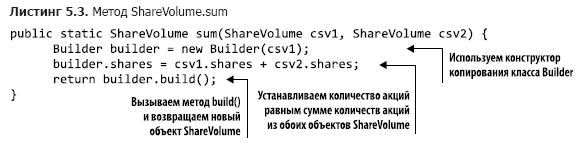
O método ShareVolume.sum retorna a soma intermediária do volume de vendas das ações, e o resultado de toda a cadeia de cálculos representa um objeto KTable. Agora você entende qual é o papel do KTable. Ao receber objetos ShareVolume, a última atualização relevante é armazenada no respectivo objeto KTable. É importante não esquecer que todas as atualizações são refletidas no shareVolumeKTable anterior, mas nem todas são enviadas adiante.
Com esse KTable, realizamos a agregação (com base no número de ações vendidas) para obter as cinco empresas com os maiores volumes de vendas de ações em cada setor. Nossas ações serão semelhantes às do primeiro agrupamento.
- Executar outra operação groupBy para agrupar objetos ShareVolume por setores.
- Começar a somar os objetos ShareVolume. Desta vez, o objeto de agregação é uma fila de prioridade de tamanho fixo. Nessa fila de tamanho fixo, são mantidas apenas cinco empresas com os maiores números de ações vendidas.
- Mapear as filas do item anterior para um valor de string e retornar as cinco mais vendidas em termos de quantidade de ações, por setores.
- Gravar os resultados em formato string em um tópico.
A figura 5.10 mostra o gráfico da topologia do fluxo de dados. Como você pode ver, o segundo ciclo de processamento é bastante simples.
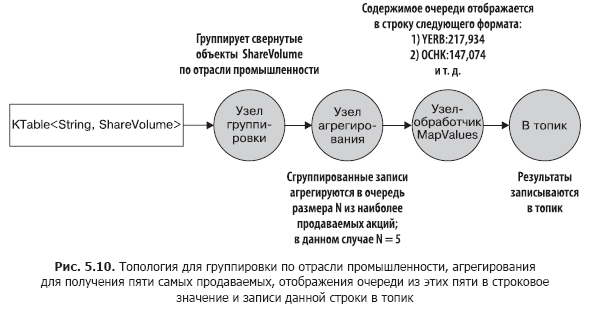
Agora, ao entender claramente a estrutura deste segundo ciclo de processamento, você pode consultar seu código-fonte (você o encontrará no arquivo src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listagem 5.4).
Neste inicializador, há uma variável fixedQueue. Este é um objeto personalizado - um adaptador para java.util.TreeSet, que é usado para rastrear os N maiores resultados em ordem decrescente da quantidade de ações vendidas.
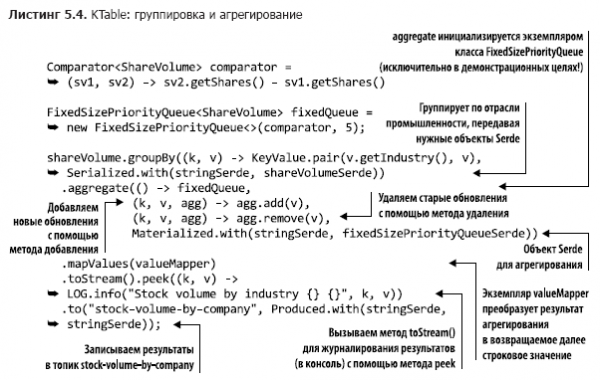
Você já se deparou com as chamadas groupBy e mapValues, então não vamos nos deter nelas (chamamos o método KTable.toStream, uma vez que o método KTable.print é considerado obsoleto). No entanto, você ainda não viu a versão KTable do método aggregate(), então vamos gastar um tempo discutindo isso.
Como você se lembra, a KTable se distingue pelo fato de que registros com chaves iguais são considerados atualizações. A KTable substitui o registro antigo pelo novo. A agregação ocorre de forma semelhante: agregam-se os registros mais recentes com uma mesma chave. Quando um registro é recebido, ele é adicionado à instância da classe FixedSizePriorityQueue usando um somador (o segundo parâmetro na chamada do método aggregate), mas se já existir outro registro com a mesma chave, o registro antigo é removido usando um subtrator (o terceiro parâmetro na chamada do método aggregate).
Isso significa que nosso agregador, FixedSizePriorityQueue, não agrega todos os valores com uma mesma chave, mas mantém uma soma móvel das quantidades dos N tipos de ações mais vendidas. Em cada registro recebido, está contida a quantidade total de ações vendidas até o momento. A KTable irá fornecer informações sobre quais ações de quais empresas estão sendo vendidas mais no momento, a agregação móvel de cada uma das atualizações não é necessária.
Aprendemos a fazer duas coisas importantes:
- agrupar valores na KTable por uma chave comum a eles;
- realizar operações úteis sobre esses valores agrupados, como redução e agregação.
Ser capaz de realizar essas operações é importante para entender o significado dos dados que estão se movendo através do aplicativo Kafka Streams e descobrir qual informação eles transportam.
Também reunimos alguns dos conceitos-chave discutidos anteriormente neste livro. No Capítulo 4, falamos sobre a importância do estado local e tolerante a falhas para um aplicativo de streaming. O primeiro exemplo deste capítulo demonstrou por que o estado local é tão crítico — ele permite rastrear quais informações você já viu. O acesso local evita atrasos de rede, tornando o aplicativo mais eficiente e resiliente a erros.
Ao realizar qualquer operação de redução ou agregação, é necessário especificar o nome do repositório de estado. As operações de redução e agregação retornam uma instância de KTable, e KTable usa o repositório de estado para substituir os resultados antigos pelos novos. Como você viu, nem todas as atualizações são enviadas adiante pelo pipeline, e isso é importante, uma vez que as operações de agregação visam obter informações finais. Se o estado local não for aplicado, KTable enviará todos os resultados de agregação e redução adiante.
Em seguida, vamos explorar a execução de operações como agregação dentro de um intervalo de tempo específico — as chamadas operações de janela (windowing operations).
5.3.2. Operações de Janela
Na seção anterior, conhecemos as operações de redução e agregação 'deslizantes'. O aplicativo realizava uma redução contínua do volume de vendas de ações seguida da agregação das cinco ações mais vendidas na bolsa.
Às vezes, operações contínuas de agregação e redução de resultados são necessárias. E em outras situações, precisamos realizar operações apenas em um intervalo de tempo específico. Por exemplo, calcular quantas operações de ações de uma empresa específica foram feitas nos últimos 10 minutos. Ou quantos usuários clicaram em um novo banner publicitário nos últimos 15 minutos. O aplicativo pode realizar essas operações repetidamente, mas com resultados relacionados apenas aos intervalos de tempo especificados (janelas temporais).
Contabilizando transações de ações por comprador
No próximo exemplo, nos ocuparemos em rastrear transações de ações por vários traders — seja grandes instituições ou investidores individuais astutos.
Existem duas possíveis razões para esse tipo de rastreamento. Uma delas é a necessidade de saber o que os líderes do mercado estão comprando/vendendo. Se esses grandes players e investidores experientes identificam oportunidades, faz sentido seguir suas estratégias. A segunda razão é o desejo de notar quaisquer sinais potenciais de transações ilegais usando informações privilegiadas. Para isso, será necessário analisar a correlação entre grandes picos de vendas e importantes comunicados de imprensa.
Esse rastreamento consiste em etapas como:
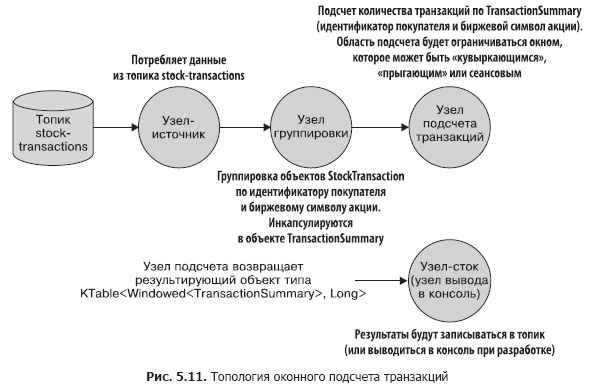
- a criação de um fluxo de leitura a partir do tópico stock-transactions;
- agrupamento de registros de entrada por identificador de comprador e símbolo da ação. A chamada do método groupBy retorna uma instância da classe KGroupedStream;
- o retorno do fluxo de dados delimitado por um período de tempo com o método KGroupedStream.windowedBy, permitindo a agregação em janelas. Dependendo do tipo de janela, retorna-se um TimeWindowedKStream ou SessionWindowedKStream;
- a contagem de transações para a operação de agregação. O fluxo de dados em janela determina se um registro específico é levado em consideração durante essa contagem;
- o registro dos resultados em um tópico ou sua saída no console durante o desenvolvimento.
A topologia dessa aplicação é simples, mas uma representação visual não faria mal. Vamos olhar para a Fig. 5.11.
Em seguida, abordaremos a funcionalidade das operações em janela e o código correspondente.
Tipos de janelas
No Kafka Streams, existem três tipos de janelas:
- janelas de sessão;
- janelas de “tumbling”;
- janelas deslizantes/“hopping”.
Qual escolher depende dos requisitos de negócios. As janelas de “tumbling” e “hopping” têm limites de tempo, enquanto as janelas de sessão estão ligadas às ações dos usuários — a duração da(s) sessão(ões) é determinada exclusivamente pela atividade do usuário. O principal é não esquecer que todos os tipos de janelas são baseados em carimbos de data/hora dos registros, e não no tempo do sistema.
Em seguida, implementaremos nossa topologia com cada um dos tipos de janelas. O código completo será apresentado apenas no primeiro exemplo, para os outros tipos de janelas nada mudará, exceto o tipo da operação em janelas.
Janelas de sessão
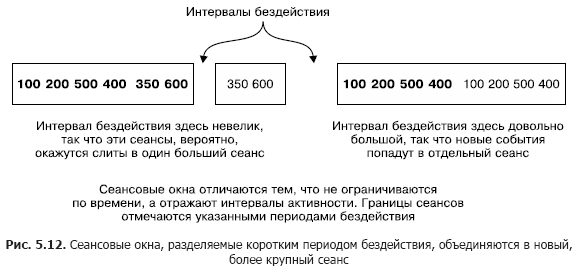
As janelas de sessão diferem significativamente de todos os outros tipos de janelas. Elas são limitadas não tanto pelo tempo, mas pela atividade do usuário (ou pela atividade da entidade que você gostaria de rastrear). Janelas de sessão são demarcadas por períodos de inatividade.
A Figura 5.12 ilustra o conceito de janelas de sessão. Uma sessão menor se fundirá com a sessão à sua esquerda. Já a sessão à direita será separada, pois ocorre após um longo período de inatividade. As janelas de sessão são baseadas nas ações dos usuários, mas aplicam marcas de data/hora das entradas para determinar a qual sessão a entrada pertence.
Uso de janelas de sessão para rastrear transações de mercado
Usaremos janelas de sessão para capturar informações sobre transações de mercado. A implementação das janelas de sessão é mostrada na listagem 5.5 (que pode ser encontrada no arquivo src/main/java/bbejeck/chapter_5/CountingWindowingAndKTableJoinExample.java).
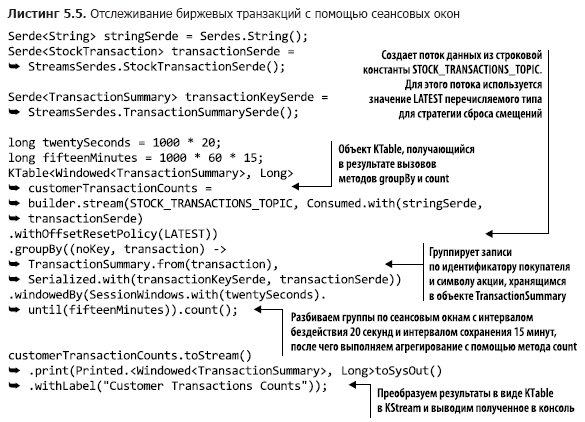
A maioria das operações desta topologia você já encontrou antes, então não há necessidade de revisá-las aqui novamente. Mas há alguns novos elementos que discutiremos agora.
Em qualquer operação groupBy, geralmente alguma operação de agregação é realizada (agregação, resumo ou contagem). Pode-se realizar uma agregação acumulativa com um total à vista ou uma agregação de janela, na qual registros dentro de uma janela de tempo definida são considerados.
O código da listagem 5.5 conta o número de transações dentro das janelas de sessão. Na Fig. 5.13, essas ações são analisadas passo a passo.
Com a chamada windowedBy(SessionWindows.with(twentySeconds).until(fifteenMinutes)), criamos uma janela de sessão com um intervalo de inatividade de 20 segundos e um intervalo de retenção de 15 minutos. O intervalo de inatividade de 20 segundos significa que o aplicativo incluirá qualquer registro que chegar dentro de 20 segundos do término ou início da sessão atual na sessão atual (ativa).
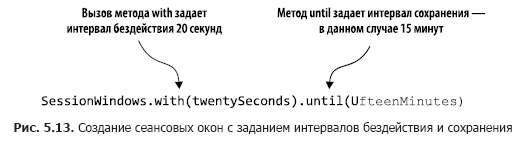
Em seguida, indicamos qual operação de agregação deve ser realizada na janela de sessão — neste caso, contagem. Se o registro de entrada estiver fora do intervalo de inatividade (de qualquer lado do carimbo de data/hora), o aplicativo cria uma nova sessão. O intervalo de retenção significa manter a sessão durante um determinado tempo e permite dados atrasados que ficam além do período de inatividade da sessão, mas ainda podem ser anexados. Além disso, o início e o fim da nova sessão resultante da fusão correspondem ao carimbo de data/hora mais antigo e mais recente.
Vamos considerar alguns registros do método count para ver como as sessões funcionam (tabela 5.1).
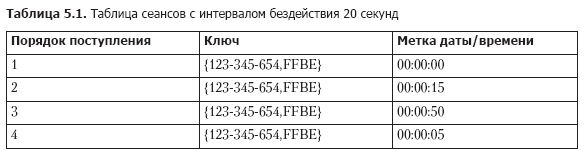
Ao receber registros, procuramos por sessões existentes com a mesma chave, com o tempo de término inferior ao carimbo de data/hora atual — intervalo de inatividade e um tempo de início maior que o carimbo de data/hora atual + intervalo de inatividade. Com isso, quatro registros da tabela 5.1 se fundem em uma única sessão da seguinte forma.
1. O registro 1 é recebido primeiro, portanto, o tempo de início é igual ao tempo de término e é 00:00:00.
2. Em seguida, o registro 2 é recebido, e procuramos por sessões que terminam não antes de 23:59:55 e começam não depois de 00:00:35. Encontramos o registro 1 e fundimos as sessões 1 e 2. Pegamos o tempo de início da sessão 1 (o mais antigo) e o tempo de término da sessão 2 (o mais recente), então nossa nova sessão começa em 00:00:00 e termina em 00:00:15.
3. O registro 3 é recebido, procuramos sessões entre 00:00:30 e 00:01:10 e não encontramos nenhuma. Adicionamos a segunda sessão para a chave 123-345-654,FFBE, que começa e termina em 00:00:50.
4. O registro 4 é recebido, e procuramos sessões entre 23:59:45 e 00:00:25. Desta vez, ambos os sessions — 1 e 2 são encontrados. Todas as três sessões se fundem em uma, com tempo de início 00:00:00 e tempo de término 00:00:15.
Dos pontos discutidos nesta seção, vale lembrar os seguintes aspectos importantes:
- as sessões não são janelas de tamanho fixo. A duração da sessão é determinada pela atividade dentro de um intervalo de tempo definido;
- os carimbos de data/hora nos dados determinam se um evento se encaixa em uma sessão existente ou em um intervalo de inatividade.
Em seguida, discutiremos o próximo tipo de janela — as janelas "rolantes".
Janelas "rolantes"
As janelas "em tumulo" (tumbling) capturam eventos que ocorrem dentro de um determinado intervalo de tempo. Imagine que você precisa capturar todas as transações de bolsa de uma empresa a cada 20 segundos, então você coleta todos os eventos durante esse intervalo. Ao final do intervalo de 20 segundos, a janela "em tumulo" se move para um novo intervalo de observação de 20 segundos. A Figura 5.14 ilustra essa situação.
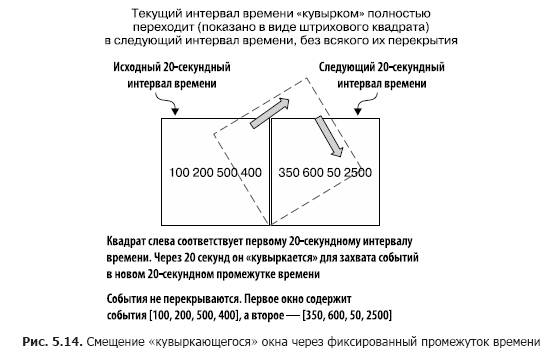
Como você pode ver, todos os eventos recebidos nos últimos 20 segundos estão incluídos na janela. Quando esse intervalo de tempo termina, uma nova janela é criada.
O Listado 5.6 apresenta o código que demonstra o uso de janelas "em tumulo" para capturar transações de bolsa a cada 20 segundos (você pode encontrá-lo no arquivo src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
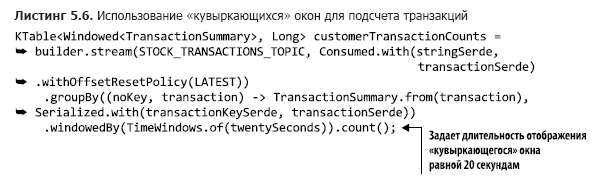
Graças a essa pequena mudança na chamada do método TimeWindows.of, é possível usar uma janela "em tumulo". Neste exemplo, não há chamada para o método until(), portanto, será utilizado o intervalo de retenção padrão, que é de 24 horas.
Finalmente, é hora de passar para a última das opções de janelas — as janelas "deslizantes" (hopping).
Janelas deslizantes (hopping)
As janelas deslizantes / "hopping" (sliding/hopping) são semelhantes às janelas "em tumulo", mas com uma pequena diferença. As janelas deslizantes não esperam o término do intervalo de tempo antes de criar uma nova janela para processar eventos recentes. Elas iniciam novos cálculos após um intervalo de espera menor do que a duração da janela.
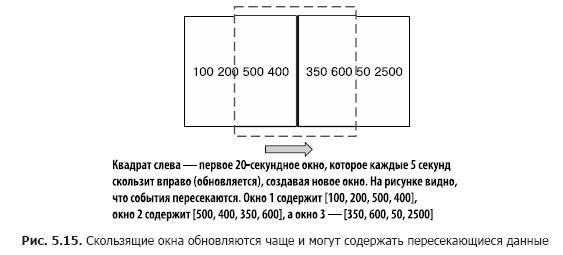
Para ilustrar as diferenças entre janelas "em tumulo" e "deslizantes", voltamos ao exemplo de contagem de transações de bolsa. Nosso objetivo ainda é contar o número de transações, mas não gostaríamos de esperar todo o período de tempo antes de atualizar o contador. Em vez disso, vamos atualizar o contador a cada intervalos de tempo mais curtos. Por exemplo, vamos contar o número de transações a cada 20 segundos, mas atualizar o contador a cada 5 segundos, como mostrado na Fig. 5.15. Isso nos dá três janelas de resultados com dados sobrepostos.
O Listado 5.7 apresenta o código para definir janelas deslizantes (você pode encontrá-lo no arquivo src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
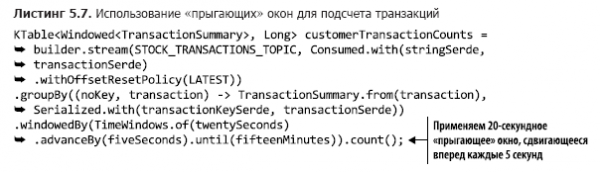
Uma janela "rolante" pode ser transformada em uma janela "saltitante" ao adicionar uma chamada ao método advanceBy(). No exemplo dado, o intervalo de retenção é de 15 minutos.
Neste seção, você viu como limitar os resultados de agregação com janelas temporais. Em particular, gostaria que você se lembrasse das seguintes três coisas desta seção:
- o tamanho das janelas de sessão é limitado não pelo intervalo de tempo, mas pela atividade dos usuários;
- as janelas "rolantes" fornecem uma visão dos eventos dentro de um período de tempo definido;
- a duração das janelas "saltitantes" é fixa, mas elas são frequentemente atualizadas e podem conter entradas que se sobrepõem em todas as janelas.
A seguir, aprenderemos como converter KTable de volta em KStream para junção.
5.3.3. Junção de objetos KStream e KTable
No capítulo 4, discutimos a junção de dois objetos KStream. Agora, precisamos aprender como juntar KTable e KStream. Isso pode ser necessário pela seguinte razão simples. KStream é um fluxo de registros, enquanto KTable é um fluxo de atualizações de registros, mas às vezes pode ser necessário adicionar contexto adicional ao fluxo de registros com atualizações do KTable.
Vamos pegar dados sobre o número de transações de ações e juntar isso com notícias do mercado relacionadas a setores específicos da indústria. Isso é o que precisamos fazer para alcançar isso, levando em consideração o código já existente.
- Converter o objeto KTable com dados sobre o número de transações de ações em KStream, substituindo a chave pela chave que representa o setor correspondente a esse símbolo de ações.
- Criar um objeto KTable que lê dados do tópico de notícias do mercado. Este novo KTable será categorizado por setores da indústria.
- Juntar as atualizações de notícias com as informações sobre o número de transações de ações por setores da indústria.
Agora vamos ver como implementar este plano de ação.
Converter KTable em KStream
Para converter KTable em KStream, é necessário fazer o seguinte.
- Chamar o método KTable.toStream().
- Usando a chamada do método KStream.map, substituir a chave pelo nome do setor da indústria e, em seguida, extrair do objeto Windowed uma instância de TransactionSummary.
Vamos encadear essas operações da seguinte forma (o código pode ser encontrado no arquivo src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listagem 5.8).
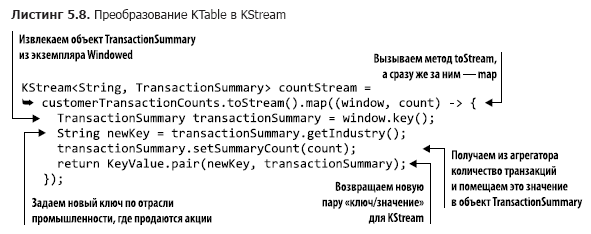
Como estamos realizando a operação KStream.map, a repartição para a instância KStream retornada é feita automaticamente ao seu uso em uma junção.
Concluímos o processo de conversão, agora precisamos criar um objeto KTable para ler as notícias de mercado.
Criação do KTable para notícias de mercado
Felizmente, para criar o objeto KTable, é suficiente uma única linha de código (este código pode ser encontrado no arquivo src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listagem 5.9).
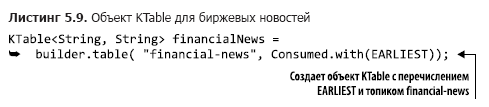
Vale ressaltar que não é necessário especificar nenhum objeto Serde, uma vez que nas configurações são utilizados Serde de string. Além disso, com a aplicação da enumeração EARLIEST, a tabela é preenchida com registros desde o início.
Agora podemos prosseguir para a etapa final — a junção.
Junção de atualizações de notícias com dados sobre o número de transações
A criação da junção não apresenta dificuldades. Usaremos a junção à esquerda, caso não haja notícias de mercado para a indústria correspondente (o código necessário pode ser encontrado no arquivo src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listagem 5.10).
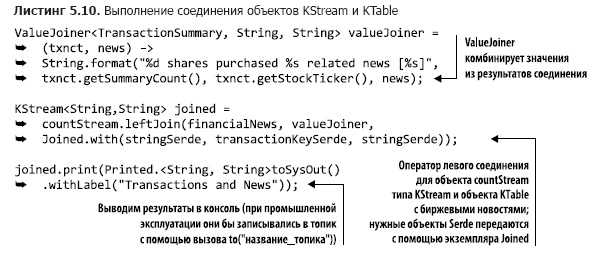
Este operador leftJoin é bastante simples. Ao contrário das junções do capítulo 4, o método JoinWindow não é utilizado, pois na junção KStream-KTable, para cada chave no KTable, existe apenas um registro. Essa junção não é restrita por tempo: o registro pode estar presente ou não no KTable. A principal conclusão é que objetos KTable podem enriquecer o KStream com dados de referência menos frequentemente atualizados.
Agora vamos considerar uma maneira mais eficiente de enriquecer eventos do KStream.
5.3.4. Objetos GlobalKTable
Como você entendeu, há a necessidade de enriquecer os fluxos de eventos ou de adicionar contexto a eles. No capítulo 4, você viu junções entre dois objetos KStream, e na seção anterior — a junção entre KStream e KTable. Em todos esses casos, é necessário a repartição do fluxo de dados ao mapear chaves para um novo tipo ou valor. Às vezes, a repartição é feita explicitamente, e às vezes o Kafka Streams faz isso automaticamente. A repartição é necessária porque as chaves mudaram, e os registros devem estar nas novas partições, caso contrário, a junção se tornará impossível (isso foi discutido no capítulo 4, na seção 'Repartição de dados' da subseção 4.2.4).
A re-partitioning tem seu custo
A re-partitioning requer gastos — custos adicionais de recursos para criar tópicos intermediários, manter dados duplicados em mais um tópico; isso também significa aumento da latência devido à gravação e leitura desse tópico. Além disso, se for necessário realizar junção em mais de um aspecto ou dimensão, é preciso organizar as junções em cadeia, mapear registros com novas chaves e repetir o processo de re-partitioning.
Juntando conjuntos de dados menores
Em alguns casos, o volume de dados de referência com o qual se pretende juntar é relativamente pequeno, de modo que suas cópias completas podem caber localmente em cada um dos nós. Para tais situações, o Kafka Streams possui a classe GlobalKTable.
As instâncias de GlobalKTable são únicas, pois o aplicativo replica todos os dados em cada nó. E como em cada nó estão presentes todos os dados, não há necessidade de particionar o fluxo de eventos pela chave dos dados de referência para que esteja disponível em todas as partições. Com os objetos GlobalKTable, também é possível realizar junções sem chave. Vamos voltar a um dos exemplos anteriores para demonstrar essa possibilidade.
Juntando objetos KStream com objetos GlobalKTable
Na subseção 5.3.2, realizamos a agregação em janelas de transações de bolsa por clientes. Os resultados dessa agregação eram mais ou menos os seguintes:
{customerId='074-09-3705', stockTicker='GUTM'}, 17
{customerId='037-34-5184', stockTicker='CORK'}, 16
Embora esses resultados correspondessem ao objetivo proposto, seria mais conveniente se também fossem exibidos o nome do cliente e o nome completo da empresa. Para adicionar o nome do comprador e a razão social, podem ser realizadas junções normais, mas isso exigiria duas mapeações de chaves e re-partitioning. Com GlobalKTable, é possível evitar os custos dessas operações.
Para isso, utilizaremos o objeto countStream do listagem 5.11 (o código correspondente pode ser encontrado no arquivo src/main/java/bbejeck/chapter_5/GlobalKTableExample.java), unindo-o a dois objetos GlobalKTable.
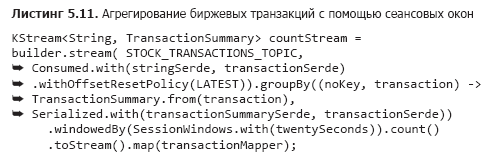
Já discutimos isso anteriormente, então não vou repetir. Mas quero ressaltar que o código na função toStream().map foi abstraído em um objeto-função para melhorar a legibilidade em vez de usar uma expressão lambda incorporada.
A próxima etapa é declarar duas instâncias de GlobalKTable (o código correspondente pode ser encontrado no arquivo src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (listagem 5.12).
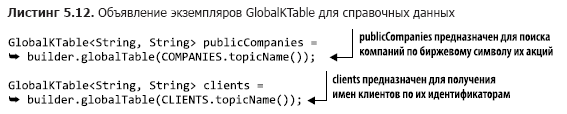
Observe que os nomes dos tópicos são descritos por meio de tipos enumerados.
Agora que preparamos todos os componentes, resta escrever o código para a junção (que pode ser encontrado no arquivo src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (listagem 5.13).
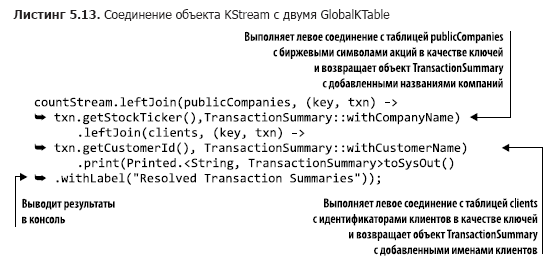
Embora este código contenha duas junções, elas estão organizadas em uma cadeia, pois separadamente nenhum de seus resultados é utilizado. Os resultados são exibidos no final de toda a operação.
Ao executar a operação de junção acima, você receberá resultados da seguinte forma:
{customer='Barney, Smith' company="Exxon", transactions= 17}A essência não mudou, mas esses resultados são mais claros.
Se contar com o capítulo 4, você já viu vários tipos de junções em ação. Eles estão listados na tabela 5.2. Esta tabela reflete as capacidades de junção relevantes para a versão 1.0.0 do Kafka Streams; em lançamentos futuros, pode haver alterações.
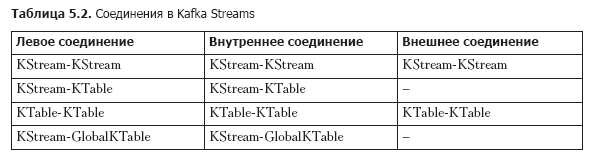
Para concluir, quero lembrar o essencial: você pode juntar fluxos de eventos (KStream) e fluxos de atualizações (KTable) usando um estado local. Além disso, se o tamanho dos dados de referência não for muito grande, você pode usar o objeto GlobalKTable. O GlobalKTable replica todas as partições em cada um dos nós da aplicação Kafka Streams, garantindo assim a disponibilidade de todos os dados, independentemente de qual partição o chave corresponde.
Em seguida, veremos a capacidade do Kafka Streams que permite observar mudanças de estado sem consumir dados do tópico Kafka.
5.3.5. Estado disponível para consultas
Já realizamos várias operações envolvendo estado e sempre exibimos os resultados no console (para fins de desenvolvimento) ou os gravamos em um tópico (para fins de produção). Ao gravar resultados em um tópico, é necessário usar um consumidor Kafka para visualizá-los.
A leitura de dados desses tópicos pode ser considerada uma forma de visões materializadas (materialized views). Para nossas necessidades, podemos usar a definição de visão materializada da "Wikipedia": "... um objeto físico do banco de dados que contém os resultados da execução de uma consulta. Por exemplo, pode ser uma cópia local de dados remotos, ou um subconjunto de linhas e/ou colunas de uma tabela ou resultados de junção, ou uma tabela dinâmica obtida através de agregação" (https://en.wikipedia.org/wiki/Materialized_view).
Kafka Streams também permite executar consultas interativas (interactive queries) em repositórios de estado, o que possibilita a leitura direta dessas visões materializadas. É importante notar que a consulta ao repositório de estado é uma operação de "somente leitura". Com isso, você não precisa se preocupar em acidentalmente deixar o estado inconsistente durante o processamento de dados pelo aplicativo.
A capacidade de realizar consultas diretas nos repositórios de estado é de grande importância. Isso significa que é possível criar aplicativos — painéis de informações sem precisar obter os dados do consumidor Kafka previamente. Isso também aumenta a eficiência do aplicativo, já que não é necessário reescrever os dados:
- graças à localidade dos dados, eles podem ser acessados rapidamente;
- é evitada a duplicação de dados, pois eles não são gravados em um repositório externo.
O mais importante que eu gostaria que você lembrasse: é possível executar consultas diretamente ao estado a partir do aplicativo. Não se pode subestimar as possibilidades que isso oferece. Em vez de consumir dados do Kafka e armazenar registros em um banco de dados para o aplicativo, você pode consultar os repositórios de estado com o mesmo resultado. As consultas diretas aos repositórios de estado significam menos volume de código (ausência de consumidor) e menos software (ausência de necessidade de uma tabela de banco de dados para armazenar resultados).
Cobrimos uma quantidade considerável de informações neste capítulo, portanto, por um momento, vamos pausar nossa discussão sobre consultas interativas a repositórios de estado. Mas não se preocupe: no capítulo 9, vamos criar um aplicativo simples — um painel de controle com consultas interativas. Para demonstrar as consultas interativas e as possibilidades de integrá-las em aplicativos Kafka Streams, serão utilizados alguns exemplos deste e do capítulo anterior.
Resumo
- Os objetos KStream representam fluxos de eventos, comparáveis a inserções em um banco de dados. Os objetos KTable representam fluxos de atualizações, mais semelhantes a atualizações em um banco de dados. O tamanho do objeto KTable não cresce, registros antigos são substituídos por novos.
- Os objetos KTable são necessários para operações de agregação.
- Com operações de janelas, é possível segmentar dados agregados em intervalos de tempo.
- Graças aos objetos GlobalKTable, é possível acessar dados de referência em qualquer parte do aplicativo, independentemente da divisão por partições.
- É possível realizar junções entre os objetos KStream, KTable e GlobalKTable.
Até agora, concentramos nossa atenção na criação de aplicativos Kafka Streams usando o DSL KStream de alto nível. Embora a abordagem de alto nível permita criar programas limpos e concisos, seu uso envolve um certo compromisso. Trabalhar com o DSL KStream significa aumentar a concisão do código em troca de uma diminuição no controle. No próximo capítulo, abordaremos a API de baixo nível de nós processadores e exploraremos outros compromissos. Os programas serão mais longos do que eram até agora, mas teremos a possibilidade de criar praticamente qualquer nó processador que pudermos precisar.
→ Saiba mais sobre o livro em
→ Para os usuários do Habr, desconto de 25% com o cupom — Kafka Streams
→ Após o pagamento da versão impressa do livro, um livro eletrônico será enviado por e-mail.
Fonte: habr.com
