

Introdução
Um sistema de informação do ponto de vista do usuário é bem definido na norma GOST RВ 51987 — "sistema automatizado, cujo resultado da operação é a apresentação de informações para uso subsequente". Se considerarmos a estrutura interna, qualquer SI é, na essência, um sistema de algoritmos interconectados implementados em código. Em um sentido amplo, o teorema de Turing-Church afirma que um algoritmo (e, consequentemente, um SI) realiza a transformação de um conjunto de dados de entrada em um conjunto de dados de saída.
Pode-se até afirmar que o sentido da existência de um sistema de informação reside na transformação de dados de entrada. Portanto, o valor do SI e de todo o complexo de SIS é determinado pelo valor dos dados de entrada e saída.
Diante disso, o projeto deve começar e ter como base os dados, ajustando a arquitetura e os métodos à estrutura e importância dos dados.
Dados Armazenados
Uma etapa crucial na preparação para o projeto é a obtenção das características de todos os conjuntos de dados planejados para processamento e armazenamento. Essas características incluem:
— Volume de dados;
— Informações sobre o ciclo de vida dos dados (crescimento de novos dados, tempo de vida, tratamento de dados obsoletos);
— Classificação dos dados do ponto de vista do impacto nos negócios principais da empresa (na tríade de confidencialidade, integridade, disponibilidade) juntamente com métricas financeiras (por exemplo, custo da perda de dados última hora);
— Geografia do processamento de dados (localização física dos sistemas de processamento);
— Requisitos regulatórios para cada classe de dados (por exemplo, Lei Federal-152, PCI DSS).
Sistemas de Informação
Os dados não são apenas armazenados, mas também processados (transformados) por sistemas de informação. O próximo passo após obter as características dos dados é realizar um inventário o mais completo possível dos sistemas de informação, suas características arquitetônicas, interdependências e requisitos de infraestrutura em unidades condicionais para quatro tipos de recursos:
— Poder computacional do processador;
— Volume de memória RAM;
— Requisitos para o volume e desempenho do sistema de armazenamento de dados;
— Requisitos para a rede de transmissão de dados (canais externos, canais entre componentes do SI).
Os requisitos devem ser aplicados a cada serviço/microserviço no conjunto do SI.
É importante destacar a obrigatoriedade de dados sobre o impacto do SI nos negócios principais da empresa, em forma de custo de paralisação do SI (rublos por hora).
Modelo de ameaças
Deve haver um modelo formal de ameaças, que se pretende proteger os dados/serviços. Este modelo de ameaças inclui não apenas aspectos de confidencialidade, mas também de integridade e disponibilidade. Ou seja, por exemplo:
— Falha de um servidor físico;
— Falha de um comutador top-of-the-rack;
— Quebra do canal de comunicação óptica entre os datacenters;
— Falha total do sistema de armazenamento de dados em operação.
Em alguns casos, os modelos de ameaças são elaborados não apenas para componentes de infraestrutura, mas também para sistemas específicos ou seus componentes, como a falha do SGBD com a destruição lógica da estrutura dos dados.
Todas as decisões no âmbito do projeto para proteção contra ameaças não descritas são excessivas.
Requisitos dos reguladores
Se os dados processados estão sujeitos a regras especiais estabelecidas pelos reguladores, é obrigatória a informação sobre conjuntos de dados e regras de processamento/armazenamento.
Indicadores-alvo de RPO/RTO
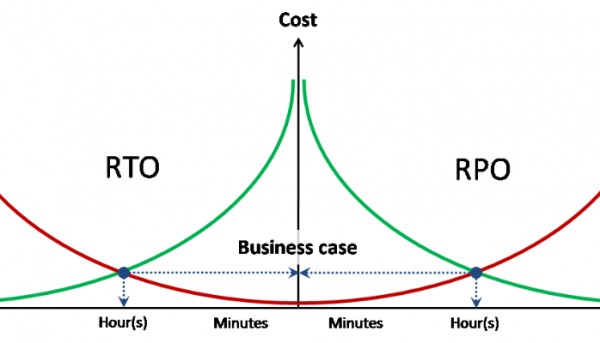
O projeto de qualquer tipo de proteção requer a existência de indicadores de perda de dados alvo e tempo de recuperação do serviço para cada uma das ameaças descritas.
Idealmente, RPO e RTO devem ter custos associados à perda de dados e paralisação por unidade de tempo.
Divisão em pools de recursos
Após a coleta de todas as informações iniciais, o primeiro passo é agrupar conjuntos de dados e SI em pools, com base em modelos de ameaças e requisitos dos reguladores. Define-se o tipo de separação entre diferentes pools – programaticamente ao nível do software do sistema ou fisicamente.
Exemplos:
— O contorno que processa dados pessoais é completamente fisicamente separado dos outros sistemas;
— Backups são armazenados em um sistema de armazenamento separado.
Nesse caso, os pools podem ter independência parcial; por exemplo, definem-se dois pools de recursos computacionais (poder de processamento + memória operacional), que utilizam um único pool de armazenamento de dados e um único pool de recursos de transmissão de dados.
Poder de processamento
As necessidades abstratas de poder de processamento em um data center virtualizado são medidas pela quantidade de processadores virtuais (vCPU) e pela taxa de consolidação em processadores físicos (pCPU). Neste caso específico, 1 pCPU = 1 núcleo físico do processador (sem considerar o Hyper-Threading). O número de vCPUs é somado a todos os pools de recursos designados (cada um dos quais pode ter sua própria taxa de consolidação).
A taxa de consolidação para sistemas sobrecarregados é obtida empiricamente com base na infraestrutura existente ou durante instalações piloto e testes de carga. Para sistemas sem carga, são aplicadas as 'melhores práticas'. Especificamente, a VMware considera uma taxa média de 8:1.
Memória RAM
A necessidade total de memória RAM é obtida através de uma simples soma. O uso de superaprovação de memória RAM não é recomendado.
Recursos de armazenamento
Os requisitos de armazenamento são obtidos pela simples soma de todos os pools em termos de volume e desempenho.
Os requisitos de desempenho são expressos em IOPS, em conjunto com a taxa média de leitura/escrita e, se necessário, com a latência de resposta máxima.
Deve-se especificar separadamente os requisitos de garantia de qualidade de serviço (QoS) para pools ou sistemas específicos.
Recursos de rede de dados
Os requisitos de rede de dados são obtidos pela simples soma de todos os pools de largura de banda.
Deve-se especificar separadamente os requisitos de garantia de qualidade de serviço (QoS) e latências (RTT) para pools ou sistemas específicos.
Dentro dos requisitos de recursos de rede de dados, também são especificados os requisitos de isolamento e/ou criptografia do tráfego de rede e os mecanismos preferenciais (802.1q, IPSec, etc.).
Escolha da arquitetura
Este guia não considera outra escolha além da arquitetura x86 e da virtualização 100% dos servidores. Portanto, a escolha da arquitetura da subsistema computacional se resume à escolha da plataforma de virtualização de servidores, do formato dos servidores e dos requisitos gerais de configuração dos servidores.
O ponto chave na escolha é a clareza em usar a abordagem clássica de separação das funções de processamento, armazenamento e transmissão de dados ou uma abordagem convergente.
Arquitetura clássica implica o uso de subsistemas externos inteligentes de armazenamento e transmissão de dados, enquanto os servidores contribuem para o pool geral de recursos físicos apenas com poder de processamento e memória RAM. No limite, os servidores tornam-se completamente anônimos, não possuindo não apenas seus próprios discos, mas até mesmo um identificador de sistema. Neste caso, utiliza-se o carregamento do SO ou hipervisor a partir de dispositivos flash embutidos ou de um sistema de armazenamento externo (boot from SAN).
Dentro da arquitetura clássica, a escolha entre lâminas (blade) e servidores em rack é feita principalmente pelos seguintes princípios:
— Eficiência econômica (em média, servidores em rack são mais baratos);
— Densidade computacional (as lâminas têm uma densidade maior);
— Consumo de energia e dissipação de calor (as lâminas têm um consumo unitário maior);
— Escalabilidade e gerenciabilidade (as lâminas, em geral, requerem menos esforço em grandes instalações);
— Uso de placas de expansão (para lâminas, a escolha é muito limitada).
Arquitetura convergente (também conhecida como hiperconvergente) pressupõe a combinação de funções de processamento e armazenamento de dados, o que leva ao uso de discos locais nos servidores e, como consequência, à rejeição do fator de forma clássico das lâminas. Sistemas convergentes utilizam servidores em rack ou sistemas de cluster que combinam em um único gabinete vários servidores-lâminas e discos locais.
CPU / Memória
Para calcular corretamente a configuração, é necessário entender o tipo de carga para o ambiente ou cada um dos clusters independentes.
Limitado por CPU – um ambiente limitado pelo poder de desempenho da CPU. Adicionar memória RAM não altera nada em termos de desempenho (número de VMs por servidor).
Limitado por Memória – um ambiente limitado pela memória RAM. Uma maior quantidade de memória RAM no servidor permite a execução de um número maior de VMs no servidor.
GB / MHz (GB / pCPU) – a média da relação de consumo de memória RAM e poder de processamento para essa carga específica. Pode ser usado para calcular o volume necessário de memória para um desempenho específico e vice-versa.
Cálculo da configuração do servidor
Primeiro, é necessário identificar todos os tipos de carga e decidir sobre a combinação ou divisão de diferentes pools computacionais entre vários clusters.
Em seguida, para cada um dos clusters identificados, determina-se a relação GB / MHz com uma carga conhecida previamente. Se a carga não for conhecida, mas houver uma compreensão aproximada do nível de utilização da capacidade da CPU, podem-se usar coeficientes padrão vCPU:pCPU para converter as necessidades dos pools em físicos.
Para cada cluster, a soma das necessidades dos pools vCPU é dividida pelo coeficiente:
vCPUtotal / vCPU:pCPU = pCPUtotal – número necessário de núcleos físicos
pCPUtotal / 1.25 = pCPUht – número de núcleos com correção de Hyper-Threading
Suponha que seja necessário calcular um cluster com 190 núcleos / 3.5TB de RAM. Para isso, aceitamos uma carga alvo de 50% da capacidade da CPU e 75% da memória.
pCPU
190
Utilização da CPU
50%
Mem
3500
Utilização da Memória
75%
Soquete
Núcleo
Srv / CPU
Srv Mem
Srv / Mem
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
Neste caso, sempre utilizamos o arredondamento para cima para o inteiro mais próximo (=ROUNDUP(A1;0)).
Da tabela, fica claro que configurações de servidores equilibradas para as metas alvo são várias:
— 26 servidores 2*6c / 192 GB
— 19 servidores 2*10c / 256 GB
— 10 servidores 2*18c / 512 GB
A escolha entre essas configurações deve ser feita com base em fatores adicionais, como o pacote térmico e o resfriamento disponível, servidores já utilizados ou custos.
Características da escolha da configuração do servidor
Máquinas Virtuais Amplas. Quando for necessário hospedar VMs amplas (comparáveis a 1 nó NUMA ou mais), é recomendável escolher um servidor com uma configuração que permita a essas VMs permanecer dentro do nó NUMA. Com um grande número de VMs amplas, há um risco de fragmentação dos recursos do cluster, e, neste caso, devem ser escolhidos servidores que permitam acomodar as VMs amplas o mais densamente possível.
Tamanho do domínio de falha unitária.
A escolha do tamanho do servidor também é feita com base no princípio de minimizar o domínio de falha unitária. Por exemplo, ao escolher entre:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
Com outras condições iguais, deve-se escolher a segunda opção, pois ao falhar um servidor (ou durante a manutenção), não se perde 33% dos recursos do cluster, mas 17%. Da mesma forma, o número de VMs e sistemas impactados pela falha é reduzido pela metade.
Cálculo de armazenamento clássico por desempenho
O armazenamento clássico é sempre calculado com base no pior cenário, excluindo o impacto do cache em disco e a otimização das operações.
Como métricas básicas de desempenho, consideramos o desempenho mecânico do disco (IOPSdisk):
— 7.2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
Em seguida, a quantidade de discos no pool é calculada pela seguinte fórmula: = TotalIOPS * ( RW + (1 –RW) * RAIDPen) / IOPSdisk. Onde:
— TotalIOPS – a performance total requerida em IOPS do pool de discos
— RW – a porcentagem de operações de leitura
— RAIDpen – penalidade RAID para o nível RAID escolhido
Mais informações sobre dispositivos RAID e RAID Penalty podem ser encontradas aqui — e e
Com base no número de discos obtido, são calculadas as opções possíveis que atendem aos requisitos de capacidade de armazenamento, incluindo opções com armazenamento em múltiplos níveis.
O cálculo de sistemas usando SSD como nível de armazenamento é tratado separadamente.
Características do cálculo de sistemas com Flash Cache
Flash Cache – um termo genérico para todas as tecnologias proprietárias que utilizam memória flash como cache de segundo nível. Ao usar o cache flash, o armazenamento é geralmente calculado para atender à carga estabelecida a partir de discos magnéticos, enquanto a carga de pico é atendida pelo cache.
É necessário entender o perfil da carga e o grau de localização dos acessos aos blocos dos volumes de armazenamento. O Flash Cache é uma tecnologia para cargas com alta localização de solicitações e é praticamente inaplicável a volumes com carga uniforme (como em sistemas de análise).
Cálculo de sistemas híbridos low-end / mid-range
Os sistemas híbridos de baixo e médio custo usam armazenamento em múltiplos níveis com movimentação de dados entre níveis em agenda. Neste caso, o tamanho do bloco de armazenamento em múltiplos níveis nos melhores modelos é de 256 MB. Essas características não permitem considerar a tecnologia de armazenamento em múltiplos níveis como uma tecnologia de aumento de desempenho, como muitas vezes é erroneamente considerada. O armazenamento em múltiplos níveis em sistemas de baixo e médio custo é uma tecnologia de otimização de custo de armazenamento para sistemas com carga desigual.
Para armazenamento em múltiplos níveis, a performance do nível superior é priorizada, enquanto o nível inferior é considerado apenas como um complemento à capacidade de armazenamento. Para um sistema híbrido de múltiplos níveis, o uso de tecnologia de cache flash é essencial para compensar a queda de desempenho de dados de baixo nível que ficam temporariamente ativos.
Uso de SSD em um pool de discos de múltiplos níveis
O uso de SSD em um pool de discos de múltiplos níveis varia conforme as particularidades da implementação dos algoritmos de cache flash deste fornecedor.
A prática comum de política de armazenamento para um pool de discos com nível SSD é SSD first.
Cache Flash Somente para Leitura. Para um cache flash de somente leitura, o nível de armazenamento em SSD é ativado quando há uma significativa localização das operações de escrita, independentemente do cache.
Cache Flash Leitura / Escrita. No caso de um cache flash para escrita, primeiro define-se o tamanho máximo do cache, e o nível de armazenamento em SSD surge apenas quando não há espaço suficiente no cache para atender a toda a carga localizada.
O cálculo do desempenho de SSD e cache é sempre realizado com base nas recomendações do fabricante, mas sempre levando em consideração o pior cenário.
Fonte: habr.com
