

O CDS acabou, mas o desejo incontrolável de escrever permanece.
Durante muitos anos, nosso irmão sofreu com o trabalho rotineiro, cruzando os dedos antes do commit e perdendo sono por causa de rollbacks noturnos.
Mas os tempos sombrios chegam ao fim.
Com este artigo, começarei uma série sobre como saber. Espero que este artigo tenha ajudado você em seus negócios. Quero acreditar que, ao lê-lo, você aprendeu tanto quanto eu aprendi enquanto lidava com tudo o que descrevi. a automação é vista.
Ao longo do caminho, abordaremos as etapas da automação, o armazenamento de variáveis, a formalização do design, com RestAPI, NETCONF, YANG, YDK e programaremos extensivamente.
Para mim, significa que a) não é uma verdade objetiva, b) não é a melhor abordagem incondicionalmente, c) meu ponto de vista pode até mudar ao longo do progresso da série, para ser honesto, desde o rascunho até a publicação, eu reescrevi tudo completamente duas vezes.
Conteúdo
- Objetivos
- A rede é como um organismo único
- Testando a configuração
- Versionamento
- Monitoramento e autorrecuperação de serviços
- Ferramentas
- Sistema de inventário
- Sistema de gerenciamento de espaço de IP
- Sistema de descrição de serviços de rede
- Mecanismo de inicialização de dispositivos
- Modelo de configuração agnóstico ao fornecedor
- Driver específico para Interface de fornecedor
- Mecanismo de entrega de configuração para o dispositivo
- CI/CD
- Mecanismo de backup e busca de desvios
- Sistema de monitoramento
- Conclusão
Tentarei conduzir o ADS em um formato um pouco diferente do CDS. A perspectiva ainda terá grandes artigos numerados, e entre eles publicarei pequenas notas da experiência cotidiana. Vou lutar contra o perfeccionismo e não polir todas elas.
É curioso como, pela segunda vez, temos que percorrer o mesmo caminho.
No início, tive que escrever os artigos sobre redes porque não haviam nenhum disponível na internet russa.
Agora, não consegui encontrar um documento abrangente que sistematizasse as abordagens de automação e analisasse as tecnologias mencionadas com exemplos práticos simples.
Pode ser que eu esteja errado, então, deixem links para recursos bons. No entanto, isso não alterará minha determinação de escrever, porque o objetivo principal é aprender algo para mim mesmo, e facilitar a vida do próximo é um bom bônus que agrada à propagação de conhecimento.
Tentaremos pegar um data center de tamanho médio, o LAN DC, e trabalhar em todo o esquema de automação.
Farei algumas coisas praticamente pela primeira vez junto com vocês.
Nas ideias e ferramentas descritas aqui, não serei original. Dmitry Figol tem um excelente .
Os artigos, em muitos aspectos, vão se sobrepor a eles.
No LAN DC, há 4 DCs, cerca de 250 switches, meia dúzia de roteadores e alguns firewalls.
Não é o Facebook, mas é suficiente para refletir profundamente sobre automação.
No entanto, há uma opinião de que se você tem mais de 1 dispositivo, a automação já é necessária.
Na verdade, é difícil imaginar que alguém hoje possa viver sem pelo menos um punhado de scripts de automação.
Embora eu tenha ouvido que existem empresas onde o controle de endereços IP é feito em uma planilha, e cada um dos milhares de dispositivos de rede é configurado manualmente, tendo sua própria configuração única. Isso, é claro, pode ser considerado arte moderna, mas os sentimentos dos engenheiros certamente serão ofendidos.
Objetivos
Agora, vamos estabelecer metas o mais abstratas possível:
- A rede é como um organismo único
- Testando a configuração
- Versionamento do estado da rede.
- Monitoramento e autorrecuperação de serviços
Mais adiante neste artigo, vamos discutir quais ferramentas usaremos, e em artigos subsequentes, detalharemos tanto as metas quanto os meios.
A rede é como um organismo único
A frase definidora do ciclo, embora à primeira vista possa parecer insignificante: vamos configurar a rede, e não dispositivos individuais..
Nos últimos anos, temos observado uma mudança de foco para tratar a rede como uma única entidade, daí vêm os Redes Definidas por Software, Redes Orientadas por Intenção e Redes Autônomas.
Pois o que os aplicativos realmente precisam da rede: conectividade entre os pontos A e B (e às vezes +B-J) e isolamento de outros aplicativos e usuários.
Assim, nossa tarefa nesta série é estabelecer um sistema, que suporte a configuração atual de toda a rede, que já se decompõe na configuração atual de cada dispositivo, de acordo com seu papel e localização.
Sistema a gestão da rede implica que, para fazer mudanças, precisamos interagir com ela, e ela, por sua vez, calcula o estado necessário para cada dispositivo e o configura.
Desse modo, minimizamos quase a zero o uso do CLI manualmente — quaisquer alterações nas configurações dos dispositivos ou no design da rede devem ser formalizadas e documentadas — e só depois implementadas nos elementos relevantes da rede.
Ou seja, por exemplo, se decidirmos que, a partir deste momento, os switches de rack em Kazan devem anunciar duas redes em vez de uma, nós
- Primeiro, documentamos as alterações nos sistemas
- Geramos a configuração de destino de todos os dispositivos da rede
- Executamos o programa de atualização da configuração da rede, que calcula o que precisa ser removido em cada nó, o que adicionar e leva os nós ao estado desejado.
Nesse ínterim, fazemos alterações manualmente apenas no primeiro passo.
Testando a configuração
, que 80% dos problemas ocorrem durante a alteração da configuração — um indício disso é que, durante as férias de Natal, normalmente tudo fica tranquilo.
Eu pessoalmente testemunhei dezenas de quedas globais devido a erros humanos: comando errado, execução na configuração errada, esquecimento da comunidade, remoção global do MPLS no roteador, configuração de cinco dispositivos, e no sexto não notamos o erro, cometemos alterações antigas feitas por outra pessoa. Há uma infinidade de cenários.
A automação nos permitirá cometer menos erros, mas em uma escala maior. Assim, podemos travar não apenas um dispositivo, mas toda a rede de uma vez.
Desde tempos imemoriais, nossos ancestrais verificavam a precisão das alterações feitas com um olhar atento, coragem e a funcionalidade da rede após sua implementação.
Aqueles ancestrais cujos trabalhos resultavam em paralisações e perdas catastróficas deixavam menos descendentes e deveriam, ao longo do tempo, desaparecer, mas a evolução é um processo lento, e ainda hoje nem todos verificam previamente as alterações em um laboratório.
No entanto, na vanguarda do progresso estão aqueles que automatizaram o processo de teste de configuração e sua aplicação subsequente na rede. Em outras palavras — tomaram emprestado o procedimento CI/CD () dos desenvolvedores.
Em uma das partes, veremos como implementar isso com um sistema de controle de versão, possivelmente o GitHub.
Assim que você se acostumar com a ideia de CI/CD para redes, de repente, o método de verificar a configuração através de sua aplicação na rede de trabalho parecerá uma ignorância da Idade Média. Algo como bater com um martelo em uma ogiva.
Uma continuação orgânica das ideias sobre o sistema de gerenciamento de rede e CI/CD torna-se a versionamento completo da configuração.
Versionamento
Vamos considerar que, com qualquer alteração, até mesmo as mais pequenas, mesmo em um dispositivo imperceptível, toda a rede passa de um estado a outro.
E nunca executamos o comando em um dispositivo, mudamos o estado da rede.
Vamos chamar esses estados de versões?
Suponha que a versão atual seja 1.0.0.
Mudou o endereço IP da interface Loopback em um dos ToR? Isso é uma versão menor — receberá o número 1.0.1.
Revisamos as políticas de importação de rotas no BGP — um pouco mais sério — já é 1.1.0.
Decidimos eliminar o IGP e passar apenas para BGP — isso já é uma mudança radical de design — 2.0.0.
Ao mesmo tempo, diferentes DCs podem ter versões diferentes — a rede evolui, novos equipamentos são instalados, novos níveis de spine são adicionados em alguns lugares, enquanto em outros não, etc.
Sobre vamos falar sobre isso em um artigo separado.
Reitero — qualquer mudança (exceto comandos de depuração) é uma atualização de versão. Os administradores devem ser notificados sobre qualquer desvio da versão atual.
O mesmo se aplica ao rollback de mudanças — isso não é a anulação dos últimos comandos, não é um rollback realizado pelo sistema operacional do dispositivo — é trazer toda a rede para uma nova (ou antiga) versão.
Monitoramento e autorrecuperação de serviços
Essa é uma tarefa evidente que, nas redes modernas, atinge um novo nível.
Frequentemente, grandes provedores de serviços adotam a abordagem de que um serviço que falha deve ser rapidamente encerrado e um novo deve ser iniciado, em vez de investigar o que ocorreu.
«Muito» significa que é preciso estar fortemente coberto por sistemas de monitoramento, que conseguem detectar até as menores anomalias em segundos.
E aqui já não é suficiente as métricas habituais, como carga da interface ou disponibilidade do nó. O monitoramento manual por parte do operador também não é suficiente.
Para muitas coisas, deve haver um — os monitoramentos acenderam em vermelho e foram sozinhos cuidar do que estava doendo.
E aqui também monitoramos não só dispositivos individuais, mas a saúde da rede como um todo, tanto como um whitebox, que é relativamente claro, quanto como um blackbox, que é mais complicado.
O que precisamos para implementar esses planos ambiciosos?
- Ter uma lista de todos os dispositivos na rede, sua localização, funções, modelos, versões de software.
kazan-leaf-1.lmu.net, Kazan, leaf, Juniper QFX 5120, R18.3. - Ter um sistema de descrição de serviços de rede.
IGP, BGP, L2/3VPN, Política, ACL, NTP, SSH. - Ser capaz de inicializar o dispositivo.
Hostname, IP de gerenciamento, rota de gerenciamento, usuários, chaves RSA, LLDP, NETCONF - Configurar o dispositivo e trazer a configuração para a versão desejada (incluindo uma versão anterior).
- Testar a configuração
- Verificar periodicamente o estado de todos os dispositivos quanto a desvio do status atual e informar a quem for pertinente.
À noite, alguém silenciosamente adicionou uma regra no ACL. - Monitorar a funcionalidade.
Ferramentas
Parece suficientemente complicado para começar a decompor o projeto em componentes.
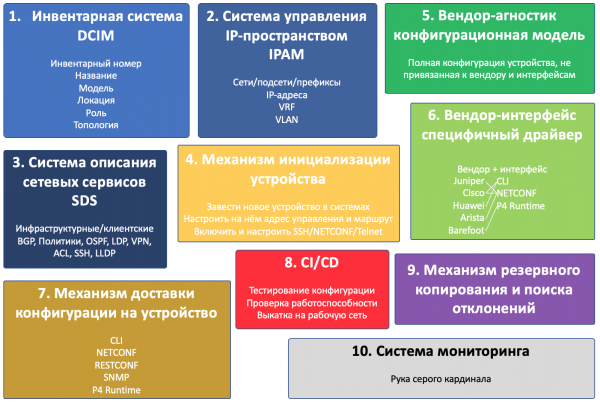
E serão dez:
- Sistema de inventário
- Sistema de gerenciamento de espaço de IP
- Sistema de descrição de serviços de rede
- Mecanismo de inicialização de dispositivos
- Modelo de configuração agnóstico ao fornecedor
- Driver específico para Interface de fornecedor
- Mecanismo de entrega de configuração para o dispositivo
- CI/CD
- Mecanismo de backup e busca de desvios
- Sistema de monitoramento
Este, aliás, é um exemplo de como a perspectiva sobre os objetivos do ciclo mudou – no rascunho dos componentes havia 4.
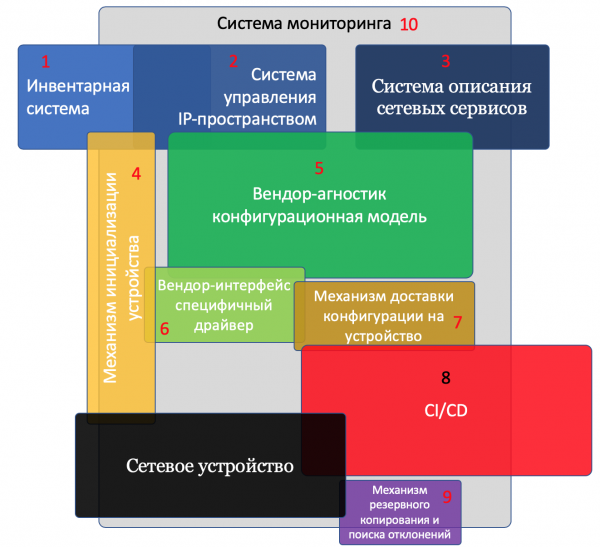
Na ilustração, eu representei todos os componentes e o dispositivo propriamente dito.
Componentes interconectados interagem uns com os outros.
Quanto maior o bloco, mais atenção precisa ser dada a esse componente.
Componente 1. Sistema de inventário
Obviamente, queremos saber qual equipamento está onde e a que está conectado.
O sistema de inventário é uma parte essencial de qualquer empresa.
Na maioria das vezes, para dispositivos de rede, a empresa possui um sistema de inventário separado que resolve tarefas mais específicas.
No âmbito do ciclo de artigos, nos referiremos a isso como DCIM – Gestão de Infraestrutura de Data Center. Embora o próprio termo DCIM, estritamente falando, inclua muito mais.
Para nossas tarefas nele, armazenaremos as seguintes informações sobre o dispositivo:
- Número de inventário
- Nome/descrição
- Modelo (Huawei CE12800, Juniper QFX5120, etc.)
- Parâmetros característicos (placas, interfaces, etc.)
- Função (Leaf, Spine, Border Router, etc.)
- Localização (região, cidade, data center, rack, unidade)
- Interconexões entre dispositivos
- Topologia da rede
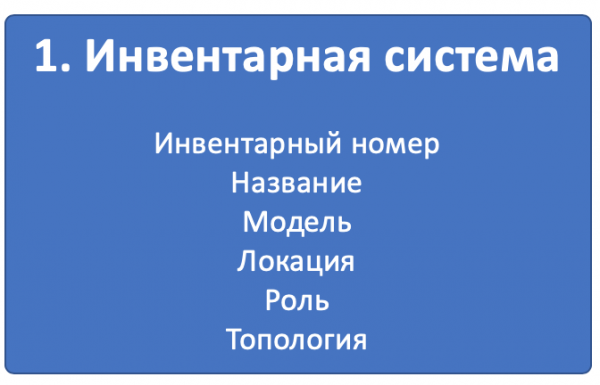
É perfeitamente claro que queremos saber tudo isso.
Mas isso ajudará nos objetivos de automação?
Certamente.
Por exemplo, sabemos que neste data center, em switches Leaf, se for Huawei, as ACL para filtrar determinado tráfego devem ser aplicadas na VLAN, e se for Juniper – então na unidade 0 da interface física.
Ou precisamos implementar um novo servidor Syslog em todos os bordas da região.
Nele também armazenaremos dispositivos de rede virtuais, como roteadores virtuais ou route reflectors. Podemos adicionar servidores DNS, NTP, Syslog e tudo que de alguma forma se relacione à rede.
Componente 2. Sistema de gestão de espaço de IP
Sim, ainda hoje existem grupos de pessoas que mantêm um registro de prefixos e endereços IP em um arquivo Excel. Mas a abordagem moderna é realmente um banco de dados, com frontend em nginx/apache, API e amplas funcionalidades para gestão de endereços e redes IP, com separação por VRF.
IPAM — Gestão de Endereços IP.
Para nossas necessidades, iremos armazenar as seguintes informações:
- VLAN
- VRF
- Redes/Subredes
- endereços IP
- Vinculação de endereços a dispositivos, redes a locais e números VLAN
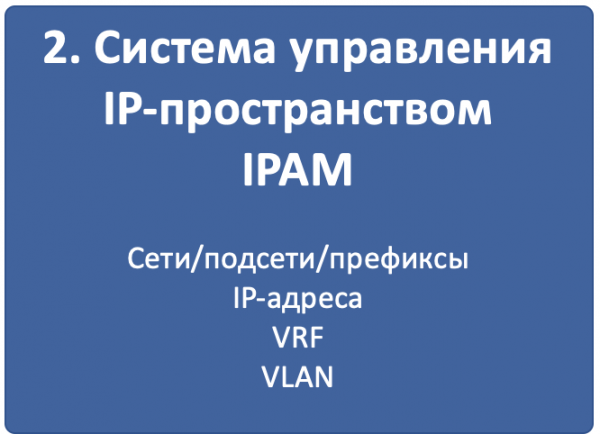
Novamente, é claro que queremos ter certeza de que, ao atribuir um novo endereço IP para o loopback do ToR, não iremos nos deparar com o fato de que ele já foi designado a alguém. Ou que o mesmo prefixo foi usado duas vezes em diferentes partes da rede.
Mas como isso ajudará na automação?
Fácil.
Solicitamos à sistema um prefixo com a função de Loopbacks, onde existem endereços IP disponíveis para alocação — se encontrado, alocamos o endereço; se não, pedimos a criação de um novo prefixo.
Ou ao criar a configuração do dispositivo, podemos descobrir através deste mesmo sistema em qual VRF o interface deve estar.
E ao iniciar um novo servidor, o script irá consultar o sistema, descobrir em qual switch do servidor, em qual porta e qual sub-rede está designada ao interface — a partir dele, será alocado o endereço do servidor.
Surge o desejo de unir DCIM e IPAM em um único sistema, para não duplicar funções e não gerenciar duas entidades semelhantes.
E assim faremos.
Componente 3. Sistema de descrição de serviços de rede
Enquanto os dois primeiros sistemas armazenam variáveis que ainda precisam ser utilizadas de alguma forma, o terceiro descreve para cada função do dispositivo como deve ser configurado.
Vale ressaltar dois tipos diferentes de serviços de rede:
- Serviços de infraestrutura
- Serviços de cliente.
Os primeiros são destinados a assegurar a conectividade básica e a gestão do dispositivo. Aqui podemos incluir VTY, SNMP, NTP, Syslog, AAA, protocolos de roteamento, CoPP, etc.
Os segundos organizam um serviço para o cliente: MPLS L2/L3VPN, GRE, VXLAN, VLAN, L2TP, etc.
Obviamente, há também casos limites — como classificar MPLS LDP, BGP? E os protocolos de roteamento podem ser utilizados para clientes. Mas isso não é fundamental.
Ambos os tipos de serviços se desdobram em primitivas de configuração:
- interfaces físicas e lógicas (tag/ante-tag, mtu)
- endereços IP e VRF (IP, IPv6, VRF)
- ACLs e políticas de tratamento de tráfego
- protocolos (IGP, BGP, MPLS)
- políticas de roteamento (listas de prefixos, comunidades, filtros ASN).
- Serviços auxiliares (SSH, NTP, LLDP, Syslog…)
- Etc.
Ainda não sei como exatamente vamos fazer isso. Vamos abordar em um artigo separado.
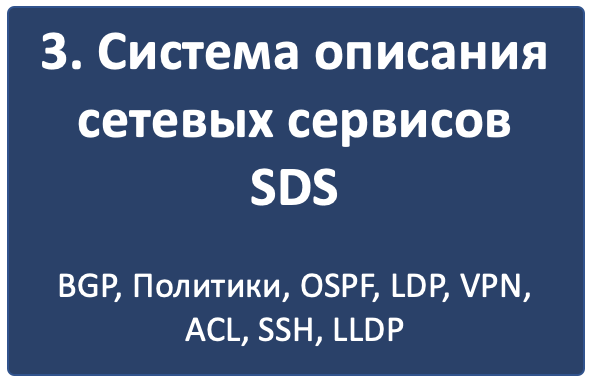
Se voltarmos um pouco para a realidade, poderíamos descrever que
O switch Leaf deve ter sessões BGP com todos os switches Spine conectados, importar para o processo as redes conectadas, e aceitar dos switches Spine apenas redes de um prefixo específico. Restringir CoPP IPv6 ND a 10 pps etc.
Os switches Spine, por sua vez, mantêm sessões com todos os switches Leaf conectados, atuando como refletores raiz, e aceitam deles apenas rotas de determinado comprimento e com certas comunidades.
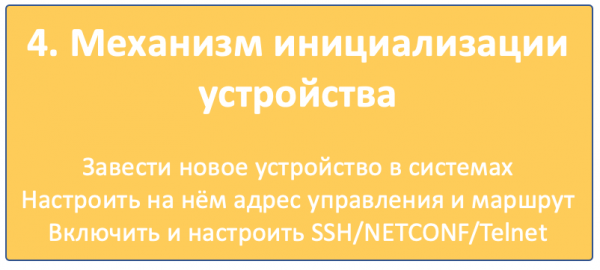
Componente 4. Mecanismo de inicialização do dispositivo
Sob este título, agrupo uma série de ações que precisam acontecer para que o dispositivo apareça nos radares e possa ser acessado remotamente.
- Registrar o dispositivo no sistema de inventário.
- Alocar um endereço IP de gerenciamento.
- Configurar o acesso básico para ele:
Hostname, endereço IP de gerenciamento, rota para a rede de gerenciamento, usuários, chaves SSH, protocolos — telnet/SSH/NETCONF
Aqui existem três abordagens:
- Tudo manualmente. O dispositivo é levado ao estande, onde um ser humano comum o registrará nos sistemas, conectará pelo console e o configurará. Pode funcionar em pequenas redes estáticas.
- ZTP — Zero Touch Provisioning. O hardware chegou, se posicionou, obteve um endereço via DHCP, consultou um servidor específico e se configurou automaticamente.
- Infraestrutura de servidores de console, onde a configuração inicial ocorre através da porta de console em modo automático.
Vamos discutir os três em um artigo separado.
Componente 5. Modelo de configuração independente do fornecedor
Até agora, todos os sistemas eram fragmentos díspares que forneciam descrições variáveis e declarativas do que gostaríamos de ver na rede. Mas cedo ou tarde, teremos que lidar com a concretude.
Neste estágio, para cada dispositivo específico, primitivos, serviços e variáveis são combinados em um modelo de configuração, que descreve efetivamente a configuração completa de um dispositivo específico, apenas de uma maneira independente de fornecedor.
O que esse passo oferece? Por que não criar imediatamente a configuração do dispositivo, que pode ser simplesmente carregada?
Na verdade, isso permite resolver três tarefas:
- Não se adaptar a uma interface de interação específica com o dispositivo. Seja CLI, NETCONF, RESTCONF, SNMP — o modelo será o mesmo.
- Não manter o número de templates/script pelo número de fornecedores na rede, e caso haja uma mudança no design, alterar a mesma coisa em vários lugares.
- Carregar a configuração do dispositivo (backup), organizá-la em um modelo exatamente igual e diretamente comparar a configuração alvo e a existente para calcular a delta e preparar um patch de configuração, que mudará apenas as partes que são necessárias ou para identificar desvios.
Como resultado desta etapa, obtemos uma configuração independente de fornecedor.
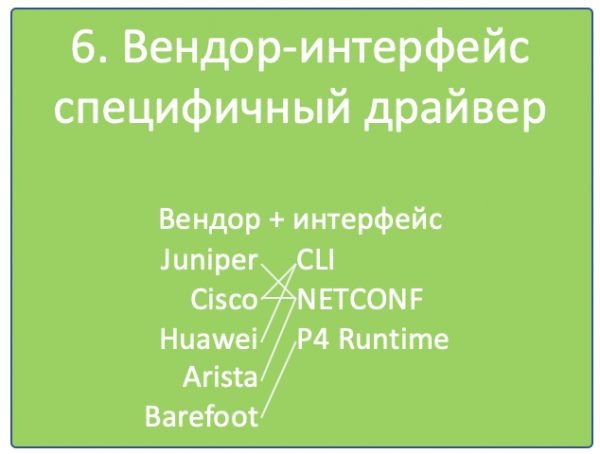
Componente 6. Driver específico de interface de fornecedor.
Não se deve alimentar esperanças de que um dia configurar uma Cisco será exatamente como uma Juniper, simplesmente enviando chamadas absolutamente iguais para elas. Apesar do aumento na popularidade dos whiteboxes e do surgimento de suporte para NETCONF, RESTCONF, OpenConfig, o conteúdo específico que é entregue por esses protocolos difere de fornecedor para fornecedor, e essa é uma de suas diferenças competitivas que eles não desistirão facilmente.
Isso é mais ou menos como OpenContrail e OpenStack, que têm RestAPI como sua interface northbound, mas esperam chamadas completamente diferentes.
Portanto, no quinto passo, o modelo independente de fornecedor deve assumir a forma em que irá para o hardware.
E aqui todos os meios são válidos (na verdade, não): CLI, NETCONF, RESTCONF, SNMP são todos válidos.
Portanto, precisaremos de um driver que traduza o resultado do passo anterior para o formato necessário de um fornecedor específico: um conjunto de comandos CLI, uma estrutura XML.
Componente 7. Mecanismo de entrega da configuração para o dispositivo.
A configuração foi gerada, mas ainda precisa ser entregue aos dispositivos — e, obviamente, não manualmente.
Primeiro, surge a questão de qual transporte vamos utilizar? E a escolha hoje já não é pequena:
- CLI (telnet, ssh)
- SNMP
- NETCONF
- RESTCONF
- REST API
- OpenFlow (embora ele se destaque na lista, pois é uma forma de entregar FIB e não configurações)
Vamos aqui colocar os pontos sobre as letras. CLI — é legado. SNMP… ahem.
RESTCONF — ainda é uma criatura desconhecida, REST API quase ninguém suporta. Portanto, vamos nos concentrar em NETCONF no ciclo.
Na verdade, como já percebeu o leitor, com a interface já estamos decididos neste ponto — o resultado da etapa anterior já está apresentado no formato da interface escolhida.
Em segundo lugar, e quais ferramentas usaremos para isso?
Aqui também há uma grande escolha:
- Um script feito sob medida ou uma plataforma. Vamos nos armar com ncclient e asyncIO e fazer tudo nós mesmos. O que nos custa construir um sistema de deployment do zero?
- Ansible com sua rica biblioteca de módulos de rede.
- Salt com sua escassa funcionalidade em redes e ligação com Napalm.
- Próprio Napalm, que conhece alguns vendors e tudo, até logo.
- Nornir — mais uma fera que vamos dissecar no futuro.
Aqui também o favorito ainda não foi escolhido — vamos explorar.
O que mais é importante aqui? As consequências da aplicação da configuração.
Se é bem-sucedido ou não. Se o acesso ao hardware permanece ou não.
Parece que aqui vai ajudar um commit com confirmação e validação do que foi carregado no dispositivo.
Isso, em conjunto com a implementação adequada do NETCONF, reduz significativamente o número de dispositivos compatíveis — commits normais não são suportados por muitos fabricantes. Mas isso é apenas uma das condições obrigatórias na . Afinal, ninguém se preocupa que nenhum vendor russo passará sob a condição de 32*100GE de interface. Ou se preocupa?
Componente 8. CI/CD
Neste ponto, já temos a configuração para todos os dispositivos da rede.
Estou escrevendo "para todos", porque estamos falando sobre versionamento do estado da rede. E mesmo que seja necessário mudar as configurações de apenas um switch, as alterações são calculadas para toda a rede. Obviamente, elas podem ser nulas para a maioria dos nós.
Mas, como já mencionado acima, não somos uns bárbaros para implementar tudo de uma vez em produção.
A configuração gerada deve passar primeiro pelo Pipeline CI/CD.
CI/CD significa Integração Contínua, Deployment Contínuo. É uma abordagem na qual a equipe não lança um novo release major a cada seis meses, substituindo completamente o antigo, mas implementa regularmente, de forma incremental (Deployment), novas funcionalidades em pequenas parcelas, cada uma das quais é testada minuciosamente quanto à compatibilidade, segurança e funcionamento (Integração).
Para isso, temos um sistema de controle de versão que acompanha as alterações de configuração, um laboratório que verifica se o serviço do cliente não apresenta falhas, um sistema de monitoramento que confirma isso e, por fim, o último passo — a implementação das alterações na rede operacional.
Exceto para comandos de depuração, todas as mudanças na rede devem passar pelo CI/CD Pipeline — essa é a nossa garantia de uma vida tranquila e uma carreira longa e bem-sucedida.
Componente 9. Sistema de backup e detecção de desvios
Não é necessário falar repetidamente sobre backups.
Vamos apenas armazená-los por cron ou quando houver uma alteração na configuração no Git.
A segunda parte é mais interessante — alguém deve monitorar esses backups. Em alguns casos, essa pessoa deve reverter tudo como estava, e em outros, avisar alguém sobre um problema.
Por exemplo, se um novo usuário aparecer que não está listado nas variáveis, deve-se removê-lo para evitar problemas. E se uma nova regra de firewall surgir — é melhor não mexer, talvez alguém apenas tenha ativado o modo de depuração, ou pode ser que um novo serviço tenha sido mal configurado e já esteja sendo utilizado pelas pessoas.
Em relação a uma pequena delta em termos de toda a rede, não conseguiremos evitar isso, independentemente dos sistemas de automação e da mão firme da gestão. Para a depuração de problemas, ninguém fará modificações nas configurações nos sistemas. Especialmente considerando que a própria modelagem de configuração pode não prever tais mudanças.
Por exemplo, uma regra de firewall para contar o número de pacotes em um determinado IP, para localização de problemas — é uma configuração temporária bastante comum.
Componente 10. Sistema de monitoramento
Inicialmente, eu não planejava abordar o tema de monitoramento — é um assunto extenso, polêmico e complexo. Mas, ao longo do processo, ficou claro que é uma parte integrante da automação. E não podemos ignorá-lo, mesmo sem prática.
Desenvolvendo o pensamento — isso é uma parte orgânica do processo CI/CD. Após a implementação da configuração na rede, precisamos ser capazes de determinar se tudo está em ordem.
E não se trata apenas de gráficos de uso das interfaces ou da disponibilidade dos nós, mas sim de questões mais sutis — a existência de rotas necessárias, os atributos dessas rotas, o número de sessões BGP, vizinhos OSPF, a operabilidade de ponta a ponta dos serviços subjacentes.
As logs are not being written to the external server, has the SFlow agent malfunctioned, have drops in queues started to increase, or has connectivity between any pair of prefixes been disrupted?
In a separate article, we will reflect on this as well.
Conclusão
As a basis, I chose one of the modern data center network designs — L3 Clos Fabric with BGP as the routing protocol.
This time, we will build the network on Juniper, because now the JunOs interface is something special.
We'll complicate our lives by using only Open Source tools and a multi-vendor network — so in addition to Juniper, I will choose another lucky player along the way.
The plan for the upcoming publications is approximately as follows:
First, I will talk about virtual networks. Primarily because I want to, and second, because without this, the design of the infrastructure network will not be very clear.
Then, about the network design itself: topology, routing, policies.
We will assemble a laboratory setup.
We will reflect and maybe practice initializing a device in the network.
And then about each component in intimate detail.
And yes, I do not promise to elegantly conclude this cycle with a ready solution. 🙂
Links Úteis
- Before diving into the series, it is worth reading Natasha Samoylenko's book Oh, and perhaps take a .
- It would also be useful to read on the design of data center fabrics from Facebook authored by Petr Lapukhov.
- Documentation on the architecture for how Overlay SDN works will give you an idea (formerly Open Contrail).
Obrigado
Roman Gorgé. For comments and edits.
Artyom Chernobay. For KDPV.
Fonte: habr.com
