

Hoje, na infraestrutura de TI, com o uso generalizado da virtualização, os sistemas de armazenamento de dados são o núcleo que armazena todas as máquinas virtuais. A falha deste nó pode interromper completamente a operação do centro de computação. Embora uma parte considerável do hardware do servidor tenha algum tipo de resistência a falhas 'por padrão', devido ao papel especial do armazenamento de dados nos data centers, há exigências mais elevadas quanto à sua 'resiliência'.
O método mais eficaz de garantir a resiliência em TI é o uso de várias instâncias de hardware e software (no seu nível mais simples, duplicação). Claro, o armazenamento de dados pode ser completamente duplicado. Para recuperação de desastres, esse é exatamente o tipo de abordagem que é utilizada. No entanto, essa solução não é viável para todas as empresas. Não se trata apenas do custo dobrado do hardware, mas também de outros custos associados à organização desta solução e ao seu suporte futuro.
No entanto, a possibilidade de duplicar o hardware não elimina a necessidade de garantir a resiliência no nível dos componentes. Em particular, nos sistemas de armazenamento de dados, a redundância é aplicada a unidades de alimentação, módulos de resfriamento, dispositivos de armazenamento e, claro, controladores. Tudo isso já se tornou uma norma há muito tempo. É difícil encontrar um sistema de armazenamento de dados sem esse tipo de design. Aqui não é uma exceção. Mas sobre o que queremos discutir neste artigo são os aspectos que não são imediatamente visíveis e que são principalmente voltados para aumentar a resiliência do sistema como um todo.
Módulos de resfriamento
Muito frequentemente, em com caixas de 2U-3U, são utilizados módulos combinados que reúnem unidades de alimentação e ventiladores. Por um lado, isso é conveniente, pois é necessário apenas realizar a manutenção de um único bloco. Por outro lado, se o sistema de resfriamento falhar, a unidade de alimentação pode ser desligada para evitar superaquecimento. Embora isso não pareça uma situação crítica, claramente não vale a pena adicionar vulnerabilidades ao sistema de armazenamento de dados.
O resfriamento no armazenamento Qsan é organizado em módulos separados com substituição a quente, independentes das fontes de alimentação. Cada bloco de alimentação possui seus próprios ventiladores, destinados a resfriar os próprios blocos de potência. O módulo de resfriamento contém dois ventiladores independentes que se protegem mutuamente. Existem dois desses módulos no armazenamento: à direita e à esquerda – para uma ventilação eficaz de todos os componentes. Se um dos ventiladores falhar, os demais automaticamente aumentam sua rotação para compensar a falta de fluxo de ar formada. Por isso, uma falha de ventilador não representa um risco de superaquecimento para todo o dispositivo.
Topologia de conexão dos racks de expansão
O esquema clássico de conexão ao armazenamento se refere a uma topologia chamada cascata. Nesse caso, os controladores do rack e do armazenamento estão conectados entre si por um único cabo SAS. Isso resulta em 2 cabos para um sistema com dois controladores. Se for necessário conectar um segundo, ele é conectado da mesma forma ao primeiro rack. E assim por diante. O ponto positivo dessa topologia é a simplicidade de implementação no hardware. O ponto negativo é a vulnerabilidade em relação a uma interrupção repentina da cadeia SAS devido à falha cruzada entre controladores desconectados entre si e racks, ou devido ao corte de energia de um dos racks de expansão no meio da cadeia. O resultado será a perda de acesso a parte dos dispositivos e possível desagregação do grupo RAID, se ele estiver "espalhado" por vários chassis.
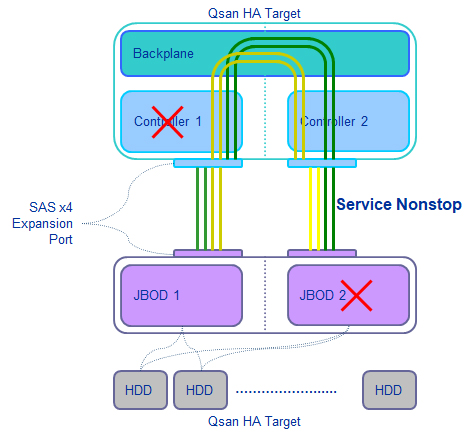
Para proteger contra a falha cruzada dos controladores, a Qsan possui uma proteção na forma de uma conexão lógica interna entre os controladores através do backplane do armazenamento. Ou seja, o controlador do armazenamento vê não apenas o controlador JBOD, diretamente conectado a ele, mas também o controlador "vizinho" através de um link especial no backplane. Como resultado, se acontecer uma situação assim e ninguém puxar fisicamente os cabos SAS entre o armazenamento e o rack, o acesso a todos os dispositivos será mantido.
Para proteger contra a quebra da cadeia SAS, por exemplo, devido ao corte de energia do rack de expansão, geralmente é utilizada uma outra topologia de conexão – cascata reversa. Nesse caso, o armazenamento é conectado imediatamente ao primeiro e ao último rack na cadeia, obtendo acesso aos dispositivos de ambos os lados.
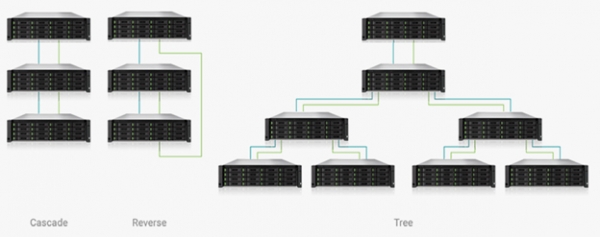
Se você deseja uma proteção mais robusta, é possível criar configurações mais complexas, utilizando, por exemplo, uma topologia em árvore. Ou ainda complicar mais com a combinação das topologias mencionadas. Isso é viável devido ao grande número de conectores SAS nos dispositivos (2 em cada controlador de armazenamento e 5 em cada controlador de JBOD) com detecção automática dos modos de operação. O principal é que o próprio administrador não se confunda. E a solução de armazenamento saberá como configurar corretamente a configuração.
Rebuild rápido
A presença de discos reserva de substituição a quente (hot spare) no sistema aumenta significativamente a confiabilidade do armazenamento de informações. No entanto, o simples fato de designar esses discos não garante proteção absoluta. Isso porque o processo de recuperação (rebuild) é bastante trabalhoso e muitas vezes prolongado. O esforço é causado pelo acesso contínuo aos dados principais. Ou seja, o sistema, além de realizar suas funções atuais, também deve copiar os dados para o novo disco. E a duração do rebuild depende diretamente da capacidade do dispositivo e de suas características de velocidade. Como o sistema não tem conhecimento do espaço realmente ocupado nos discos, durante o rebuild ele copia tudo: bloco por bloco.
Como resultado, a recuperação de um disco moderno com grande capacidade acima de 10 TB sob uma carga significativa no armazenamento pode levar facilmente uma semana ou mais. Também é importante considerar que, durante o rebuild, a probabilidade de falha de outros dispositivos aumenta devido à carga adicional sobre eles. Isso já pode representar um sério perigo em caso de uso, por exemplo, de RAID5.
Como solução para esse problema, muitos desenvolvedores de armazenamento se preocuparam em acelerar o processo de recuperação. Para isso, diferentes abordagens podem ser aplicadas, mas a essência é uma – a cópia durante o rebuild apenas dos blocos realmente ocupados. A Qsan também se importou com esse problema. No armazenamento desse fornecedor, com a opção ativada, o sistema monitora os blocos utilizados para gravação, permitindo que, em caso de falha de um disco, copie apenas esses para o novo dispositivo.
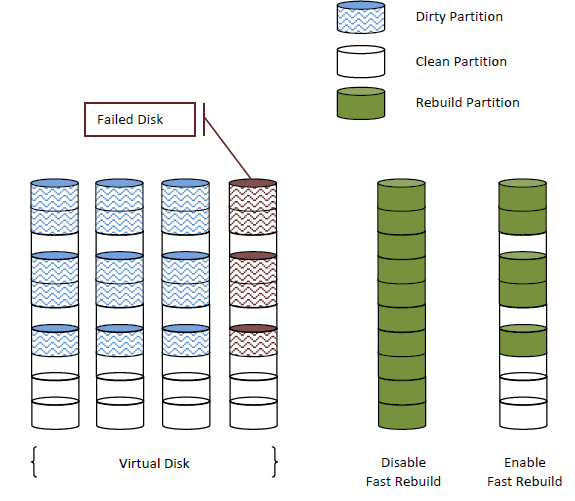
A opção Fast Rebuild não está ativada por padrão ao criar novos volumes, pois seu uso impacta o desempenho, especialmente durante operações de gravação aleatória, por causa de:
- É necessário fazer o rastreamento das gravações nos blocos;
- Durante a reconstrução, não há recálculo das checksums para o espaço não ocupado, portanto, ao gravar novamente nesta área, é necessário primeiro "inicializá-la".
Portanto, não é recomendável usar Fast Rebuild para volumes, por exemplo, com bancos de dados de alta carga ou em sistemas de videovigilância, onde o volume, de qualquer forma, será preenchido em 100%. Já para servidores de arquivos ou de e-mail, essa opção será bastante útil.
Em conclusão
Cada fabricante de armazenamento em rede assume que seus dispositivos são confiáveis. E se não houver falhas fatais durante o desenvolvimento dos dispositivos e uma incrível avareza no processo de sua produção e testes, no geral, pode-se concordar com o fornecedor. No entanto, é preciso entender:
- a resistência básica do armazenamento em rede é, acima de tudo, a capacidade de continuar tendo acesso aos dados em caso de falha de algum componente;
- as opções adicionais em termos de resistência a falhas (como as descritas acima) são a exclusão de algumas variantes de falhas e o aumento de suas chances de ter acesso aos dados;
- 100% de confiabilidade, infelizmente, não existe. Mas, para se aproximar o máximo possível dela, a maioria dos fornecedores sensatos de armazenamento em rede (e entre eles) faz o máximo esforço para a melhoria contínua de seus produtos, tanto na parte de hardware quanto no software.
Ao mesmo tempo, também não se deve esquecer que nenhuma confiabilidade absoluta do armazenamento em rede elimina a necessidade de backups, planos claros e ensaiados de recuperação em caso de acidente e suporte técnico operacional do fornecedor.
Fonte: habr.com
