

Nota do tradutor.: Apresentamos a vocês os detalhes técnicos sobre as razões do recente tempo de inatividade do serviço de nuvem, mantido pelos criadores do Grafana. Este é um exemplo clássico de como uma nova e, aparentemente, extremamente útil funcionalidade, destinada a melhorar a qualidade da infraestrutura... pode causar danos se não forem considerados os inúmeros aspectos de sua aplicação na realidade da produção. É maravilhoso quando surgem materiais como este, que permitem aprender não apenas com nossos erros. Mais detalhes estão na tradução deste texto do vice-presidente de produtos da Grafana Labs.
Na sexta-feira, 19 de julho, o serviço Hosted Prometheus no Grafana Cloud parou de funcionar por cerca de 30 minutos. Peço desculpas a todos os clientes afetados pela falha. Nossa tarefa é fornecer as ferramentas necessárias para monitoramento, e entendemos que a falta delas complica sua vida. Levamos este incidente muito a sério. Neste comunicado, explicamos o que aconteceu, como reagimos e o que estamos fazendo para que isso não se repita.
Antecedentes
O serviço Grafana Cloud Hosted Prometheus é baseado em — um projeto da CNCF para criar um serviço Prometheus horizontalmente escalável, altamente disponível e multi-tenant. A arquitetura Cortex é composta por um conjunto de microserviços separados, cada um executando sua função: replicação, armazenamento, consultas, etc. O Cortex está em desenvolvimento ativo, com novas funcionalidades e melhorias de desempenho sendo constantemente lançadas. Regularmente, fazemos deploys de novas versões do Cortex nos clusters, permitindo que os clientes aproveitem essas funcionalidades — felizmente, o Cortex consegue se atualizar sem interrupções.
Para atualizações sem interrupções, o serviço Ingester do Cortex requer uma réplica adicional do Ingester durante o processo de atualização. (Nota do tradutor.: — o componente básico do Cortex. Sua função é coletar um fluxo contínuo de amostras, agrupá-las em chunks do Prometheus e armazená-las em bancos de dados como DynamoDB, BigTable ou Cassandra.) Isso permite que os antigos Ingesters enviem dados atuais para os novos Ingesters. Vale ressaltar que os Ingesters são exigentes em termos de recursos. Para seu funcionamento, é necessário ter 4 núcleos e 15 GB de memória por pod, ou seja, 25% da capacidade de processamento e memória da máquina base em nossos clusters Kubernetes. No geral, temos normalmente muito mais recursos não utilizados no cluster do que 4 núcleos e 15 GB de memória, então podemos facilmente executar esses Ingesters adicionais durante as atualizações.
No entanto, muitas vezes acontece que durante a operação normal não há esses 25% de recursos não utilizados em nenhuma das máquinas. E não buscamos isso: CPU e memória sempre serão necessários para outros processos. Para resolver esse problema, decidimos usar . A ideia é atribuir aos Ingesters uma prioridade mais alta do que a de outros microserviços (sem estado). Quando precisamos iniciar um Ingester adicional (N+1), temporariamente deslocamos outros pods menores. Esses pods são movidos para recursos disponíveis em outras máquinas, deixando um espaço suficientemente grande para iniciar um Ingester adicional.
Na quinta-feira, 18 de julho, implementamos quatro novos níveis de prioridade em nossos clusters: crítico, alto, médio e baixo. Eles foram testados em um cluster interno sem tráfego de clientes por cerca de uma semana. Por padrão, os pods sem prioridade definida recebiam médio prioridade, e para os Ingesters foi estabelecida uma classe com alta prioridade. Crítico foi reservado para monitoramento (Prometheus, Alertmanager, node-exporter, kube-state-metrics, etc.). Nossa configuração é aberta, e você pode ver o PR .
Acidente
Na sexta-feira, 19 de julho, um dos engenheiros iniciou um novo cluster dedicado do Cortex para um grande cliente. A configuração desse cluster não incluía novas prioridades de pods, portanto, todos os novos pods recebiam prioridade padrão — médio.
No cluster Kubernetes, não havia recursos suficientes para o novo cluster Cortex, e o cluster de produção existente do Cortex não foi atualizado (os Ingesters ficaram sem alta prioridade). Como os Ingesters do novo cluster tinham por padrão médio prioridade, e os pods existentes na produção operavam sem prioridade, os Ingesters do novo cluster deslocaram os Ingesters do cluster de produção existente do Cortex.
O ReplicaSet do Ingester expulso no cluster de produção detectou um pod expulso e criou um novo para manter o número especificado de cópias. O novo pod recebeu por padrão médio prioridade, e o próximo Ingester “antigo” na produção perdeu recursos. O resultado foi um processo em cascata, que levou à expulsão de todos os pods com Ingester para os clusters de produção do Cortex.
Os Ingesters são persistentes (stateful) e armazenam dados das últimas 12 horas. Isso nos permite compactá-los de forma mais eficiente antes de escrevê-los no armazenamento de longo prazo. Para isso, o Cortex realiza o sharding dos dados por séries, usando uma tabela hash distribuída (Distributed Hash Table, DHT), e replica cada série em três Ingesters utilizando a consistência de quórum estilo Dynamo. O Cortex não grava dados em Ingesters que estão desligados. Assim, quando um grande número de Ingesters deixa a DHT, o Cortex não consegue garantir a replicação suficiente de registros, e eles “caem”.
Detecção e resolução
Novos alertas do Prometheus baseados em "orçamento de erros" (error-budget-based — detalhes aparecerão em uma futura publicação) começaram a soar o alarme após 4 minutos desde o início do desligamento. Durante os próximos cinco minutos, realizamos uma avaliação e aumentamos o cluster Kubernetes subjacente para acomodar tanto os novos quanto os existentes clusters de produção.
Mais cinco minutos se passaram e os Ingesters antigos conseguiram gravar seus dados, enquanto os novos eram inicializados, e os clusters do Cortex ficaram disponíveis novamente.
Mais 10 minutos foram gastos na análise e correção de erros de out-of-memory (OOM) dos servidores proxy de autenticação que estavam à frente do Cortex. Os erros OOM foram causados por um aumento de dez vezes no QPS (como acreditamos, devido a solicitações excessivamente agressivas dos servidores Prometheus do cliente).
Consequências
A duração total da inatividade foi de 26 minutos. Nenhum dado foi perdido. Os Ingesters conseguiram carregar todos os dados em memória para o armazenamento de longo prazo. Durante o desligamento, os servidores Prometheus dos clientes armazenaram em buffer registros remotos (remote) com o auxílio baseada em WAL (escrita por da Grafana Labs) e repetiram os registros falhados após a falha.
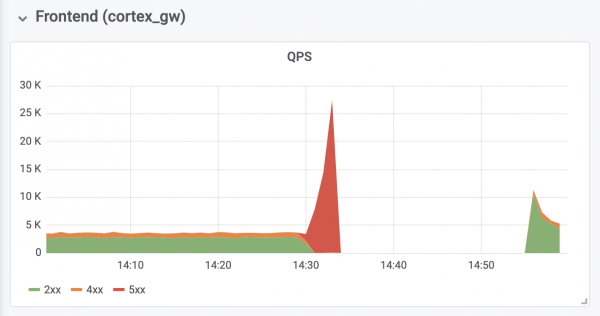
Operações de gravação do cluster de produção
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
É importante aprender com este incidente e tomar as medidas necessárias para evitar que ele se repita.
Olhando para trás, devemos reconhecer que não deveríamos ter definido como padrão médio prioridade, até que todos os Ingester's em produção tivessem recebido alto prioridade. Além disso, deveríamos ter garantido anteriormente suas altas prioridades. Agora está tudo corrigido. Esperamos que nossa experiência ajude outras organizações que consideram o uso de prioridades de pods no Kubernetes.
Vamos adicionar um nível adicional de controle sobre a implantação de quaisquer objetos adicionais, cujas configurações são globais para o cluster. Daqui em diante, tais mudanças serão avaliadas pormaiorum número maior de pessoas. Além disso, a modificação que levou à falha foi considerada muito insignificante para um documento de projeto separado — ela foi discutida apenas em uma questão do GitHub. A partir deste momento, todas as modificações semelhantes de configurações serão acompanhadas pela documentação de projeto adequada.
Finalmente, vamos automatizar o redimensionamento do servidor proxy reverso de autenticação para evitar OOM durante sobrecargas, das quais fomos testemunhas, e analisaremos as configurações padrão do Prometheus relacionadas a rollback e escalonamento, para prevenir problemas semelhantes no futuro.
A falha sofrida também teve algumas consequências positivas: ao obter os recursos necessários, o Cortex se recuperou automaticamente sem intervenção adicional. Também obtivemos valiosa experiência trabalhando com — nosso novo sistema de agregação de logs, — que ajudou a garantir que todos os Ingester's se comportassem adequadamente durante e após a falha.
P.S. do tradutor
Confira também em nosso blog:
- «»;
- «»;
- «»;
- «».
Fonte: habr.com
