

Nos últimos anos, os bancos de dados de séries temporais transformaram-se de algo exótico (aplicável de forma específica em sistemas de monitoramento abertos ou ligados a soluções concretas, ou em projetos de Big Data) em um "produto de consumo popular". No território da Rússia, devemos um agradecimento especial ao Yandex e ao ClickHouse por isso. Até aquele momento, se você precisava armazenar uma grande quantidade de dados de séries temporais, tinha que se conformar com a necessidade de configurar um monstruoso stack Hadoop e mantê-lo ou se comunicar com protocolos específicos para cada sistema.
Pode parecer que em 2019 um artigo sobre qual TSDB usar consistiria apenas em uma frase: "simplesmente use ClickHouse". Mas... há nuances.
De fato, o ClickHouse está se desenvolvendo ativamente, a base de usuários está crescendo e o suporte está sendo mantido de forma muito ativa, mas será que nos tornamos prisioneiros do sucesso público do ClickHouse, que ofuscou outras soluções que podem ser mais eficientes/confiáveis?
No início do ano passado, começamos a reformular nosso próprio sistema de monitoramento, durante o qual surgiu a questão da escolha do banco de dados adequado para armazenamento de dados. Quero contar a história dessa escolha aqui.
Formulação do problema
Primeiramente — uma introdução necessária. Por que precisamos de um sistema de monitoramento próprio e como ele estava estruturado?
Começamos a oferecer serviços de suporte em 2008, e em 2010 ficou claro que agregar dados sobre os processos na infraestrutura dos clientes usando soluções que existiam na época se tornou difícil (falamos, perdoe-me, de Cacti, Zabbix e do emergente Graphite).
Nossos principais requisitos foram:
- suporte (naquele momento — dezenas, e no futuro — centenas) de clientes dentro de um único sistema e, ao mesmo tempo, ter um sistema centralizado de gerenciamento de notificações;
- flexibilidade na gestão do sistema de notificações (escalonamento de notificações entre operadores, acompanhamento de cronogramas, base de conhecimento);
- capacidade de detalhamento profundo dos gráficos (o Zabbix naquela época gerava gráficos na forma de imagens);
- armazenamento prolongado de grandes volumes de dados (um ano ou mais) e a possibilidade de recuperação rápida desses dados.
Neste artigo, estamos interessados no último ponto.
Falando sobre armazenamento, os requisitos eram os seguintes:
- o sistema deve funcionar rapidamente;
- é desejável que o sistema tenha uma interface SQL;
- o sistema deve ser estável e ter uma base de usuários ativa e suporte (em algum momento, nos deparamos com a necessidade de manter sistemas como o MemcacheDB, que deixou de ser desenvolvido, ou o armazenamento distribuído MooseFS, cujo rastreador de bugs era mantido em chinês: não queríamos repetir essa história para o nosso projeto);
- conformidade com o teorema CAP: Consistência (necessário) — os dados devem estar atualizados, não queremos que o sistema de gerenciamento de alertas não receba novos dados e acabe disparando alertas sobre a falta de dados em todos os projetos; Tolerância a Particionamento (necessário) — não queremos ter um sistema com Brain Dividido; Disponibilidade (não crítico, em caso de uma réplica ativa) — podemos nós mesmos mudar para o sistema de backup em caso de falha, via código.
Curiosamente, na época, a solução ideal para nós foi o MySQL. Nossa estrutura de dados era extremamente simples: id do servidor, id do contador, timestamp e valor; a rápida consulta de dados quentes era garantida por um grande tamanho de pool de buffer, e a consulta de dados históricos — por SSD.
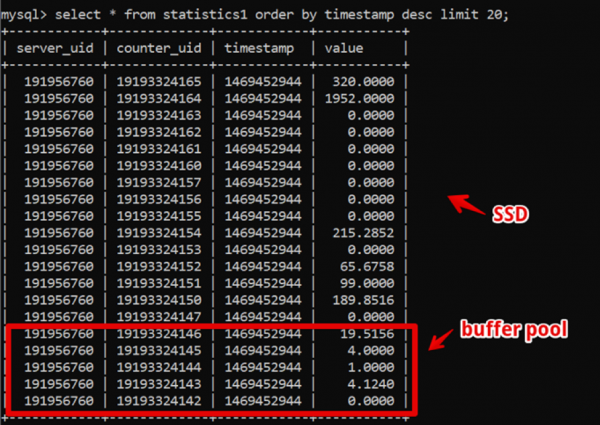
Dessa forma, conseguimos consultar dados frescos de duas semanas, com detalhamento até o segundo, em 200 ms antes do momento da renderização completa dos dados, e vivemos nesse sistema por muito tempo.
Entretanto, o tempo passou e a quantidade de dados cresceu. Até 2016, os volumes de dados atingiram dezenas de terabytes, o que era um custo significativo em condições de armazenamento SSD alugado.
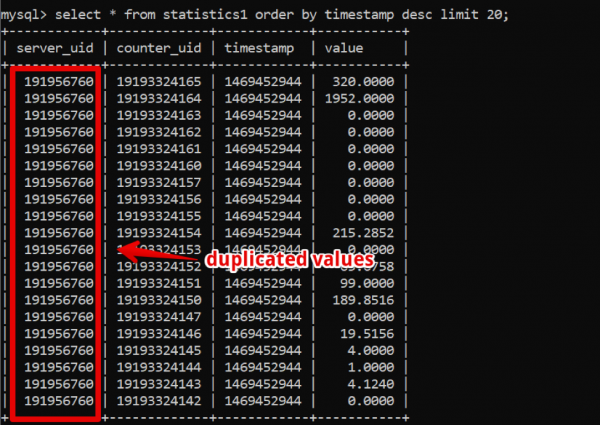
Nesse momento, os bancos de dados colunares começaram a se disseminar ativamente, e começamos a pensar frequentemente sobre eles: nos bancos de dados colunares, os dados são armazenados, como se pode entender, em colunas, e se olharmos para nossos dados, é fácil ver um grande número de duplicatas que poderiam, no caso de usarmos um banco de dados columnar, ser comprimidas.
No entanto, o sistema central para o funcionamento da empresa continuava a operar de forma estável, e não queríamos arriscar a transição para algo diferente.
Em 2017, na conferência Percona Live em San Jose, os desenvolvedores do Clickhouse fizeram sua primeira grande aparição. À primeira vista, o sistema estava pronto para produção (afinal, Yandex.Metrica é um ambiente de produção rigoroso), o suporte era rápido e simples, e, o mais importante, a operação era fácil. Desde 2018, começamos o processo de migração. Mas naquele momento, havia muitas sistemas TSDB 'maduras' e testadas ao longo do tempo, e decidimos dedicar tempo significativo para comparar alternativas, a fim de garantir que não havia soluções alternativas ao Clickhouse que atendessem às nossas necessidades.
Além dos requisitos já mencionados para o armazenamento, surgiram novos:
- o novo sistema deve oferecer, no mínimo, o mesmo desempenho que o MySQL, com a mesma quantidade de hardware;
- o armazenamento do novo sistema deve ocupar significativamente menos espaço;
- o SGBD ainda deve ser fácil de gerenciar;
- gostaria de mudar o aplicativo o mínimo possível ao trocar de SGBD.
Quais sistemas começamos a considerar
Apache Hive/Apache Impala
Um stack Hadoop testado na prática. Na essência, é uma interface SQL construída sobre a armazenagem de dados em seus próprios formatos no HDFS.
Prós.
- Com uma operação estável, é muito fácil escalar os dados.
- Existem soluções de armazenamento em colunas (menos espaço).
- Execução muito rápida de tarefas paralelizadas quando há recursos disponíveis.
Contras.
- É Hadoop, e é complexo para operação. Se não estamos prontos para optar por uma solução pronta na nuvem (e não estamos prontos devido ao custo), todo o stack terá que ser montado e mantido manualmente pelos administradores, o que é bastante indesejado.
- Os dados são agregados .
No entanto:
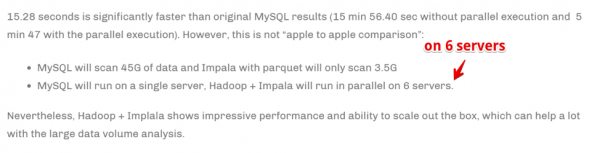
A velocidade é alcançada escalando o número de servidores computacionais. Em outras palavras, se somos uma grande empresa, lidando com análises e é crítico para o negócio agregar informações o mais rápido possível (mesmo que isso custe o uso de muitos recursos computacionais), isso pode ser a nossa escolha. Mas não estávamos prontos para aumentar significativamente nossa infraestrutura de hardware para acelerar a execução das tarefas.
Druid/Pinot
Já temos muito mais sobre especificamente TSDB, mas novamente — stack Hadoop.
Há .
Em poucas palavras: Druid/Pinot parecem melhores que o Clickhouse em casos em que:
- Você possui um caráter de dados heterogêneo (no nosso caso, estamos registrando apenas séries temporais de métricas de servidores, e, na verdade, isso é uma única tabela. Mas podem existir outros casos: séries temporais de equipamentos, séries temporais econômicas etc. — cada uma com sua própria estrutura, que precisa ser agregada e processada).
- Por outro lado, há uma grande quantidade desses dados.
- Tabelas e dados com séries temporais aparecem e desaparecem (ou seja, um conjunto de dados chega, é analisado e deletado).
- Não há um critério claro pelo qual os dados podem ser particionados.
Em casos opostos, o ClickHouse se destaca melhor, e este é o nosso caso.
ClickHouse
- Semelhante ao SQL.
- Fácil de gerenciar.
- As pessoas dizem que ele funciona.
Está na lista curta de testes.
InfluxDB
Alternativa internacional ao ClickHouse. Entre os contras: Alta Disponibilidade está presente apenas na versão comercial, mas é necessário comparar.
Está na lista curta de testes.
Cassandra
Por um lado, sabemos que ele é usado para armazenar séries temporais métricas por sistemas de monitoramento como, por exemplo, ou OkMeter. No entanto, há particularidades.
Cassandra não é um banco de dados colunar em seu entendimento tradicional. Ela se parece mais com um banco de dados de linha, mas em cada linha pode haver um número diferente de colunas, o que facilita a organização da representação em colunas. Nesse sentido, é claro que com uma limitação de 2 bilhões de colunas, é possível armazenar alguns dados exatamente em colunas (como as mesmas séries temporais). Por exemplo, no MySQL existe uma limitação de 4096 colunas e é fácil encontrar um erro de código 1117 se tentar fazer o mesmo.
O mecanismo Cassandra é voltado para armazenar grandes volumes de dados em um sistema distribuído sem mestre, e na mencionada teoria CAP, Cassandra se destaca mais no AP, ou seja, na disponibilidade de dados e resistência à separação de partições. Assim, essa ferramenta pode ser ideal se for necessário apenas inserir dados nesse banco e ler deles raramente. Aqui, faz sentido usar Cassandra como um armazenamento 'frio'. Ou seja, como um local confiável e de longo prazo para armazenar grandes volumes de dados históricos que são raramente necessários, mas que podem ser acessados quando necessário. No entanto, para uma visão completa, vamos testá-la também. Mas, como mencionei anteriormente, não há desejo de reescrever ativamente o código para o banco de dados escolhido, portanto, vamos testá-la de forma algo limitada — sem adaptar a estrutura do banco à especificidade do Cassandra.
Prometheus
E por curiosidade, decidimos testar o desempenho do storage Prometheus — apenas para entender se somos mais rápidos do que as soluções atuais ou mais lentos e em que medida.
Metodologia e resultados do teste
Assim, testamos 5 bancos de dados nas seguintes 6 configurações: ClickHouse (1 nó), ClickHouse (tabela distribuída em 3 nós), InfluxDB, Mysql 8, Cassandra (3 nós) e Prometheus. O plano de teste é o seguinte:
- importamos dados históricos por uma semana (840 milhões de valores por dia; 208 mil métricas);
- geramos carga de escrita (consideramos 6 modos de carga, veja abaixo);
- paralelamente à escrita, periodicamente fazemos consultas, simulando as solicitações de um usuário que trabalha com gráficos. Para não complicar muito, escolhemos os dados de 10 métricas (justamente o número de métricas no gráfico de CPU) para a semana.
Geramos carga, simulando o comportamento do agente de monitoramento que envia valores para cada métrica a cada 15 segundos. Neste processo, estamos interessados em variar:
- o número total de métricas em que os dados são gravados;
- o intervalo de envio de valores para uma métrica;
- o tamanho do lote.
Sobre o tamanho do lote. Como quase todos os nossos bancos de dados em teste não recomendam cargas com inserções únicas, precisaremos de um relay que agrupe as métricas recebidas e as escreva no banco em inserções em lote.
Além disso, para entender melhor como interpretar os dados obtidos, vamos imaginar que não estamos apenas enviando uma quantidade de métricas, mas que as métricas estão organizadas em servidores — 125 métricas por servidor. Aqui, o servidor é apenas uma entidade virtual — apenas para entender que, por exemplo, 10.000 métricas correspondem a aproximadamente 80 servidores.
E assim, levando tudo isso em consideração, nossos 6 modos de carga do banco de dados para gravação:
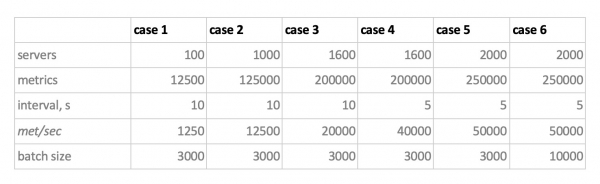
Aqui temos dois pontos. Primeiro, para o Cassandra, esses tamanhos de lotes se provaram grandes demais; lá usamos valores de 50 ou 100. Em segundo lugar, uma vez que o Prometheus opera estritamente no modo pull, ou seja, ele mesmo coleta dados das fontes de métricas (e até o pushgateway, apesar do nome, não altera a situação), as cargas correspondentes foram implementadas por meio de uma combinação de configurações estáticas.
Os resultados dos testes são os seguintes:
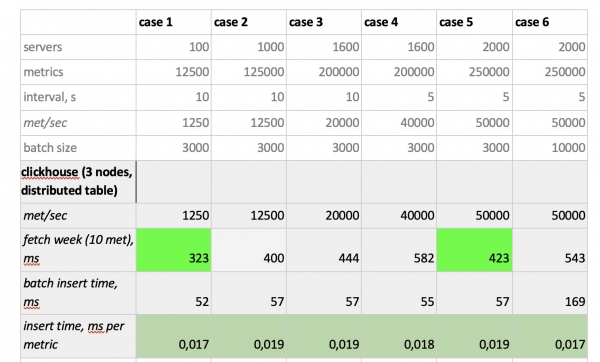
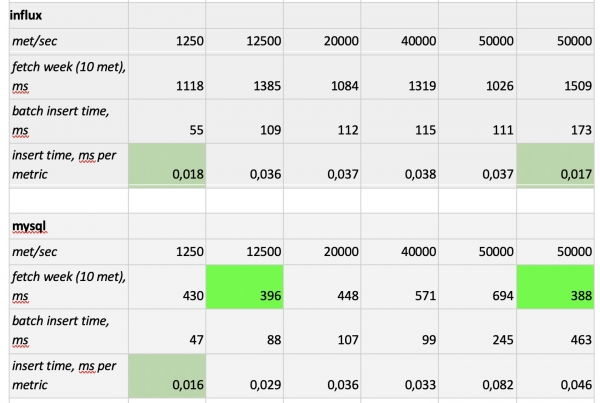
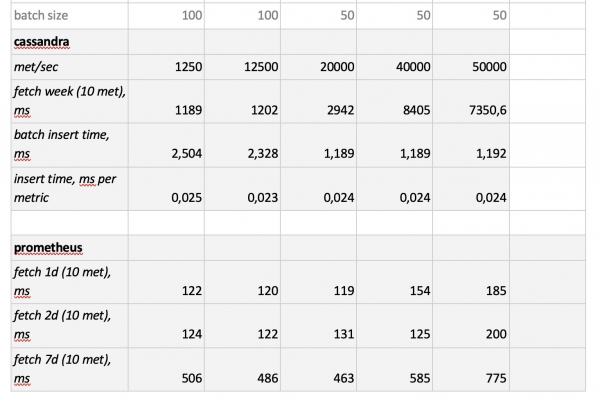
O que vale a pena destacar: foram seleções incrivelmente rápidas do Prometheus, seleções extremamente lentas do Cassandra, seleções inaceitavelmente lentas do InfluxDB; em termos de velocidade de gravação, o ClickHouse venceu todos, e o Prometheus não participa da competição, porque ele realiza as inserções internamente e não medimos nada.
Como resultado,: ClickHouse e InfluxDB se destacaram, mas um cluster do InfluxDB só pode ser construído com base na versão Enterprise, que tem custo, enquanto o ClickHouse é gratuito e foi desenvolvido na Rússia. Faz sentido que nos EUA a escolha seja provavelmente pelo InfluxDB, enquanto aqui a preferência é pelo ClickHouse.
Fonte: habr.com
