

27 de maio no salão principal da conferência DevOpsConf 2019, realizada durante o festival , no âmbito da seção "Entrega Contínua", foi apresentada a palestra "werf — nossa ferramenta para CI/CD no Kubernetes". Nela, falamos sobre os problemas e desafios que todos enfrentam ao implantar no Kubernetes, assim como as nuances que podem não ser evidentes de imediato. Ao explorar possíveis soluções, mostramos como isso é implementado na ferramenta de código aberto .
Desde a apresentação, nossa utilidade (anteriormente conhecida como dapp) ultrapassou a marca histórica de 1000 estrelas no GitHub — esperamos que a comunidade crescente de usuários facilite a vida de muitos engenheiros de DevOps.
Portanto, apresentamos (~47 minutos, muito mais informativa que o artigo) e um resumo principal em formato de texto. Vamos lá!
Entrega de código no Kubernetes
O foco da palestra não será mais sobre werf, mas sobre CI/CD no Kubernetes, assumindo que nosso software está empacotado em contêineres Docker (sobre isso falei na ), e o K8s será usado para executá-lo em produção (sobre isso — na ).
Como é a entrega no Kubernetes?
- Há um repositório Git com o código e instruções para sua construção. O aplicativo é construído em uma imagem Docker e publicado no Docker Registry.
- Nesse mesmo repositório, estão as instruções sobre como implantar e executar o aplicativo. Na fase de implantação, essas instruções são enviadas ao Kubernetes, que obtém a imagem necessária do registry e a executa.
- Além disso, geralmente há testes. Alguns deles podem ser executados ao publicar a imagem. Também é possível (com as mesmas instruções) implantar uma cópia do aplicativo (em um namespace separado do K8s ou em um cluster separado) e executar testes lá.
- Finalmente, é necessário um sistema de CI que receba eventos do Git (ou cliques de botão) e invoque todas as etapas definidas: build, publish, deploy, test.
Aqui estão algumas observações importantes:
- Como temos uma infraestrutura imutável (immutable infrastructure), a imagem do aplicativo, que é utilizada em todas as etapas (staging, production, etc.), deve ser única. Mais detalhes sobre isso e exemplos foram apresentados .
- Como seguimos a abordagem de infraestrutura como código (IaC), o código do aplicativo, as instruções para sua construção e execução devem estar justamente em um único repositório. Mais sobre isso — consulte a .
- A cadeia de entrega (delivery) geralmente a vemos assim: o aplicativo foi construído, testado, lançado (fase de release) e pronto — a entrega foi realizada. Mas, na verdade, o usuário recebe o que você lançou, não no momento em que você o enviou para produção, e quando ele conseguiu acessar e essa produção funcionou. Portanto, eu considero que a cadeia de entrega termina somente na fase de operação (execução), e se quisermos ser mais precisos, até o momento em que o código foi removido da produção (substituído por uma nova versão).
Vamos voltar ao esquema de entrega mencionado acima no Kubernetes: ele foi criado não apenas por nós, mas por praticamente todos que lidaram com esse problema. Na verdade, esse padrão agora é chamado de GitOps (você pode ler mais sobre o termo e as ideias por trás dele ). Vamos olhar para as etapas do esquema.
Fase de construção (build)
Aparentemente, o que se pode dizer em 2019 sobre a construção de imagens Docker, quando todos sabem escrever Dockerfiles e executar docker build?.. Вот нюансы, на которые хотелось бы обратить внимание:
- O tamanho da imagem é importante, por isso use , para manter na imagem apenas o que realmente é necessário para o funcionamento do aplicativo.
- O número de camadas deve ser minimizado, combinando cadeias de
RUN-comandos por significado. - No entanto, isso traz problemas para a depuração, já que, ao falhar a construção, é preciso encontrar o comando necessário na cadeia que causou o problema.
- A velocidade da construção é importante, porque queremos lançar mudanças rapidamente e ver o resultado. Por exemplo, não queremos recompilar dependências nas bibliotecas da linguagem a cada construção do aplicativo.
- Frequentemente, de um único repositório Git, são necessários muitas imagens, o que pode ser solucionado com um conjunto de Dockerfiles (ou estágios nomeados em um único arquivo) e um script Bash para sua construção sequencial.
Isso foi apenas a ponta do iceberg, que todos enfrentam. Mas há outros problemas, como:
- Frequentemente, na fase de construção, precisamos montar (por exemplo, em cache o resultado de um comando tipo apt em um diretório externo).
- Queremos Ansible em vez de escrever em shell.
- Queremos construir sem Docker (por que precisamos de uma máquina virtual adicional, onde tudo precisa ser configurado, quando já temos um cluster Kubernetes no qual podemos executar contêineres?).
- Construção paralela, que pode ser entendida de várias maneiras: diferentes comandos de um Dockerfile (se usado multi-stage), vários commits de um repositório, vários Dockerfiles.
- Construção distribuída: queremos coletar algo em pods que são "efêmeros", já que eles perdem o cache, e portanto — é necessário armazená-lo em outro lugar.
- Finalmente, eu chamava o auge dos desejos automagia: seria ideal acessar o repositório, digitar um comando qualquer e obter uma imagem pronta, montada com o entendimento de como e o que fazer corretamente. No entanto, pessoalmente, não estou certo de que todos os detalhes podem ser previstos assim.
E aqui estão os projetos:
- — um montador da empresa Docker Inc (já integrado nas versões mais recentes do Docker), que tenta resolver todos esses problemas;
- — um montador do Google, que permite montar sem Docker;
- — uma tentativa do CNCF de fazer automagia e, em particular, uma solução interessante com rebase para camadas;
- e mais um monte de outras utilidades, como , …
… e veja quantas estrelas eles têm no GitHub. Portanto, por um lado, docker build existe e pode fazer algo, mas na realidade a questão não está totalmente resolvida — a prova disso é o desenvolvimento paralelo de montadores alternativos, cada um dos quais resolve uma parte dos problemas.
Montagem no werf
Assim, chegamos a (anteriormente como dapp) — uma utilidade Open Source da empresa "Flant", que estamos desenvolvendo há muitos anos. Começamos há cerca de 5 anos com scripts Bash, otimizando a montagem de Dockerfiles, e nos últimos 3 anos temos feito um desenvolvimento completo dentro de um único projeto com seu próprio repositório Git (primeiro em Ruby, e depois em Go, e também mudamos o nome). Quais problemas de montagem foram resolvidos no werf?
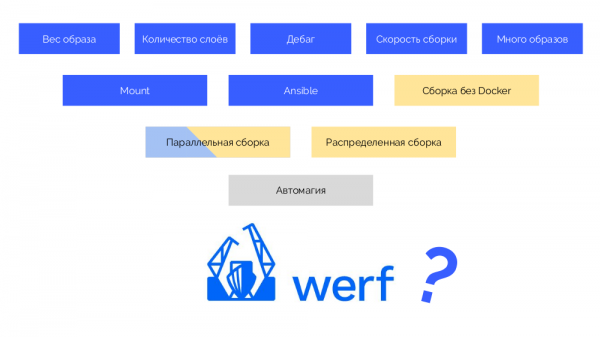
Os problemas marcados em azul já foram implementados, e a montagem paralela foi feita dentro de um único host, enquanto as questões destacadas em amarelo planejamos finalizar até o final do verão.
Fase de publicação no registry (publish)
Coletamos docker push… — o que pode ser complicado em carregar uma imagem no registry? E aqui surge a pergunta: "Qual tag atribuir à imagem?" Surge porque temos Gitflow (ou outra estratégia do Git) e Kubernetes, e a indústria tende a que o que acontece no Kubernetes siga o que está sendo feito no Git. Afinal, o Git é nossa única fonte da verdade.
Qual é a complicação nisso? Garantir a reprodutibilidade: do commit no Git, que por natureza é imutável (immutable),, para a imagem Docker, que deve ser preservada da mesma forma.
Também é importante para nós definir a origem, porque queremos entender de qual commit o aplicativo que está rodando no Kubernetes foi construído (assim poderemos fazer diffs e coisas semelhantes).
Estratégias de versionamento
A primeira é um simples git tag. Temos um registro com a imagem marcada como 1.0. No Kubernetes, existem os ambientes de stage e produção, onde essa imagem foi implantada. No Git, fazemos commits e em algum momento aplicamos a tag 2.0. Coletamos seguindo as instruções do repositório e colocamos no registro com a tag 2.0. Implantamos no stage e, se tudo estiver bom, depois na produção.
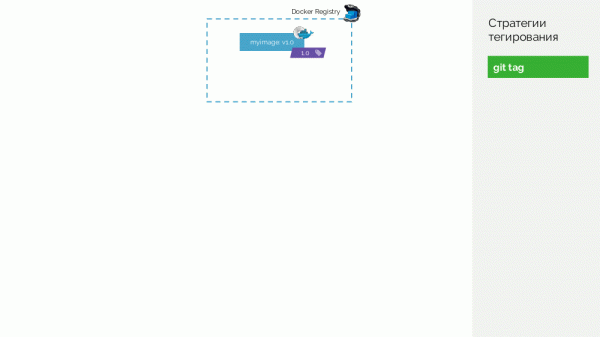
O problema desse abordagem é que primeiro aplicamos a tag e só depois testamos e implantamos. Por quê? Primeiro, isso é simplesmente ilógico: estamos lançando uma versão de um software que ainda não verificamos (não podemos fazer diferente, pois para testar é necessário aplicar a tag). Em segundo lugar, esse caminho não se alinha com o Gitflow.
A segunda opção é git commit + tag. Na branch master, há uma tag 1.0; para ela no registro - uma imagem implantada na produção. Além disso, há contornos de preview e staging no cluster Kubernetes. Em seguida, seguimos o Gitflow: na branch principal de desenvolvimento (develop) fazemos novas funcionalidades, resultando em um commit com o identificador #c1. Coletamos e publicamos no registro, usando esse identificador (#c1). Com o mesmo identificador, implantamos no preview. Fazemos o mesmo com os commits #c2 e #c3.
Quando entendemos que temos funcionalidades suficientes, começamos a estabilizar tudo. No Git, criamos uma branch release_1.1 (baseado em #c3 do develop). Não será necessário coletar essa versão, pois já foi feita na etapa anterior. Portanto, podemos simplesmente implantá-la no staging. Corrigimos bugs em #c4 e implantamos no staging de forma similar. Paralelamente, está ocorrendo desenvolvimento em develop, onde periodicamente absorvemos alterações de release_1.1. Em algum momento, obtemos um commit coletivo e implantado no staging do qual estamos satisfeitos (#c25).
Então fazemos merge (com fast-forward) da branch de release (release_1.1) na master. Aplicamos uma tag com a nova versão a esse commit (1.1). Mas essa imagem já foi coletada no registro, então, para não coletá-la novamente, simplesmente adicionamos uma segunda tag à imagem existente (agora ela no registro tem as tags #c25 e 1.1). Após isso, implantamos na produção.
Há uma desvantagem, pois no staging foi implantada uma imagem (#c25), enquanto na produção parece que é outra (1.1), mas sabemos que “fisicamente” é a mesma imagem do registro.
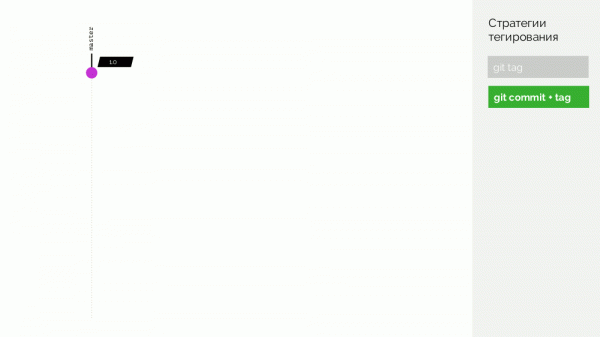
O verdadeiro problema é que não há suporte a merge commits, precisamos fazer fast-forward.
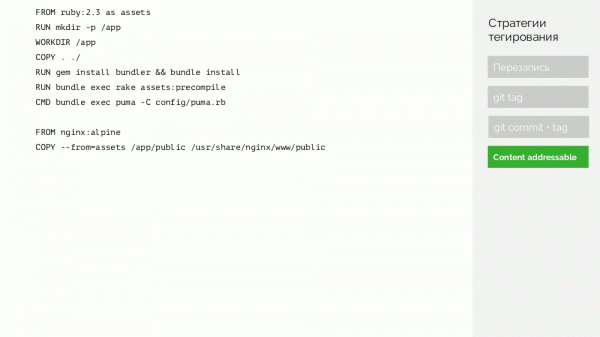
Podemos ir mais longe e fazer um truque… Vamos considerar um exemplo de um Dockerfile simples:
FROM ruby:2.3 as assets
RUN mkdir -p /app
WORKDIR /app
COPY . ./
RUN gem install bundler && bundle install
RUN bundle exec rake assets:precompile
CMD bundle exec puma -C config/puma.rb

FROM nginx:alpine
COPY --from=assets /app/public /usr/share/nginx/www/public
Construiremos a partir dele um arquivo com o seguinte princípio, que pegaremos:
- SHA256 dos identificadores das imagens utilizadas (
ruby:2.3enginx:alpine), que são as somas de verificação de seu conteúdo; - todos os comandos (
RUN,CMDetc.); - SHA256 dos arquivos que foram adicionados.
… e pegaremos a soma de verificação (novamente SHA256) desse arquivo. Isso é a assinatura de tudo que define o conteúdo da imagem Docker.
Voltando ao esquema, em vez de commits, usaremos essas assinaturas,, ou seja, marcarmos imagens com assinaturas.
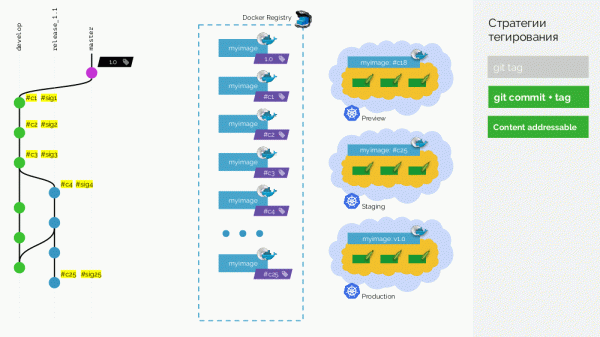
Agora, quando necessário, por exemplo, para ‘fazer merge’ de mudanças da versão para o master, podemos fazer um verdadeiro commit de merge: ele terá um identificador diferente, mas a mesma assinatura. Com o mesmo identificador, iremos implantar a imagem na produção.
A desvantagem é que agora não conseguiremos determinar qual commit foi implantado na produção — as somas de verificação funcionam apenas em uma direção. Este problema é resolvido com uma camada adicional de metadados — explicarei mais adiante.
Marcação no werf
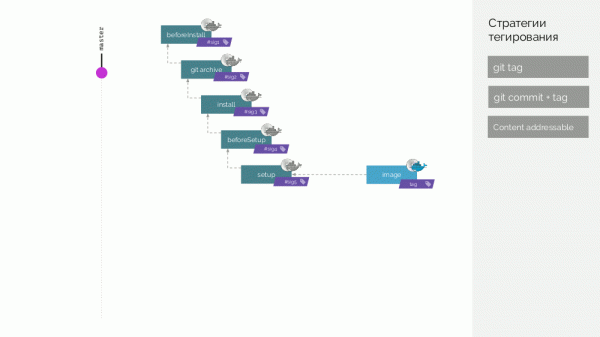
No werf, fomos ainda mais longe e estamos nos preparando para uma construção distribuída com um cache que não é armazenado em uma única máquina… Então, estamos construindo imagens Docker de dois tipos, a quais chamamos de stage e image.
No repositório Git do werf, armazenamos instruções específicas para a construção, descrevendo diferentes etapas da construção (beforeInstall, install, beforeSetup, setup). O primeiro estágio da imagem é construído com a assinatura, definida como a soma de verificação dos primeiros passos. Em seguida, adicionamos o código-fonte; para a nova imagem do estágio, consideramos a sua soma de verificação… Essas operações se repetem para todas as etapas, resultando em um conjunto de imagens de estágio. Em seguida, fazemos a imagem final, que contém também metadados sobre sua origem. E essa imagem é marcada de várias maneiras (detalhes depois).
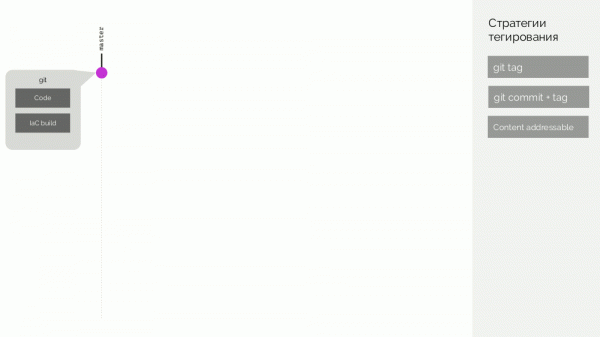
Suponha que depois disso aparece um novo commit, onde apenas o código do aplicativo foi alterado. O que acontecerá? Um patch será criado para as alterações de código, um novo stage-image será preparado. A sua assinatura será determinada como o checksum da antiga stage-image e do novo patch. A partir dessa imagem, um novo final image será formado. Um comportamento semelhante ocorrerá nas mudanças em outras etapas.
Assim, os stage-images são um cache que pode ser armazenado de forma distribuída, enquanto as image-images criadas a partir dele são carregadas no Docker Registry.
Limpeza do registry
A questão não é sobre a remoção de camadas que ficaram penduradas após tags removidas — essa é uma funcionalidade padrão do próprio Docker Registry. Trata-se da situação em que se acumula um grande número de tags Docker e percebemos que parte delas não nos é mais necessária, ocupando espaço (e/ou pagando por isso).
Quais são as estratégias de limpeza?
- Pode-se simplesmente não fazer nada não limpar. Às vezes, realmente é mais fácil pagar um pouco a mais por espaço extra do que desfazer um emaranhado enorme de tags. Mas isso só funciona até certo ponto.
- Reset completo. Se todos os images forem deletados e apenas os atuais forem reconstruídos no sistema CI, isso pode causar um problema. Se um container for reiniciado em produção, ele carregará uma nova imagem — uma que ainda não foi testada por ninguém. Isso compromete a ideia de infraestrutura imutável.
- Blue-green. Um registry começou a ficar cheio — carregamos imagens em outro. O mesmo problema que na abordagem anterior: em que momento podemos limpar o registry que começou a ficar cheio?
- Baseado no tempo. Remover todas as imagens com mais de 1 mês? Mas sempre haverá algum serviço que não foi atualizado por um mês inteiro...
- Manual determinar o que já pode ser deletado.
Na verdade, existem duas opções viáveis: não limpar ou uma combinação de blue-green + manual. Neste último caso, trata-se do seguinte: quando você percebe que é hora de limpar o registry, cria um novo e adiciona todas as novas imagens a ele ao longo de, por exemplo, um mês. E após um mês, veja quais pods no Kubernetes ainda estão usando o antigo registry e mova-os também para o novo registry.
Aonde chegamos em werf? Мы собираем:
- Cabeça do Git: todas as tags, todos os ramos, — presumindo que tudo que está tagueado no Git, precisamos também nas imagens (e se não, deve ser deletado no próprio Git);
- todos os pods que foram descarregados agora no Kubernetes;
- replica sets antigos (o que foi recentemente descarregado), além de planejarmos escanear lançamentos do Helm e coletar as últimas imagens lá.
… e fazemos dessa coleção uma lista branca — uma lista de imagens que não iremos deletar. Todo o resto é eliminado, após o qual encontramos imagens orfãs e também as deletamos.
Fase de implantação (deploy)
Declaratividade confiável
O primeiro ponto que gostaria de destacar na implantação é a aplicação de uma nova configuração de recursos, declarada de forma declarativa. O documento YAML original que descreve os recursos do Kubernetes costuma ser bastante diferente do resultado que realmente opera no cluster. Porque o Kubernetes adiciona à configuração:
- identificadores;
- informações de sistema;
- vários valores padrão;
- seção com o status atual;
- alterações feitas no contexto do admission webhook;
- resultado do trabalho de vários controladores (e do scheduler).
Portanto, quando uma nova configuração de recurso aparece (novo), não podemos simplesmente sobrescrever a configuração atual, "viva", (live). Para isso, teremos que compará-la novo com a última configuração aplicada ("last-applied") e aplicar o patch obtido. live Essa abordagem é chamada de
mesclagem de 2 vias . Ela é usada, por exemplo, no Helm.Existe também a
mesclagem de 3 vias , que se diferencia pelo fato de que:ao comparar
- , observamos o que foi removido; "last-applied" e novo, observamos o que foi adicionado ou modificado;
- , observamos o que foi removido; novo e liveaplicamos o patch resumido em
- Implantamos mais de 1000 aplicativos com o Helm, portanto, na prática, vivemos com a mesclagem de 2 vias. No entanto, ela possui uma série de problemas, que resolvemos com nossos patches, ajudando o Helm a funcionar corretamente. live.
Status real da implantação
Após um evento, nosso sistema CI gerou uma nova configuração para o Kubernetes, que é enviada para aplicação
(apply) no cluster — usando Helm ou . Em seguida, ocorre a mesclagem N-way já descrita, à qual a API do Kubernetes responde de forma positiva ao sistema CI, e este, ao seu usuário. kubectl applyNo entanto, há um enorme problema: porque
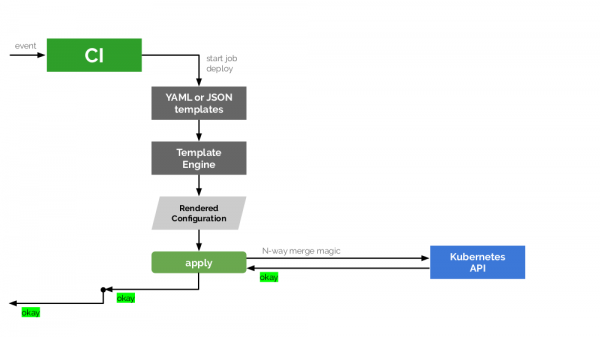
a aplicação bem-sucedida não significa uma implantação bem-sucedida. Se o Kubernetes entendeu quais alterações devem ser aplicadas e as aplica — ainda não sabemos qual será o resultado. Por exemplo, a atualização e reinício de pods no frontend podem ocorrer com sucesso, enquanto no backend pode não, e acabamos tendo diferentes versões das imagens do aplicativo em execução.. Se o Kubernetes compreendeu quais mudanças precisam ser aplicadas, ele as aplica — ainda não sabemos qual será o resultado. Por exemplo, a atualização e a reinicialização dos pods no frontend podem ocorrer com sucesso, enquanto no backend pode não ocorrer, e teremos diferentes versões das imagens do aplicativo em execução.
Para fazer tudo corretamente, neste esquema surge um elo adicional — um rastreador especial que receberá informações do Kubernetes API sobre o status e as transmitirá para uma análise mais profunda da situação real. Criamos uma biblioteca Open Source em Go — (veja seu anúncio ), — que resolve esse problema e está integrada ao werf.
O comportamento desse rastreador no nível do werf é configurado por meio de anotações que são aplicadas em Deployments ou StatefulSets. A principal anotação é fail-mode — que compreende os seguintes valores:
-
IgnoreAndContinueDeployProcess— ignoramos os problemas na implantação deste componente e continuamos o deploy; -
FailWholeDeployProcessImmediately— um erro neste componente interrompe o processo de deploy; -
HopeUntilEndOfDeployProcess— esperamos que este componente funcione até o final do deploy.
Por exemplo, essa combinação de recursos e valores da anotação fail-mode:
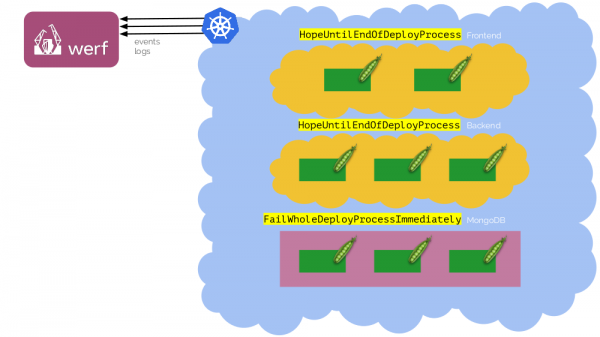
Quando implantamos pela primeira vez, o banco de dados (MongoDB) pode não estar pronto — os Deployments falharão. Mas é possível aguardar até que ele seja iniciado, e a implantação ainda assim será bem-sucedida.
Existem mais duas anotações para kubedog no werf:
-
failures-allowed-per-replica— o número de falhas permitidas por réplica; -
show-logs-until— controla o momento até o qual werf exibe (no stdout) os logs de todos os pods implantados. Por padrão, isso éPodIsReady(para ignorar mensagens que provavelmente não precisamos quando o pod começa a receber tráfego), no entanto, também são aceitos os valoresControllerIsReadyeEndOfDeploy.
O que mais queremos da implantação?
Além dos dois pontos já descritos, gostaríamos de:
- ver logs — e apenas os necessários, não todos eles;
- monitorar o progresso, porque se uma job "silenciosamente" estiver travada por vários minutos, é importante entender o que está acontecendo;
- ter rollback automático caso algo dê errado (daí a importância de saber o status real do deploy). A implantação deve ser atômica: ou ocorre até o final, ou tudo volta ao estado anterior.
Resultados
Como empresa, para implementar todas essas nuances em diferentes etapas da entrega (build, publish, deploy), precisamos apenas de um sistema CI e da ferramenta .
Em conclusão:
Com o werf, avançamos consideravelmente na resolução de uma série de problemas enfrentados por engenheiros DevOps e ficaremos felizes se uma comunidade mais ampla pelo menos experimentar essa ferramenta na prática. Alcançar bons resultados juntos será mais fácil.
Vídeo e slides
Vídeo da apresentação (~47 minutos):
Apresentação da palestra:
P.S.
Outros relatórios sobre Kubernetes em nosso blog:
- «» (Dmitry Stolyarov; 27 de abril de 2019 no "Stachka");
- «» (Andrey Polovov; 8 de abril de 2019 no Saint HighLoad++);
- «» (Dmitry Stolyarov; 8 de novembro de 2018 no HighLoad++);
- «» (Dmitry Stolyarov; 28 de maio de 2018 no RootConf);
- «» (Dmitry Stolyarov; 7 de novembro de 2017 no HighLoad++);
- «» (Dmitry Stolyarov; 6 de junho de 2017 no RootConf).
Fonte: habr.com
