

Introdução
Por um acaso, no meu trabalho atual, tive que me familiarizar com esta tecnologia. Começarei com uma breve introdução. Em uma reunião recente, nossa equipe foi informada que precisava criar uma integração com um sistema conhecido. A integração significava que esse sistema conhecido nos enviaria solicitações via HTTP para um determinado endpoint, e nós, curiosamente, devolveríamos respostas no formato de mensagens SOAP. Parece tudo simples e trivial. Disto se conclui que é necessário...
Tarefa
Criar 3 serviços. O primeiro deles é o Serviço de Atualização do Banco de Dados. Este serviço, ao receber novos dados de um sistema externo, atualiza as informações no banco de dados e gera um arquivo em formato CSV, para ser enviado ao próximo sistema. É chamado o endpoint do segundo serviço — o Serviço de Transporte via FTP, que recebe o arquivo enviado, valida-o e o armazena em um repositório de arquivos via FTP. O terceiro serviço — o Serviço de Transferência de Dados para o Consumidor, opera de forma assíncrona com os dois primeiros. Ele aceita uma solicitação de um sistema externo para obter o arquivo mencionado anteriormente, pega o arquivo de resposta pronto, modifica-o (atualiza os campos id, description, linkToFile) e envia a resposta no formato de mensagem SOAP. Portanto, em resumo, os dois primeiros serviços iniciam seu trabalho apenas quando novos dados para atualização chegam. O terceiro serviço opera continuamente, uma vez que há muitos consumidores de informações, cerca de 1000 solicitações para obter dados por minuto. Os serviços estão disponíveis o tempo todo e suas instâncias estão situadas em diferentes ambientes, como teste, demo, pré-produção e produção. Abaixo está o esquema de funcionamento desses serviços. Desde já explico que alguns detalhes foram simplificados para evitar complexidade desnecessária.
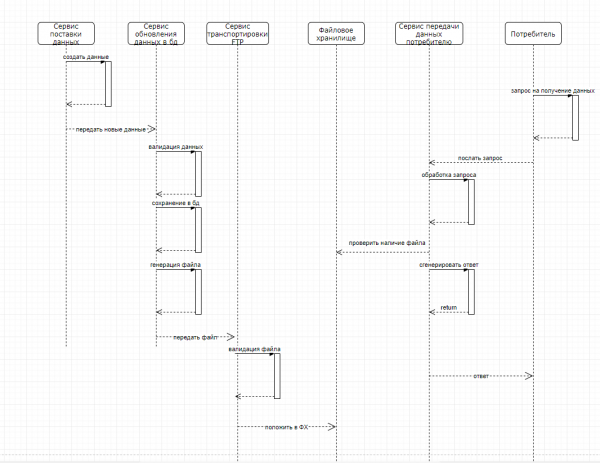
Aprofundamento técnico
Ao planejar uma solução para o problema, decidimos inicialmente criar aplicações em Java usando o Spring framework, com um balanceador Nginx, um banco de dados Postgres e outras ferramentas técnicas, algumas mais complexas que outras. Como o tempo para desenvolver a solução técnica permitia considerar outras abordagens, nossa atenção se voltou para a tecnologia Apache NIFI, popular em certos círculos. De imediato, devo mencionar que essa tecnologia nos permitiu identificar esses 3 serviços. Este artigo descreverá o desenvolvimento do serviço de transporte de arquivos e do serviço de transferência de dados para o consumidor, mas se o artigo for bem recebido, escreverei sobre o serviço de atualização de dados no banco de dados.
O que é isso
O NIFI representa uma arquitetura distribuída para carregamento e processamento de dados de forma rápida e paralela, com muitos plugins para fontes e transformações, versionamento de configurações e muito mais. Um bônus agradável é que é muito fácil de usar. Processos triviais, como getFile, sendHttpRequest e outros, podem ser representados como quadrados. Cada quadrado representa um processo, cuja interação pode ser visualizada na imagem abaixo. A documentação mais detalhada sobre a configuração e interação de processos está escrita , para quem fala russo — . A documentação descreve muito bem como descompactar e iniciar o NIFI, além de como criar processos, que também são conhecidos como quadrados.
A ideia de escrever este artigo surgiu após longas pesquisas e a organização das informações obtidas em algo coerente, além do desejo de facilitar um pouco a vida dos futuros desenvolvedores.
Exemplo
Foi apresentado um exemplo de como os quadrados interagem entre si. O esquema geral é bastante simples: recebemos uma solicitação HTTP (teoricamente com um arquivo no corpo da solicitação. Para demonstrar as capacidades do NIFI, neste exemplo, a solicitação inicia o processo de obtenção do arquivo do armazenamento local), em seguida, enviamos de volta uma resposta informando que a solicitação foi recebida, enquanto simultaneamente iniciamos o processo de obtenção do arquivo do armazenamento e, em seguida, o processo de movimentação via FTP para o armazenamento. Vale a pena enfatizar que os processos interagem entre si por meio do que é chamado de flowFile. Esta é a entidade básica no NIFI, que armazena atributos e conteúdo. O conteúdo é os dados que são representados pelo arquivo de fluxo. Ou seja, de forma simplificada, se você recebeu um arquivo de um quadrado e o está transferindo para outro, o conteúdo será o seu arquivo.
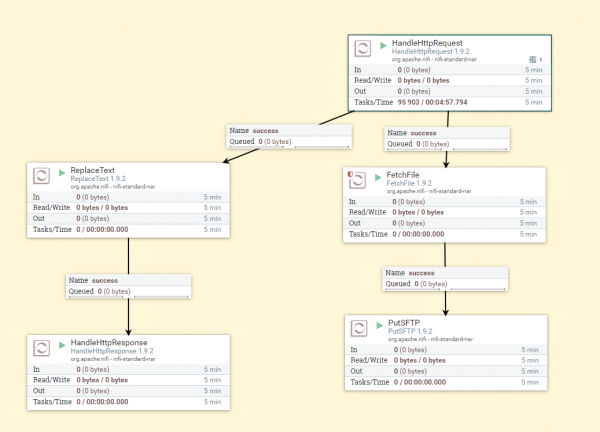
Como você pode notar — nesta imagem está representado o processo geral. HandleHttpRequest — recebe as solicitações, ReplaceText — gera o corpo da resposta, HandleHttpResponse — retorna a resposta. FetchFile — obtém o arquivo do armazenamento de arquivos e o envia para o quadrado PutSftp — que coloca esse arquivo no FTP, no endereço especificado. Agora, vamos ver mais detalhes sobre esse processo.
Neste caso — a solicitação é o começo de tudo. Vamos analisar seus parâmetros de configuração.
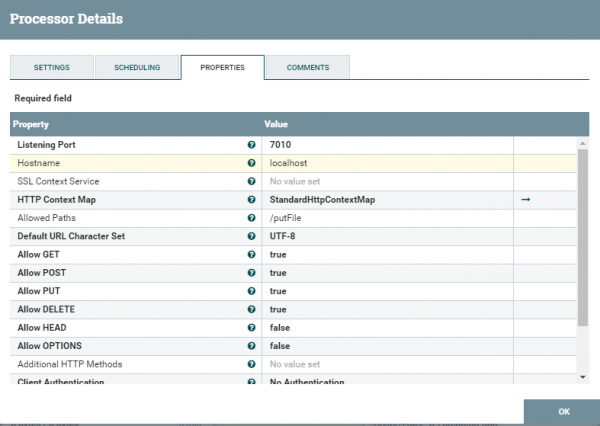
Aqui tudo é bastante trivial, exceto pelo StandartHttpContextMap — este é um serviço que permite enviar e receber solicitações. Você pode ver mais detalhadamente e até com exemplos —
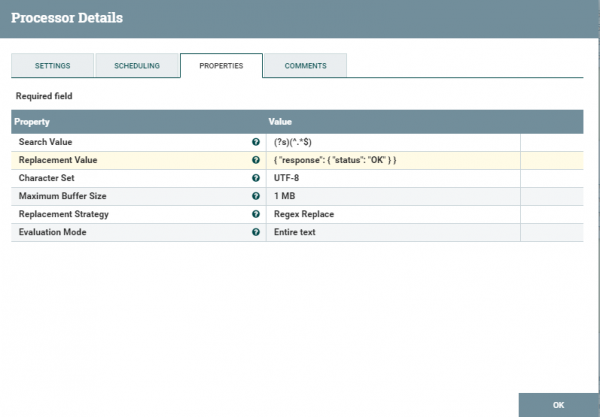
Em seguida, veremos os parâmetros de configuração do quadrado ReplaceText. É importante prestar atenção no ReplacementValue — que é o que retornará ao usuário na forma de resposta. Nas configurações, você pode regular o nível de log, os logs podem ser visualizados {onde descompactamos nifi}/nifi-1.9.2/logs, lá também existem os parâmetros failure/success — com base nesses parâmetros, você pode ajustar o processo como um todo. Ou seja, em caso de processamento bem-sucedido do texto — o processo de envio da resposta ao usuário será acionado, enquanto em outra situação, simplesmente registramos o processo não-sucedido.
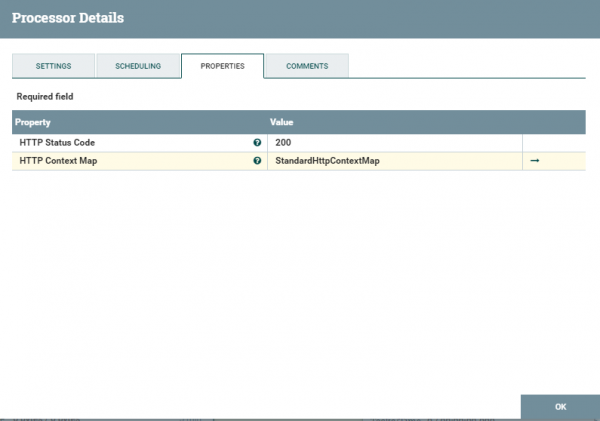
Nas propriedades do HandleHttpResponse, não há nada especialmente interessante, exceto o status ao criar a resposta com sucesso.
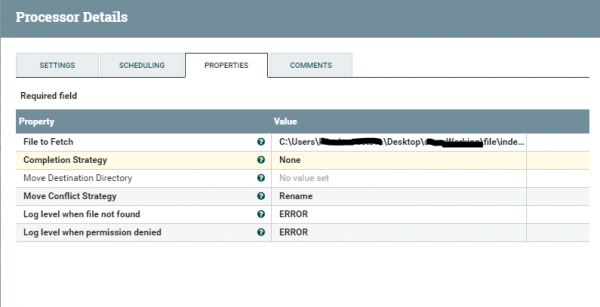
Com a solicitação e a resposta resolvidas — vamos prosseguir para a obtenção do arquivo e colocá-lo no servidor FTP. FetchFile — obtém o arquivo do caminho especificado nas configurações e o passa para o próximo processo.
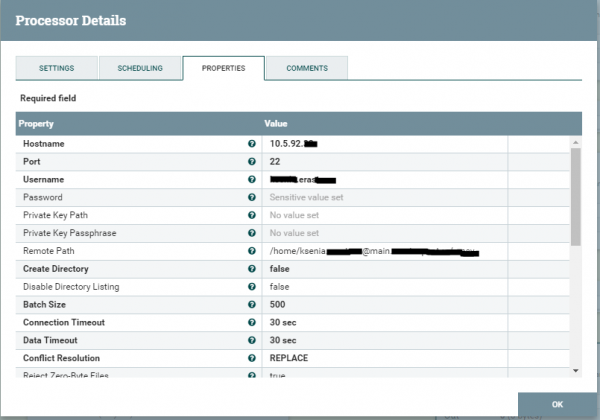
E o bloco PutSftp — coloca o arquivo no armazenamento de arquivos. Podemos ver as configurações abaixo.
Vale a pena notar que cada bloco é um processo separado que deve ser iniciado. Analisamos o exemplo mais simples que não requer nenhuma personalização complicada. A seguir, veremos um processo um pouco mais complexo, onde escreveremos um pouco em Groovy.
Um exemplo mais complexo
O serviço de transferência de dados para o consumidor se tornou um pouco mais complexo devido ao processo de modificação da mensagem SOAP. O processo geral é apresentado na imagem abaixo.
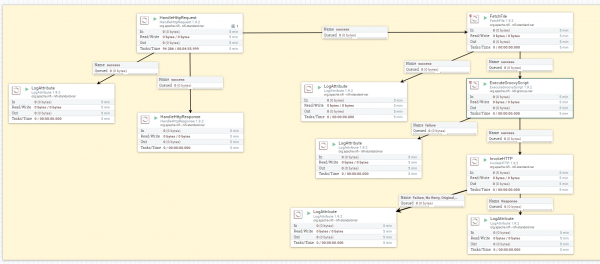
Aqui, a ideia também não é particularmente complexa: recebemos uma solicitação do consumidor de que ele precisa de dados, enviamos uma resposta informando que recebemos a mensagem, iniciamos o processo de obtenção do arquivo de resposta, editamos com uma lógica específica e, em seguida, transmitimos o arquivo ao consumidor na forma de uma mensagem SOAP no servidor.
Acho que não vale a pena descrever novamente os blocos que vimos acima — vamos direto para os novos. Se você precisar editar algum arquivo e blocos comuns como ReplaceText não forem suficientes, terá que escrever seu próprio script. Isso pode ser feito usando o bloco ExecuteGroovyScript. Suas configurações estão apresentadas abaixo.
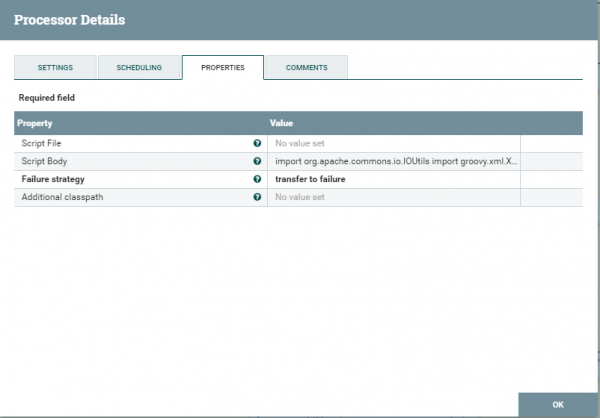
Existem duas opções para carregar o script neste quadrado. A primeira é carregando um arquivo com o script. A segunda é inserindo o script no scriptBody. Pelo que sei, o quadrado executeScript suporta várias linguagens de programação — uma delas é o groovy. Para desespero dos desenvolvedores Java — scripts em Java não podem ser escritos nesses quadrados. Para quem realmente deseja isso — é necessário criar seu próprio quadrado personalizado e inseri-lo no sistema NIFI. Toda essa operação é acompanhada de uma dança bastante longa, que não abordaremos neste artigo. Eu escolhi a linguagem groovy. Abaixo está um script de teste que simplesmente atualiza incrementalmente o ID em uma mensagem SOAP. É importante notar que você pega o arquivo do flowFile, atualiza-o e não deve esquecer de colocá-lo de volta, atualizado. Também é importante mencionar que nem todas as bibliotecas estão conectadas. Pode acontecer que você ainda tenha que importar uma das libs. Outro ponto negativo é que debugar o script nesse quadrado é bastante complicado. Existe uma maneira de se conectar à JVM NIFI e iniciar o processo de depuração. Pessoalmente, eu executei um aplicativo local e simulei a obtenção de um arquivo da sessão. A depuração também foi feita localmente. Os erros que surgem ao carregar o script são bastante fáceis de pesquisar e são registrados pelo próprio NIFI no log.
import org.apache.commons.io.IOUtils
import groovy.xml.XmlUtil
import java.nio.charset.*
import groovy.xml.StreamingMarkupBuilder

def flowFile = session.get()
if (!flowFile) return
try {
    flowFile = session.write(flowFile, { inputStream, outputStream ->
        String result = IOUtils.toString(inputStream, "UTF-8");
        def recordIn = new XmlSlurper().parseText(result)
        def element = recordIn.depthFirst().find {
            it.name() == 'id'
        }

        def newId = Integer.parseInt(element.toString()) + 1
        def recordOut = new XmlSlurper().parseText(result)
        recordOut.Body.ClientMessage.RequestMessage.RequestContent.content.MessagePrimaryContent.ResponseBody.id = newId

        def res = new StreamingMarkupBuilder().bind { mkp.yield recordOut }.toString()
        outputStream.write(res.getBytes(StandardCharsets.UTF_8))
} as StreamCallback)
     session.transfer(flowFile, REL_SUCCESS)
}
catch(Exception e) {
    log.error("Erro ao processar validate.groovy", e)
    session.transfer(flowFile, REL_FAILURE)
}
Na verdade, aqui termina a personalização do quadrado. O arquivo atualizado é então transferido para o quadrado que se encarrega de enviar o arquivo ao servidor. Abaixo estão as configurações deste quadrado.
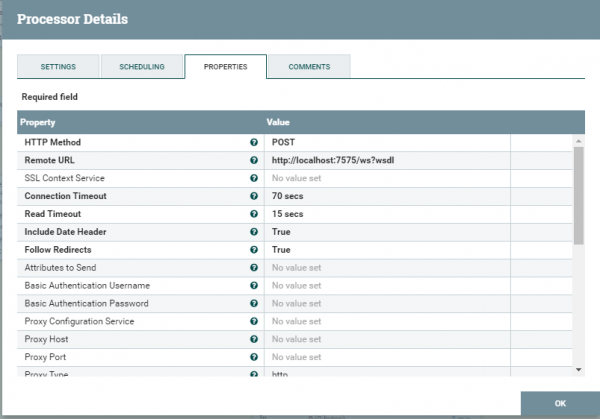
Descrevemos o método pelo qual a mensagem SOAP será enviada. Escrevemos para onde. Em seguida, é necessário indicar que é especificamente SOAP.
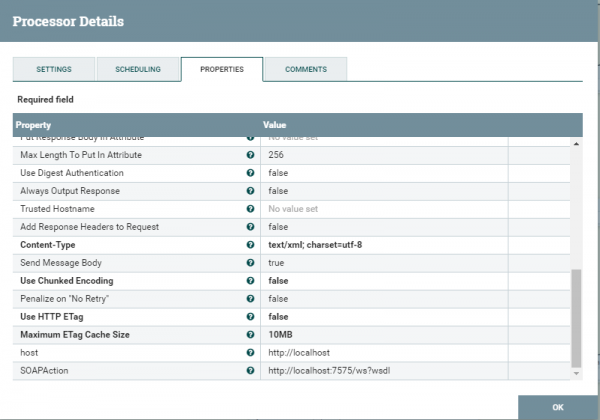
Adicionamos algumas propriedades como host e ação (soapAction). Salvamos e verificamos. Mais detalhes sobre como enviar solicitações SOAP podem ser encontrados.
Analisamos várias opções de uso dos processos NIFI. Como eles interagem e qual é seu valor real. Os exemplos discutidos são testes e diferem um pouco do que é realmente usado em produção. Espero que este artigo seja um pouco útil para os desenvolvedores. Obrigado pela atenção. Se houver alguma dúvida, escreva. Tentarei responder.
Fonte: habr.com
