

Muitos utilizam ferramentas especializadas para criar procedimentos de extração, transformação e carregamento de dados em bancos de dados relacionais. O processo de operação das ferramentas é registrado, e os erros são documentados.
Em caso de erro, o log contém informações sobre a falha da tarefa por parte da ferramenta e quais módulos (frequentemente é o Java) onde pararam. Nas últimas linhas, é possível encontrar o erro do banco de dados, como a violação de uma chave única da tabela.
Para responder à pergunta sobre qual o papel da informação de erros do ETL, classifiquei todos os problemas que ocorreram nos últimos dois anos em um grande armazém.
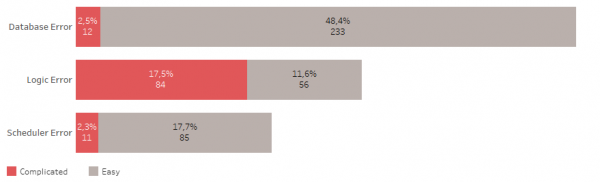
Os erros de banco de dados incluem problemas como falta de espaço, desconexão, sessão travada, entre outros.
Os erros lógicos incluem problemas como violação de chaves da tabela, objetos inválidos, falta de acesso a objetos, etc.
O agendador pode ser executado fora do horário, pode travar, entre outros.
Erros simples não requerem muito tempo para serem corrigidos. A maioria deles pode ser tratada automaticamente por um bom ETL.
Erros complexos exigem a abertura e verificação dos procedimentos de manipulação de dados, investigação das fontes de dados. Muitas vezes levam à necessidade de testagem de alterações e de implantação.
Assim, metade de todos os problemas está relacionada ao banco de dados. 48% de todos os erros são erros simples.
Um terço de todos os problemas está associado à alteração da lógica ou modelo do armazém, e mais da metade desses erros são complexos.
E menos de um quarto de todos os problemas está relacionado ao agendador de tarefas, dos quais 18% são erros simples.
No total, 22% de todos os erros ocorridos são complexos, e sua correção requer a maior atenção e tempo. Eles acontecem aproximadamente uma vez por semana, enquanto os erros simples ocorrem quase todos os dias.
É evidente que o monitoramento dos processos ETL será eficaz quando o log indicar com precisão o local do erro e exigir o menor tempo possível para localizar a fonte do problema.
Monitoramento Eficaz
O que eu gostaria de ver no processo de monitoramento do ETL?
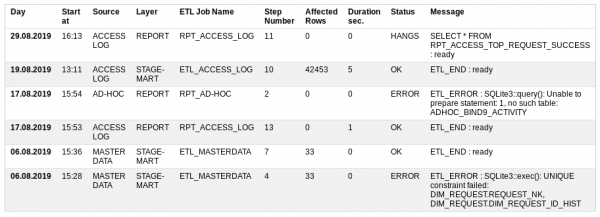
Início em — quando começou a operação,
Fonte — fonte de dados,
Camada — qual nível do armazém está sendo carregado,
Nome do Trabalho ETL — procedimento de carregamento que consiste em muitos pequenos passos,
Número do Passo — número do passo que está sendo executado,
Linhas Afetadas — quantos dados já foram processados,
Duração sec — quanto tempo está levando,
Status — se tudo está bem ou não: OK, ERRO, EXECUTANDO, PARADO
Mensagem — a última mensagem de sucesso ou descrição do erro.
Com base no status dos registros, é possível enviar um e-mail para outros participantes. Se não houver erros, o e-mail não é necessário.
Dessa forma, em caso de erro, o local do incidente está claramente indicado.
Às vezes ocorre que a própria ferramenta de monitoramento não funciona. Nesse caso, há a possibilidade de chamar diretamente a visualização no banco de dados, com base na qual o relatório foi gerado.
Tabela de monitoramento ETL
Para implementar o monitoramento de processos ETL, basta uma tabela e uma visualização.
Para isso, você pode voltar ao e criar um protótipo em um banco de dados sqlite.
DDL da tabela
CREATE TABLE UTL_JOB_STATUS (

/* Tabela para registro de log de execução de tarefa. Importante que a tarefa tenha os passos ETL_START e ETL_END ou ETL_ERROR */
  UTL_JOB_STATUS_ID INTEGER NOT NULL PRIMARY KEY AUTOINCREMENT,
  SID               INTEGER NOT NULL DEFAULT -1, /* Identificador de Sessão. Único para cada execução da tarefa */
  LOG_DT            INTEGER NOT NULL DEFAULT 0,  /* Data e hora */
  LOG_D             INTEGER NOT NULL DEFAULT 0,  /* Data */
  JOB_NAME          TEXT NOT NULL DEFAULT 'N/A', /* Nome da tarefa como JOB_STG2DM_GEO */
  STEP_NAME         TEXT NOT NULL DEFAULT 'N/A', /* ETL_START, ... , ETL_END/ETL_ERROR */
  STEP_DESCR        TEXT,                        /* Descrição da tarefa ou mensagem de erro */
  UNIQUE (SID, JOB_NAME, STEP_NAME)
);
INSERT INTO UTL_JOB_STATUS (UTL_JOB_STATUS_ID) VALUES (-1);
DDL da visualização/relatório
CRIE A VISÃO SE NÃO EXISTIR UTL_JOB_STATUS_V
COM
/* Conteúdo: Registro de Execução de Pacote dos últimos 3 Meses. */
COM SRC COMO (
  SELECIONE LOG_D,
    LOG_DT,
    UTL_JOB_STATUS_ID,
    SID,
	CASO QUANDO INSTR(JOB_NAME, 'FTP') ENTÃO 'TRANSFERÊNCIA' /* transferência de arquivo */
	     QUANDO INSTR(JOB_NAME, 'STG') ENTÃO 'ESTÁGIO' /* estágio */
	     QUANDO INSTR(JOB_NAME, 'CLS') ENTÃO 'LIMPEZA' /* limpeza */
	     QUANDO INSTR(JOB_NAME, 'DIM') ENTÃO 'DIMENSÃO' /* dimensão */
	     QUANDO INSTR(JOB_NAME, 'FCT') ENTÃO 'FATO' /* fato */
		 QUANDO INSTR(JOB_NAME, 'ETL') ENTÃO 'ESTÁGIO-MART' /* data mart */
	     QUANDO INSTR(JOB_NAME, 'RPT') ENTÃO 'RELATÓRIO' /* relatório */
	     OUTRO 'N/A' END AS CAMADA,
	CASO QUANDO INSTR(JOB_NAME, 'ACCESS') ENTÃO 'REGISTRO DE ACESSO' /* fonte */
	     QUANDO INSTR(JOB_NAME, 'MASTER') ENTÃO 'DADOS PRINCIPAIS' /* fonte */
	     QUANDO INSTR(JOB_NAME, 'AD-HOC') ENTÃO 'AD-HOC' /* fonte */
	     OUTRO 'N/A' END AS FONTE,
    JOB_NAME,
    STEP_NAME,
    CASO QUANDO STEP_NAME='ETL_START' ENTÃO 1 OUTRO 0 END AS INICIO_BANDEIRA,
    CASO QUANDO STEP_NAME='ETL_END' ENTÃO 1 OUTRO 0 END AS FIM_BANDEIRA,
    CASO QUANDO STEP_NAME='ETL_ERROR' ENTÃO 1 OUTRO 0 END AS ERRO_BANDEIRA,
    STEP_NAME || ' : ' || STEP_DESCR AS REGISTRO_DE_PASSO,
	SUBSTR( SUBSTR(STEP_DESCR, INSTR(STEP_DESCR, '***')+4), 1, INSTR(SUBSTR(STEP_DESCR, INSTR(STEP_DESCR, '***')+4), '***')-2 ) AS LINHAS_AFETADAS
  DE UTL_JOB_STATUS
  ONDE datetime(LOG_D, 'unixepoch') >= date('now', 'start of month', '-3 month')
)
SELECIONE JB.SID,
  JB.MIN_LOG_DT AS DATA_INICIO,
  strftime('%d.%m.%Y %H:%M', datetime(JB.MIN_LOG_DT, 'unixepoch')) AS LOG_DT,
  JB.FONTE,
  JB.CAMADA,
  JB.JOB_NAME,
  CASO
  QUANDO JB.ERROR_FLAG = 1 ENTÃO 'ERRO'
  QUANDO JB.ERROR_FLAG = 0 E JB.END_FLAG = 0 E strftime('%s','now') - JB.MIN_LOG_DT > 0.5*60*60 ENTÃO 'PARADO' /* meia hora */
  QUANDO JB.ERROR_FLAG = 0 E JB.END_FLAG = 0 ENTÃO 'EM EXECUÇÃO'
  OUTRO 'OK'
  FIM COMO STATUS,
  ERR.STEP_LOG     COMO REGISTRO_DE_PASSO,
  JB.CNT           COMO CONTAGEM_DE_PASSOS,
  JB.LINHAS_AFETADAS AS LINHAS_AFETADAS,
  strftime('%d.%m.%Y %H:%M', datetime(JB.MIN_LOG_DT, 'unixepoch')) AS DATA_INICIO_TRABALHO,
  strftime('%d.%m.%Y %H:%M', datetime(JB.MAX_LOG_DT, 'unixepoch')) AS DATA_FIM_TRABALHO,
  JB.MAX_LOG_DT - JB.MIN_LOG_DT COMO DURACAO_TRABALHO_SEC
DE
  ( SELECIONE SID, FONTE, CAMADA, JOB_NAME,
           MAX(UTL_JOB_STATUS_ID) AS UTL_JOB_STATUS_ID,
           MAX(INICIO_BANDEIRA)       AS INICIO_BANDEIRA,
           MAX(FIM_BANDEIRA)         AS FIM_BANDEIRA,
           MAX(ERRO_BANDEIRA)       AS ERRO_BANDEIRA,
           MIN(LOG_DT)           AS MIN_LOG_DT,
           MAX(LOG_DT)           AS MAX_LOG_DT,
           SUM(1)                AS CNT,
           SUM(IFNULL(LINHAS_AFETADAS, 0)) AS LINHAS_AFETADAS
    DE SRC
    GROUP BY SID, FONTE, CAMADA, JOB_NAME
  ) JB,
  ( SELECIONE UTL_JOB_STATUS_ID, SID, JOB_NAME, STEP_LOG
    DE SRC
    ONDE 1 = 1
  ) ERR
ONDE 1 = 1
  E JB.SID = ERR.SID
  E JB.JOB_NAME = ERR.JOB_NAME
  E JB.UTL_JOB_STATUS_ID = ERR.UTL_JOB_STATUS_ID
ORDENAR POR JB.MIN_LOG_DT DESC, JB.SID DESC, JB.FONTE;
Verificação SQL da possibilidade de obter um novo número de sessão
SELECIONE SOMA (
  CASO QUANDO start_job.JOB_NAME É NÃO NULO E end_job.JOB_NAME É NULO /* trabalho existente finalizado */
	    E NÃO ( 'y' = 'n' ) /* PARAMETRO de reinício forçado */
       ENTÃO 1 OUTRO 0
  FIM ) COMO ESTÁ_EXECUTANDO
  DE
    ( SELECIONE 1 COMO dummy DE UTL_JOB_STATUS ONDE sid = -1) d_job
  JUNÇÃO EXTERNA À ESQUERDA
    ( SELECIONE JOB_NAME, SID, 1 COMO dummy
      DE UTL_JOB_STATUS
      ONDE JOB_NAME = 'RPT_ACCESS_LOG' /* PARAMETRO de nome do trabalho */
	    E STEP_NAME = 'ETL_START'
      GROUP BY JOB_NAME, SID
    ) start_job /* começa */
  ON d_job.dummy = start_job.dummy
  JUNÇÃO EXTERNA À ESQUERDA
    ( SELECIONE JOB_NAME, SID
      DE UTL_JOB_STATUS
      ONDE JOB_NAME = 'RPT_ACCESS_LOG'  /* PARAMETRO de nome do trabalho */
	    E STEP_NAME IN ('ETL_END', 'ETL_ERROR') /* status de parada */
      GROUP BY JOB_NAME, SID
    ) end_job /* termina */
  ON start_job.JOB_NAME = end_job.JOB_NAME
     E start_job.SID = end_job.SID
Características da tabela:
- O início e o fim do processo de processamento de dados devem ser acompanhados pelos passos ETL_START e ETL_END
- Em caso de erro, deve-se criar o passo ETL_ERROR com sua descrição
- A quantidade de dados processados deve ser destacada, por exemplo, com asteriscos
- Ao mesmo tempo, o mesmo procedimento pode ser iniciado com o parâmetro force_restart=y; sem ele, o número da sessão é gerado apenas para o procedimento concluído
- No modo normal, não é possível iniciar paralelamente o mesmo procedimento de processamento de dados
As operações necessárias para trabalhar com a tabela são as seguintes:
- Obtenção do número da sessão do procedimento ETL em execução
- Inserção de registro de log na tabela
- Obtenção do último registro bem-sucedido do procedimento ETL
Em bancos de dados como Oracle ou Postgres, essas operações podem ser implementadas com funções integradas. Para sqlite, é necessário um mecanismo externo e, neste caso, ele .
Saída
Assim, as mensagens de erro nas ferramentas de processamento de dados desempenham um papel mega-importante. No entanto, é difícil considerá-las ideais para uma rápida identificação da causa do problema. Quando o número de procedimentos se aproxima de cem, o monitoramento dos processos se torna um projeto complicado.
O artigo apresenta um exemplo de possível solução para o problema na forma de um protótipo. Todo o protótipo de pequeno armazenamento está disponível no gitlab .
Fonte: habr.com
