

Em 2017, vencemos o concurso para o desenvolvimento do núcleo transacional do negócio de investimento do Alfa-Bank e começamos a trabalhar (na HighLoad++ 2018 com uma apresentação sobre o núcleo do negócio de investimento Vladimir Dryinkin, chefe da direção do núcleo transacional do negócio de investimento do Alfa-Bank). Este sistema deveria agregar dados sobre transações de diferentes fontes em vários formatos, unificar os dados, armazená-los e fornecer acesso a eles.
Durante o processo de desenvolvimento, o sistema evoluiu e ganhou funcionalidades, e em certo momento percebemos que estávamos cristalizando algo muito maior do que apenas um software aplicativo criado para resolver um conjunto específico de tarefas: nós obtivemos um sistema para construção de aplicações distribuídas com armazenamento persistente. A experiência que adquirimos foi a base para um novo produto — (TDG).
Quero falar sobre a arquitetura do TDG e sobre as soluções que encontramos durante o desenvolvimento, apresentar a vocês as principais funcionalidades e mostrar como nosso produto pode se tornar a base para a construção de soluções completas.
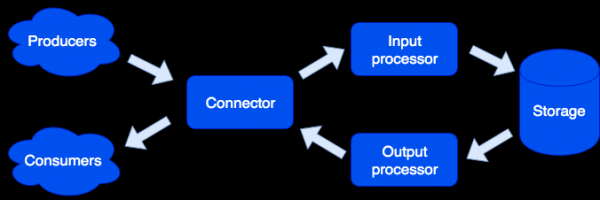
Arquitetonicamente, dividimos o sistema em componentes separados roles, cada um responsável pela solução de um conjunto específico de tarefas. Uma instância do aplicativo em execução implementa um ou vários tipos de papéis. Em um cluster, pode haver vários papéis de um mesmo tipo:
Connector
O Conector é responsável pela comunicação com o mundo externo; sua tarefa é receber uma solicitação, analisá-la e, se for bem-sucedido, enviar os dados para processamento no processador de entrada. Suportamos os formatos HTTP, SOAP, Kafka e FIX. A arquitetura permite fácil adição de suporte a novos formatos, e em breve teremos suporte ao IBM MQ. Se a análise da solicitação falhar, o conector retornará um erro; caso contrário, ele responderá que a solicitação foi processada com sucesso, mesmo que tenha ocorrido um erro durante seu processamento subsequente. Isso foi feito intencionalmente para trabalhar com sistemas que não sabem repetir solicitações - ou, inversamente, fazem isso de forma insistente demais. Para evitar a perda de dados, usamos uma fila de reparo: o objeto primeiro vai para ela e só é removido após o processamento bem-sucedido. O administrador pode receber notificações sobre objetos que permanecem na fila de reparo e, após corrigir um erro de software ou falha de hardware, tentar novamente.
Processador de entrada
O processador de entrada classifica os dados recebidos com base em características distintas e chama os manipuladores apropriados. Os manipuladores são códigos na linguagem Lua, executados em um sandbox, assim eles não podem afetar o funcionamento do sistema. Neste estágio, os dados podem ser convertidos para o formato necessário e, se necessário, pode-se iniciar um número arbitrário de tarefas que podem implementar a lógica necessária. Por exemplo, no produto MDM (Master Data Management), construído na Tarantool Data Grid, ao adicionar um novo usuário, para não atrasar o processamento da solicitação, criamos o registro mestre iniciando uma tarefa separada. O sandbox suporta solicitações de leitura, modificação e adição de dados, permite executar uma função em todos os papéis do tipo armazenamento e agregar o resultado (map/reduce).
Os manipuladores podem ser descritos em arquivos:
sum.lua

local x, y = unpack(...)
return x + y
E então, declarados na configuração:
functions:
  sum: { __file: sum.lua }
Por que Lua? Lua é uma linguagem muito simples. Com base em nossa experiência, após algumas horas de familiarização com ela, as pessoas começam a escrever código que resolve seus problemas. E isso não se aplica apenas a desenvolvedores profissionais, mas também, por exemplo, a analistas. Além disso, graças ao compilador jit, Lua opera muito rapidamente.
Storage
O armazenamento mantém dados persistentes. Antes de serem salvos, os dados passam pela validação conforme o esquema de dados. Para descrever o esquema, usamos um formato expandido. . Exemplo:
{
    "name": "User",
    "type": "record",
    "logicalType": "Aggregate",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "first_name", "type": "string"},
        {"name": "last_name", "type": "string"}
    ],
    "indexes": ["id"]
}
Com esta descrição, é gerado automaticamente o DDL (Data Definition Language) para o banco de dados Tarantool e o esquema para acesso aos dados.
A replicação de dados assíncrona é suportada (planejamos adicionar a sincrona).
Processador de saída
Às vezes, é necessário notificar consumidores externos sobre a entrada de novos dados, para isso existe a função de Processador de Saída. Após a salvaguarda dos dados, eles podem ser enviados para o manipulador correspondente (por exemplo, para transformá-los no formato exigido pelo consumidor) — e, em seguida, enviados ao conector para envio. Aqui também é utilizada uma fila de reparo: se o objeto não for aceito, o administrador pode tentar novamente mais tarde.
Escalabilidade
As funções de conector, processador de entrada e processador de saída não têm estado, o que nos permite escalar o sistema horizontalmente, simplesmente adicionando novas instâncias do aplicativo com a função necessária ativada. Para a escalabilidade horizontal, o armazenamento utiliza para organização do cluster utilizando buckets virtuais. Após adicionar um novo servidor, parte dos buckets dos servidores antigos é transferida em segundo plano para o novo servidor; isso ocorre de forma transparente para os usuários e não impacta na operação do sistema como um todo.
Propriedades dos dados
Os objetos podem ser muito grandes e conter outros objetos. Garantimos a atomicidade de adição e atualização de dados, mantendo o objeto com todas as dependências em um único bucket virtual. Assim, evitamos a "dispersão" do objeto por vários servidores físicos.
O suporte a versionamento significa que cada atualização de um objeto cria uma nova versão, e sempre podemos fazer um corte temporal e ver como o mundo era naquela época. Para dados que não necessitam de uma longa história, podemos limitar o número de versões ou até mesmo manter apenas uma — a mais recente, o que efetivamente desativa o versionamento para um determinado tipo. Também é possível limitar a história por tempo: por exemplo, remover todos os objetos de um certo tipo com mais de 1 ano. O suporte à arquivação também está disponível: podemos exportar objetos mais antigos que um determinado período, liberando espaço no cluster.
Tarefas
Entre as funções interessantes, destaca-se a possibilidade de executar tarefas agendadas, sob demanda do usuário ou programaticamente a partir do sandbox:
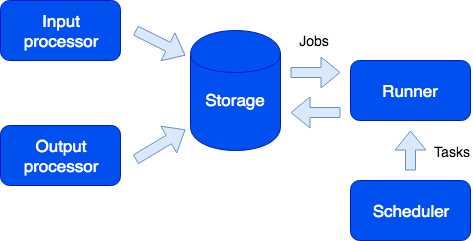
Aqui vemos mais um papel — o runner. Esse papel não tem estado, e se necessário, podem ser adicionadas instâncias adicionais do aplicativo a esse cluster. A responsabilidade do runner é executar tarefas. Como mencionado, a partir do sandbox é possível gerar novas tarefas; elas são armazenadas na fila do storage e depois executadas no runner. Esse tipo de tarefa é chamado de Job. Temos também um tipo de tarefa chamado Task — estas são tarefas definidas pelo usuário e agendadas (usando a sintaxe cron) ou executadas sob demanda. Para iniciar e monitorar tais tarefas, temos um gerenciador de tarefas conveniente. Para que essa funcionalidade esteja disponível, é necessário habilitar o papel scheduler; esse papel tem estado, portanto não é escalável, o que, aliás, não é necessário; no entanto, assim como todos os outros papéis, pode ter uma réplica que começa a funcionar se o mestre falhar.
Logger
Outro papel chamado logger coleta logs de todos os membros do cluster e fornece uma interface para exportação e visualização através da interface web.
Serviços
Vale mencionar que o sistema permite a criação fácil de serviços. No arquivo de configuração, você pode especificar quais solicitações direcionar para o manipulador personalizado, que será executado no sandbox. Nesse manipulador, por exemplo, você pode executar uma consulta analítica e retornar o resultado.
O serviço é descrito no arquivo de configuração:
services:
   sum:
      doc: "soma dois números"
      function: sum
      return_type: int
      args:
         x: int
         y: int
A API GraphQL é gerada automaticamente e o serviço fica disponível para chamadas:
query {
   sum(x: 1, y: 2)
}
Isso resultará na chamada do manipulador sum, que retornará o resultado:
3
Perfilamento de consultas e métricas
Para entender o funcionamento do sistema e o perfilamento de consultas, implementamos suporte ao protocolo OpenTracing. O sistema pode, sob demanda, enviar informações para ferramentas que suportam esse protocolo, como o Zipkin, permitindo investigar como a consulta foi executada:
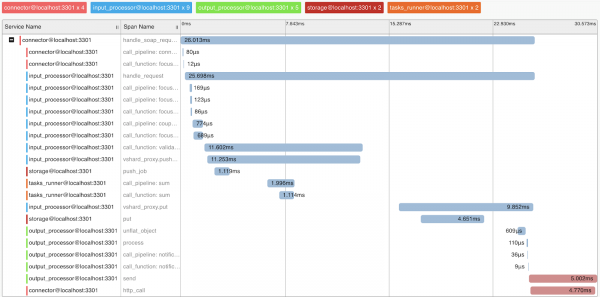
Naturalmente, o sistema fornece métricas internas que podem ser coletadas usando o Prometheus e visualizadas com o Grafana.
Deploy
O Tarantool Data Grid pode ser implantado a partir de pacotes RPM ou um arquivo zip, utilizando a ferramenta fornecida ou Ansible, e também há suporte para Kubernetes ().
O aplicativo que implementa a lógica de negócios (configuração, manipuladores) é carregado no cluster Tarantool Data Grid implantado na forma de um arquivo zip através da interface do usuário ou com um script, utilizando nossa API fornecida.
Exemplos de aplicativos
Quais aplicativos podem ser criados com o Tarantool Data Grid? Na verdade, a maioria das tarefas comerciais está, de alguma forma, relacionada ao processamento de fluxos de dados, armazenamento e acesso a eles. Portanto, se você tem grandes fluxos de dados que precisam ser armazenados de maneira confiável e acessíveis, nosso produto pode economizar muito tempo no desenvolvimento e permitir que você se concentre na sua lógica de negócios.
Por exemplo, queremos coletar informações sobre o mercado imobiliário, para posteriormente, por exemplo, ter informações sobre as melhores ofertas. Nesse caso, destacaremos as seguintes tarefas:
- Robôs que coletam informações de fontes abertas — essas serão nossas fontes de dados. Essa tarefa pode ser resolvida utilizando soluções prontas ou escrevendo código em qualquer linguagem.
- Em seguida, o Tarantool Data Grid receberá e armazenará os dados. Se o formato dos dados de diferentes fontes diferir, você pode escrever código em Lua que realizará a conversão para um formato único. Na fase de pré-processamento, você também poderá, por exemplo, filtrar ofertas duplicadas ou atualizar informações sobre os agentes atuantes no mercado, no banco de dados.
- Agora você já tem uma solução escalável em cluster, que pode ser alimentada com dados e realizar consultas. Em seguida, você pode implementar novas funcionalidades, como criar um serviço que faça uma consulta aos dados e ofereça a proposta mais vantajosa do dia — isso exigirá algumas linhas no arquivo de configuração e um pouco de código em Lua.
E agora?
Nossa prioridade é aumentar a conveniência do desenvolvimento através de . Por exemplo, uma IDE com suporte a perfilagem e depuração de manipuladores que funcionam em sandbox.
Também damos grande atenção às questões de segurança. Neste momento, estamos passando pela certificação do FSTEC da Rússia para confirmar o alto nível de segurança e atender aos requisitos de certificação dos produtos de software utilizados em sistemas de informações de dados pessoais e sistemas de informações governamentais.
Fonte: habr.com
