

Fonte:
A regressão linear é um dos algoritmos básicos para muitas áreas relacionadas à análise de dados. A razão é evidente. É um algoritmo muito simples e compreensível, o que contribui para sua ampla aplicação há muitas décadas, senão centenas de anos. A ideia é que supomos uma dependência linear de uma variável em relação a um conjunto de outras variáveis e, em seguida, tentamos restaurar essa dependência.
Mas este artigo não se concentrará na aplicação da regressão linear para resolver problemas práticos. Aqui serão discutidas características interessantes da implementação de algoritmos distribuídos para sua restauração, com as quais nos deparamos ao escrever o módulo de aprendizado de máquina em . Um pouco de matemática básica, fundamentos de aprendizado de máquina e computação distribuída ajudarão a entender como restaurar a regressão linear, mesmo que os dados estejam distribuídos entre milhares de nós.
Do que se trata?
Temos a tarefa de restaurar uma dependência linear. Como dados de entrada, temos um conjunto de vetores de variáveis presumivelmente independentes, a cada um dos quais é atribuído um determinado valor de variável dependente. Esses dados podem ser representados na forma de duas matrizes:

Agora, uma vez que se presume uma dependência, e ainda por cima linear, vamos escrever nossa suposição na forma de um produto de matrizes (para simplificar a anotação, aqui e adiante, supõe-se que o termo livre da equação está oculto atrás de  , e a última coluna da matriz
 contém uns):

Muito parecido com um sistema de equações lineares, não é? Parece, mas é provável que essa sistema não tenha soluções. A razão para isso é o ruído, que está presente em praticamente todos os dados reais. Também pode ser a ausência de uma dependência linear como tal, pela qual se pode tentar lutar introduzindo variáveis adicionais que dependam de forma não linear das variáveis originais. Vamos considerar o seguinte exemplo:
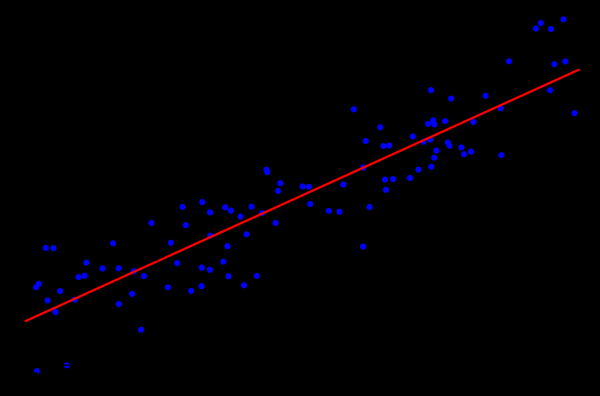
Fonte:
Este é um exemplo simples de regressão linear que demonstra a dependência de uma variável (no eixo  ) em relação a outra variável (no eixo
 ). Para que o sistema de equações lineares correspondente a este exemplo tenha uma solução, todos os pontos devem estar exatamente em uma única linha. Mas isso não acontece. E não estão em uma única linha exatamente por causa do ruído (ou porque a suposição de dependência linear foi incorreta). Assim, para restaurar a dependência linear a partir de dados reais, geralmente é necessário introduzir mais uma suposição: os dados de entrada contêm ruído e esse ruído tem . Pode-se fazer suposições sobre outros tipos de distribuição de ruído, mas na grande maioria dos casos considera-se exatamente a distribuição normal, que será abordada a seguir.
Método de máxima verossimilhança
Então, supomos a presença de ruído aleatório com distribuição normal. O que fazer nessa situação? Para isso, na matemática existe e é amplamente utilizado . Resumindo, sua essência consiste em escolher e posteriormente maximizá-la.
Voltando à restauração da dependência linear a partir de dados com ruído normal. Observe que a dependência linear suposta é o valor esperado  da distribuição normal existente. Ao mesmo tempo, a probabilidade de que
 assuma um determinado valor, dado a presença de observações
 , se parece com o seguinte:

Agora, substituímos  e
 as variáveis que precisamos:

Resta apenas encontrar o vetor  , para o qual essa probabilidade é máxima. Para maximizar essa função, é conveniente primeiro logaritmizar (o logaritmo da função atinge o máximo no mesmo ponto que a própria função):

O que, por sua vez, se reduz à minimização da seguinte função:

A propósito, isso é chamado de método . Muitas vezes, todas as considerações acima são omitidas e este método é simplesmente utilizado.
Decomposição QR
O mínimo da função mencionada acima pode ser encontrado ao localizarmos um ponto onde o gradiente dessa função é igual a zero. O gradiente será registrado da seguinte forma:

é um método matricial para resolver problemas de minimização utilizado no método dos mínimos quadrados. Em vista disso, reescrevemos a equação na forma matricial:

Portanto, estamos decompondo a matriz  em matrizes
 e
 e realizamos uma série de transformações (o algoritmo QR de decomposição não será discutido aqui, apenas seu uso em relação à tarefa proposta):

Matriz  é ortogonal. Isso nos permite nos livrarmos do produto
 :

E se substituirmos  para
 , teremos
 . Considerando que
 é uma matriz triangular superior, isso se apresenta da seguinte forma:

Isso pode ser resolvido pelo método da substituição. O elemento  é encontrado como
 , o elemento anterior
 é encontrado como
 e assim por diante.
Aqui cabe destacar que a complexidade do algoritmo resultante devido ao uso da decomposição QR é igual a  . Embora a operação de multiplicação de matrizes possa ser bem paralelizada, escrever uma versão distribuída eficiente deste algoritmo não é viável.
Descida do gradiente
Ao falar sobre a minimização de uma certa função, sempre vale a pena lembrar do método (estocástico) de descida do gradiente. Este é um método simples e eficaz de minimização, baseado no cálculo iterativo do gradiente da função em um ponto e no subsequente deslocamento na direção oposta ao gradiente. Cada passo assim aproxima a solução do mínimo. O gradiente continua a ser o mesmo:

Além disso, esse método se paraleliza e se distribui bem devido às propriedades lineares do operador gradiente. Observemos que na fórmula apresentada acima, sob o sinal de soma, estão os termos independentes. Em outras palavras, podemos calcular o gradiente de forma independente para todos os índices  do primeiro até
 , enquanto paralelamente calculamos o gradiente para os índices de
 até
 . Então, somamos os gradientes obtidos. O resultado da soma será o mesmo como se tivéssemos calculado imediatamente o gradiente para os índices do primeiro até
 . Assim, se os dados estiverem distribuídos entre várias partes, o gradiente pode ser calculado independentemente em cada parte, e então os resultados desses cálculos podem ser somados para obter o resultado final:

Do ponto de vista da implementação, isso se encaixa na paradigma . A cada passo da descida do gradiente, uma tarefa é enviada para cada nó de dados para calcular o gradiente, em seguida, os gradientes calculados são reunidos, e o resultado de sua soma é usado para melhorar o resultado.
Apesar da simplicidade de implementação e da possibilidade de execução na paradigma MapReduce, o método do gradiente apresenta suas desvantagens. Em particular, o número de passos necessário para alcançar a convergência é significativamente maior em comparação a outros métodos mais especializados.
LSQR
— é outro método de resolução do problema proposto, que serve tanto para a recuperação de regressão linear quanto para a resolução de sistemas de equações lineares. Sua principal característica é que combina as vantagens dos métodos matriciais e da abordagem iterativa. Implementações deste método podem ser encontradas nas bibliotecas , quanto em . A descrição deste método não será apresentada aqui (pode ser encontrada no artigo ). Em vez disso, será demonstrada uma abordagem que permite adaptar o LSQR para execução em ambiente distribuído.
A base do método LSQR é . Este é um procedimento iterativo, em que cada iteração consiste nos seguintes passos:
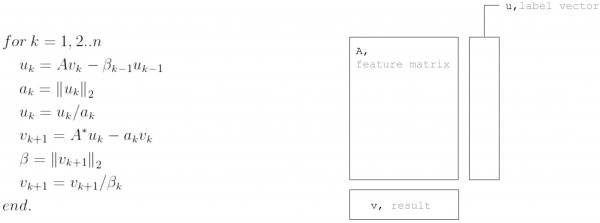
Mas se considerarmos que a matriz  é particionada horizontalmente, cada iteração pode ser apresentada sob a forma de dois passos MapReduce. Assim, é possível minimizar a troca de dados durante cada uma das iterações (apenas vetores com comprimento igual ao número de incógnitas):
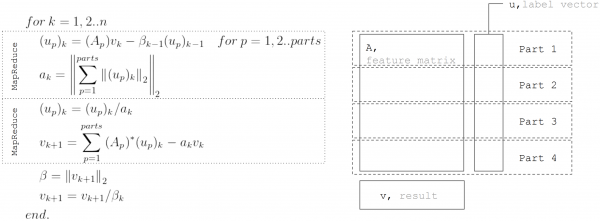
Esta abordagem é usada na implementação da regressão linear em .
Conclusão
Existem muitos algoritmos para a recuperação de regressão linear, mas nem todos podem ser aplicados em quaisquer condições. O QR fatoração é excelente para soluções exatas em pequenos conjuntos de dados. O método do gradiente é fácil de implementar e permite encontrar rapidamente uma solução aproximada. O LSQR combina as melhores propriedades dos dois métodos anteriores, pois pode ser distribuído, converge mais rapidamente em comparação ao gradiente, e também permite a interrupção prematura do algoritmo, ao contrário da fatoração QR para a busca de uma solução aproximada.
Fonte: habr.com
