

Até recentemente, no Odnoklassniki, cerca de 50 TB de dados processados em tempo real eram armazenados no SQL Server. Para tal volume, garantir acesso rápido, confiável e também à prova de falhas ao datacenter usando um SGBD SQL é praticamente impossível. Normalmente, em tais casos, utiliza-se um dos armazenamentos NoSQL, mas nem tudo pode ser transferido para NoSQL: algumas entidades exigem garantias de transações ACID.
Isso nos levou ao uso de um armazenamento NewSQL, ou seja, um SGBD que oferece resistência a falhas, escalabilidade e desempenho de sistemas NoSQL, mas mantendo as garantias ACID familiares dos sistemas clássicos. Há poucas soluções industriais em funcionamento dessa nova classe, portanto, nós mesmos implementamos tal sistema e o colocamos em operação industrial.
Como isso funciona e o que conseguimos — leia mais abaixo.
Hoje, a audiência mensal do 'Odnoklassniki' é de mais de 70 milhões de visitantes únicos. Nós maiores redes sociais do mundo, e no vigésimo lugar entre os sites onde os usuários passam mais tempo. A infraestrutura do 'OK' lida com cargas muito altas: mais de um milhão de solicitações HTTP por segundo nas frentes. Partes do parque de servidores, totalizando mais de 8000 unidades, estão localizadas próximas umas das outras — em quatro data centers em Moscovo, o que permite garantir uma latência de rede inferior a 1 ms entre eles.
Utilizamos Cassandra desde 2010, começando pela versão 0.6. Hoje, estão em operação várias dezenas de clusters. O cluster mais rápido processa mais de 4 milhões de operações por segundo, e o maior armazena 260 TB.
No entanto, todos são clusters NoSQL comuns, usados para armazenar Queríamos substituir o principal armazenamento consistente, Microsoft SQL Server, que era utilizado desde a fundação do 'Odnoklassniki'. O armazenamento consistia em mais de 300 máquinas SQL Server Standard Edition, que continham 50 TB de dados — entidades de negócios. Esses dados são modificados no contexto de transações ACID e exigem .
Para distribuir dados entre os nós do SQL Server, utilizamos tanto a partição vertical quanto a horizontal. (sharding). Historicamente, utilizamos um esquema simples de sharding de dados: a cada entidade foi atribuído um token - uma função baseada na ID da entidade. Entidades com o mesmo token eram colocadas no mesmo servidor SQL. A relação do tipo mestre-detalhe era implementada de forma que os tokens do registro principal e do registro gerado sempre coincidissem e estivessem no mesmo servidor. Em uma rede social, quase todos os registros são gerados em nome do usuário - isso significa que todos os dados do usuário dentro de um subsistema funcional são armazenados em um único servidor. Ou seja, em uma transação de negócios, quase sempre estavam envolvidos apenas tabelas de um único servidor SQL, o que permitia garantir a consistência dos dados por meio de transações ACID locais, sem necessidade de utilizar Graças ao sharding e para acelerar o trabalho do SQL:
Não utilizamos restrições de chave estrangeira, pois no sharding a ID da entidade pode estar em outro servidor.
- Não utilizamos procedimentos armazenados e gatilhos devido à carga adicional na CPU do SGBD.
- Não utilizamos JOINs devido ao que foi mencionado acima e à grande quantidade de leituras aleatórias do disco.
- Fora das transações, para reduzir bloqueios, usamos o nível de isolamento Read Uncommitted.
- Executamos apenas transações curtas (em média, de menos de 100 ms).
- Não utilizamos UPDATE e DELETE em múltiplas linhas devido ao alto número de bloqueios - atualizamos apenas um registro de cada vez.
- As consultas sempre são executadas apenas por índices - uma consulta com um plano de visualização completa da tabela significa sobrecarga do banco de dados e sua falha.
- Essas etapas permitiram extrair quase o máximo de desempenho dos servidores SQL. No entanto, os problemas estavam se tornando cada vez mais frequentes. Vamos analisá-los.
Problemas com SQL
Como utilizamos sharding feito à mão, a adição de novos shards era feita manualmente pelos administradores. Durante todo esse tempo, cópias escaláveis de dados não atendiam às solicitações.
- À medida que o número de registros na tabela crescia, a velocidade de inserção e modificação diminuía; ao adicionar índices a uma tabela existente, a velocidade caía drasticamente, e a criação e recreação de índices aconteciam com tempo de inatividade.
- A presença de um número limitado de Windows para SQL Server na produção dificulta a gestão da infraestrutura.
- Mas o principal problema é -
Mas o principal problema é
Resiliência
Um um servidor SQL clássico tem uma baixa disponibilidade. Suponha que você tenha apenas um servidor de banco de dados, e ele falhe a cada três anos. Nesse período, o site fica fora do ar por 20 minutos, o que é aceitável. Se você tiver 64 servidores, o site fica fora do ar a cada três semanas. E se você tiver 200 servidores, o site fica fora do ar toda semana. Esse é um problema.
O que pode ser feito para aumentar a disponibilidade do servidor SQL? A Wikipédia nos sugere construir : onde, em caso de falha de qualquer um dos componentes, há um substituto.
Isso exige um parque de equipamentos caros: muita duplicação, fibra óptica, armazenamento compartilhado, e a ativação de um backup é pouco confiável: cerca de 10% das ativações resultam na falha da nodem reserva em cascata em relação à nodem principal.
Mas a principal desvantagem de um cluster de alta disponibilidade é a ausência total de disponibilidade em caso de falha do data center no qual ele está localizado. O 'Odноклассники' tem quatro data centers, e precisamos garantir operação em caso de falha total em um deles.
Para isso, poderíamos aplicar embutida no SQL Server. Esta solução é significativamente mais cara devido ao custo do software e sofre de problemas bem conhecidos de replicação — atrasos imprevisíveis nas transações durante replicação síncrona e atrasos na aplicação das replicações (e, como consequência, modificações perdidas) durante a replicação assíncrona. O que implica torna essa opção completamente inviável para nós.
Todos esses problemas exigiam uma solução radical e começamos uma análise detalhada. Aqui, precisamos nos familiarizar com o que o SQL Server faz principalmente — transações.
Transação simples
Consideremos a mais simples, do ponto de vista de um programador SQL prático: adicionar uma foto a um álbum. Álbum e fotos são armazenados em tabelas diferentes. O álbum possui um contador de fotos públicas. Então, essa transação se divide nos seguintes passos:
- Bloqueamos o álbum pela chave.
- Criamos um registro na tabela de fotos.
- Se a foto tiver status público, então incrementamos o contador de fotos públicas no álbum, atualizamos o registro e comitamos a transação.
Ou na forma de pseudocódigo:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Observamos que o cenário de transação de negócios mais comum é ler dados do banco de dados na memória do servidor de aplicativos, fazer algumas alterações e salvar os novos valores de volta no banco de dados. Normalmente, em tal transação, atualizamos várias entidades, várias tabelas.
Durante a execução da transação, pode ocorrer a modificação concorrente dos mesmos dados a partir de outro sistema. Por exemplo, um sistema anti-spam pode decidir que um usuário é suspeito e, portanto, todas as fotos do usuário não devem mais ser públicas, elas precisam ser enviadas para moderação, o que significa alterar photo.status para algum outro valor e reverter os contadores correspondentes. É evidente que, se essa operação ocorrer sem garantias de atomicidade e isolamento das modificações concorrentes, como em , o resultado não será o necessário — ou o contador de fotos mostrará um valor incorreto, ou nem todas as fotos serão enviadas para moderação.
Tal código, manipulando várias entidades de negócios dentro de uma única transação, foi escrito em grande quantidade durante toda a existência da plataforma. Por meio de experiências de migração para NoSQL com , sabemos que as maiores dificuldades (e gastos de tempo) estão relacionadas à necessidade de desenvolver código que mantenha a consistência dos dados. Portanto, a principal exigência para o novo armazenamento foi garantir que a lógica de aplicação suporte verdadeiras transações ACID.
Outras exigências igualmente importantes foram:
- Em caso de falha do data center, a leitura e a gravação no novo armazenamento devem estar disponíveis.
- Manter a velocidade atual de desenvolvimento. Ou seja, ao trabalhar com o novo armazenamento, a quantidade de código deve ser aproximadamente a mesma, não deve haver necessidade de adicionar nada ao armazenamento, desenvolver algoritmos de resolução de conflitos, manter índices secundários, etc.
- A velocidade de operação do novo armazenamento deve ser suficientemente alta, tanto na leitura de dados quanto no processamento de transações, o que significa efetivamente que soluções acadêmicas rigorosas, universais, mas lentas, como, por exemplo, .
- Escalabilidade automática em tempo real.
- Uso de servidores comuns e acessíveis, sem a necessidade de comprar equipamentos exóticos.
- Capacidade de expandir o armazenamento com os esforços dos desenvolvedores da empresa. Em outras palavras, a prioridade era dada a soluções próprias ou baseadas em código aberto, preferencialmente em Java.
Soluções, soluções
Analisando as possíveis soluções, chegamos a duas opções de arquitetura:
Primeira — utilizar qualquer servidor SQL e implementar a resiliência necessária, o mecanismo de escalabilidade, cluster resistente a falhas, resolução de conflitos e transações ACID distribuídas, confiáveis e rápidas. Avaliamos essa opção como bastante não trivial e trabalhosa.
A segunda opção — adotar um repositório NoSQL pronto, com escalabilidade implementada, cluster resistente a falhas, resolução de conflitos e implementar transações e SQL por conta própria. À primeira vista, a tarefa de implementar SQL, sem mencionar as transações ACID, parece um desafio que levará anos. Mas depois percebemos que o conjunto de funcionalidades SQL que usamos na prática está longe do ANSI SQL, assim como está longe do ANSI SQL. Ao olhar com mais atenção para o CQL, percebemos que ele se aproxima bastante do que precisamos.
Cassandra e CQL
Então, o que torna o Cassandra interessante e quais recursos ele possui?
Em primeiro lugar, é possível criar tabelas com suporte a diversos tipos de dados, e é possível fazer SELECT ou UPDATE pela chave primária.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
Para garantir a consistência dos dados das réplicas, o Cassandra utiliza . No caso mais simples, isso significa que, ao colocar três réplicas da mesma linha em diferentes nós do cluster, a gravação é considerada bem-sucedida se a maioria dos nós (ou seja, duas de três) confirmou o sucesso dessa operação de gravação. Os dados da linha são considerados consistentes se, ao serem lidos, a maioria dos nós foram questionados e confirmaram isso. Assim, com três réplicas, garante-se uma consistência total e instantânea dos dados em caso de falha de um nó. Essa abordagem nos permitiu implementar um esquema ainda mais confiável: sempre enviar solicitações a todas as três réplicas, aguardando a resposta das duas mais rápidas. A resposta atrasada da terceira réplica é, nesse caso, descartada. O nó que atrasou a resposta pode ter sérios problemas — lentidão, coleta de lixo na JVM, recuperação de memória direta no kernel do Linux, falhas de hardware, desconexão da rede. No entanto, isso não afeta a operação do cliente nem os dados.
A abordagem em que consultamos três nós, recebendo a resposta de dois, é chamada : a solicitação para réplicas extras é enviada antes de 'cair'.
Outra das vantagens do Cassandra é o Batchlog — um mecanismo que garante a aplicação completa ou a não aplicação total do pacote de alterações que você faz. Isso nos permite resolver o A em ACID — atomicidade de forma nativa.
O mais próximo das transações no Cassandra são as chamadas ''. Mas estão longe das 'verdadeiras' transações ACID: na verdade, isso é a possibilidade de fazer um nos dados apenas de um único registro, utilizando um consenso pelo pesado protocolo Paxos. Portanto, a velocidade dessas transações não é alta.
O que nos faltou no Cassandra
Assim, precisávamos implementar transações ACID reais no Cassandra. Com as quais poderíamos facilmente implementar duas outras funcionalidades úteis dos DBMS clássicos: índices rápidos consistentes, o que nos permitiria realizar consultas de dados não apenas pela chave primária e um gerador comum de IDs auto-incrementais monotônicos.
C*One
Assim nasceu um novo SGBD C*One, composto por três tipos de nós de servidor:
- Armazenadores — servidores Cassandra (quase) padrão, responsáveis pela armazenamento de dados em discos locais. À medida que a carga e o volume de dados aumentam, seu número pode ser facilmente escalonado para dezenas e centenas.
- Os coordenadores de transações garantem a execução das transações.
- Os clientes são servidores de aplicativos que realizam operações comerciais e iniciam transações. Pode haver milhares desses clientes.
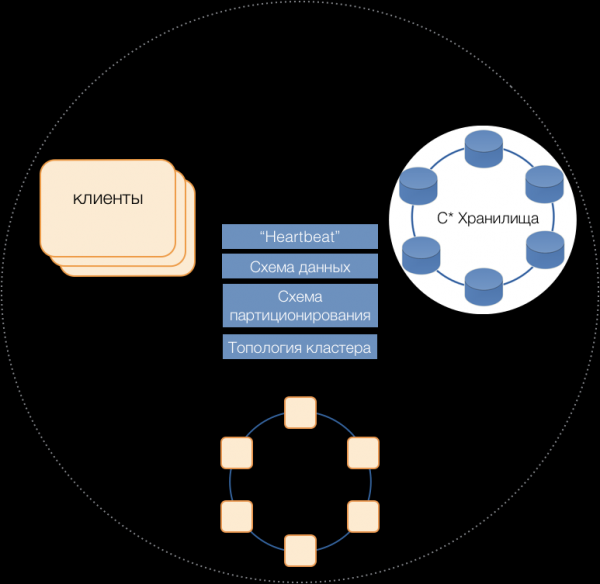
Servidores de todos os tipos fazem parte de um cluster comum, utilizam o protocolo de mensagens interno Cassandra para se comunicarem entre si e para trocar informações de cluster. Através do Heartbeat, os servidores detectam falhas mútuas, mantêm um esquema de dados unificado — tabelas, sua estrutura e replicação; esquema de particionamento, topologia do cluster, etc.
Clientes
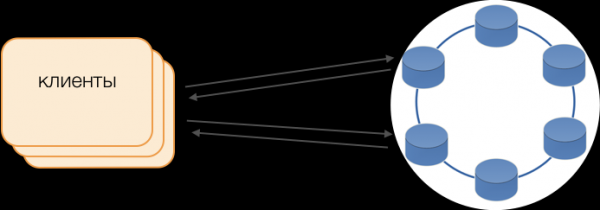
Em vez de drivers padrão, utiliza-se o modo Fat Client. Esse nó não armazena dados, mas pode atuar como coordenador da execução de solicitações, ou seja, o Cliente mesmo desempenha a função de coordenador de suas solicitações: interroga as réplicas do armazenamento e resolve conflitos. Isso não apenas é mais confiável e rápido do que o driver padrão, que exige comunicação com um coordenador remoto, mas também permite gerenciar a transmissão de solicitações. Fora de uma transação aberta pelo cliente, as solicitações são direcionadas para os armazenamentos. Se o cliente abriu uma transação, todas as solicitações dentro da transação são direcionadas para o coordenador de transações.
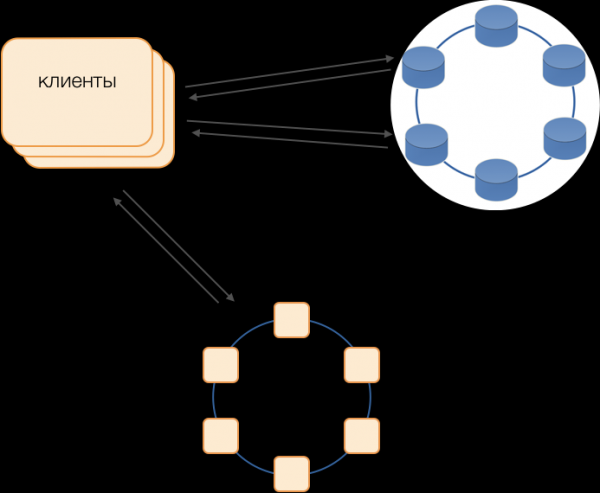
Coordenador de transações C*One
Coordenador é o que implementamos para o C*One do zero. Ele é responsável pela gestão de transações, bloqueios e ordem de aplicação das transações.
Para cada transação atendida, o coordenador gera um timestamp: cada um subsequente é maior do que o anterior. Como no Cassandra o sistema de resolução de conflitos é baseado em timestamps (das duas entradas conflitantes, considera-se a de timestamp mais recente como válida), o conflito sempre será resolvido a favor da transação subsequente. Assim, implementamos — uma forma econômica de resolução de conflitos em um sistema distribuído.
Bloqueios
Para garantir isolamento, decidimos usar a maneira mais simples — bloqueios pessimistas pela chave primária do registro. Em outras palavras, em uma transação, o registro deve ser bloqueado primeiro, e só então pode ser lido, modificado e salvo. Apenas após um commit bem-sucedido o registro pode ser desbloqueado, permitindo que transações concorrentes possam utilizá-lo.
A implementação desse bloqueio é simples em um ambiente não distribuído. Em um sistema distribuído, existem dois caminhos principais: implementar um bloqueio distribuído no cluster ou distribuir as transações de modo que as transações envolvendo um único registro sejam sempre atendidas pelo mesmo coordenador.
Como, no nosso caso, os dados já estão distribuídos em grupos de transações locais no SQL, decidiu-se atribuir a coordenadores grupos de transações locais: um coordenador gerencia todas as transações com token de 0 a 9, o segundo, com token de 10 a 19, e assim por diante. Com isso, cada uma das instâncias de coordenador se torna o mestre do grupo de transações.
Assim, os bloqueios podem ser implementados como um simples HashMap na memória do coordenador.
Falhas dos coordenadores
Como um coordenador atende exclusivamente a um grupo de transações, é muito importante identificar rapidamente a ocorrência de sua falha, para que a nova tentativa de executar a transação esteja dentro do tempo limite. Para isso, aplicamos um protocolo de heartbeat totalmente conectado de quórum:
Em cada data center, há pelo menos duas nós de coordenador. Periodicamente, cada coordenador envia uma mensagem de heartbeat para os demais coordenadores, informando sobre seu funcionamento, bem como sobre quais mensagens de heartbeat recebeu dos outros coordenadores no cluster por último.
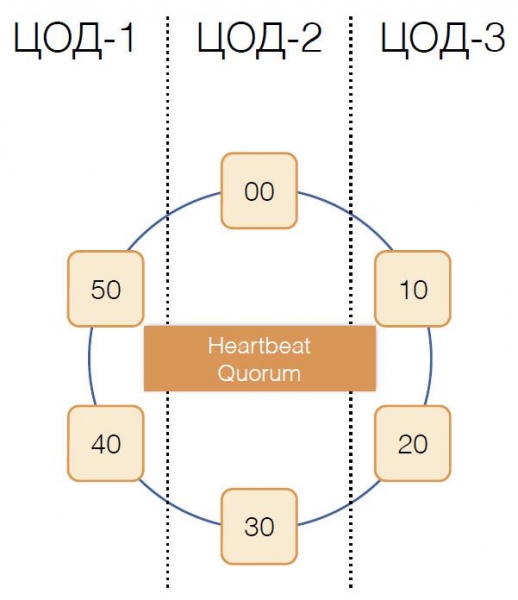
Ao receber informações semelhantes dos demais em suas mensagens de heartbeat, cada coordenador decide quais nós do cluster estão funcionando e quais não estão, baseando-se no princípio de quórum: se o nó X recebeu da maioria dos nós no cluster a informação sobre a recepção normal das mensagens do nó Y, então Y está ativo. E vice-versa, assim que a maioria informar a falta de mensagens do nó Y, significa que Y falhou. Curiosamente, se o quórum informar ao nó X que não está mais recebendo mensagens dele, então o próprio nó X se considerará como tendo falhado.
As mensagens de Heartbeat são enviadas com alta frequência, cerca de 20 vezes por segundo, com um intervalo de 50 ms. Em Java, é difícil garantir uma resposta do aplicativo dentro de 50 ms devido à duração comparável das pausas causadas pelo coletor de lixo. Conseguimos alcançar esse tempo de resposta usando o coletor de lixo G1, que permite especificar um objetivo para a duração das pausas do GC. No entanto, às vezes, raramente, as pausas do coletor ultrapassam 50 ms, o que pode levar a uma detecção falsa de falha. Para evitar isso, o coordenador não reporta a falha de um nó remoto ao perder a primeira mensagem heartbeat dele, mas apenas se várias mensagens consecutivas forem perdidas. Assim, conseguimos detectar a falha do nó coordenador em 200 ms.
Mas é insuficiente entender rapidamente qual nó deixou de funcionar. Precisamos fazer algo a respeito.
Redundância
O esquema clássico prevê, em caso de falha do mestre, a realização de eleições para um novo com um dos algoritmos. No entanto, esses algoritmos têm problemas bem conhecidos com a convergência em tempo e a duração do próprio processo eleitoral. Conseguimos evitar essas delongas adicionais utilizando o esquema de substituição de coordenadores em uma rede totalmente conectada:
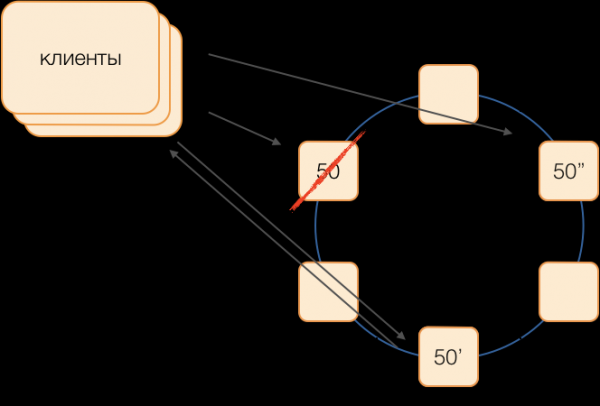
Suponha que queiramos realizar uma transação em um grupo 50. Vamos definir antecipadamente um esquema de substituição, ou seja, quais nós executarão as transações do grupo 50 em caso de falha do coordenador principal. Nosso objetivo é manter a funcionalidade do sistema em caso de falha do data center. Vamos definir que o primeiro reserva será um nó de outro data center, e o segundo reserva será um nó do terceiro. Esse esquema é escolhido uma vez e não muda até que a topologia do cluster mude, ou seja, até que novos nós entrem nele (o que acontece muito raramente). A ordem de escolha do novo mestre ativo em caso de falha do antigo será sempre: o primeiro reserva se tornará o mestre ativo, e se ele também deixar de funcionar — o segundo reserva.
Esse esquema é mais confiável que um algoritmo universal, pois para ativar um novo mestre é suficiente apenas confirmar a falha do antigo.
Mas como os clientes saberão qual dos mestres está trabalhando no momento? É impossível enviar informações para milhares de clientes em 50 ms. Pode ocorrer uma situação em que o cliente envia um pedido para abrir uma transação, ainda sem saber que esse mestre já não está funcionando, e o pedido ficará pendente até o tempo limite. Para evitar que isso aconteça, os clientes enviam especulativamente um pedido para abrir a transação diretamente ao mestre do grupo e a ambas as suas reservas, mas apenas aquele que é o mestre ativo no momento responderá a esse pedido. Toda a comunicação subsequente dentro da transação será realizada apenas com o mestre ativo.
Os mestres de reserva colocam em uma fila de transações não nas suas próprias os pedidos recebidos, onde eles permanecem por um período de tempo. Se o mestre ativo falhar, um novo mestre processa os pedidos de abertura de transações de sua fila e responde ao cliente. Se o cliente já tiver aberto uma transação com o mestre antigo, a segunda resposta é ignorada (e, obviamente, essa transação não será finalizada e será repetida pelo cliente).
Como funciona a transação
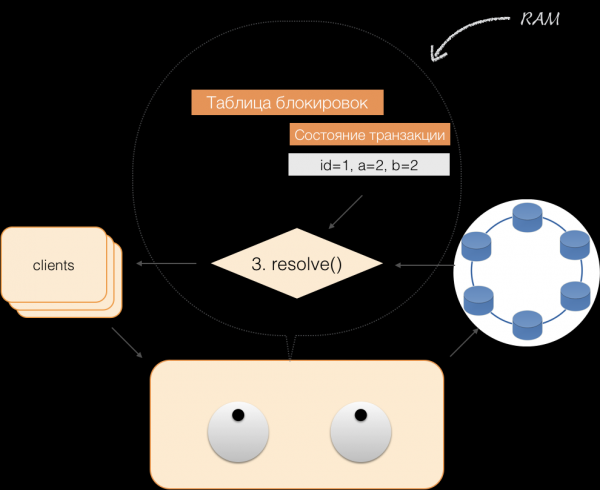
Suponha que o cliente enviou ao coordenador um pedido para abrir uma transação para uma determinada entidade com uma determinada chave primária. O coordenador bloqueia essa entidade e a coloca na tabela de bloqueios na memória. Se necessário, o coordenador lê essa entidade do armazenamento e salva os dados obtidos no estado da transação na memória do coordenador.
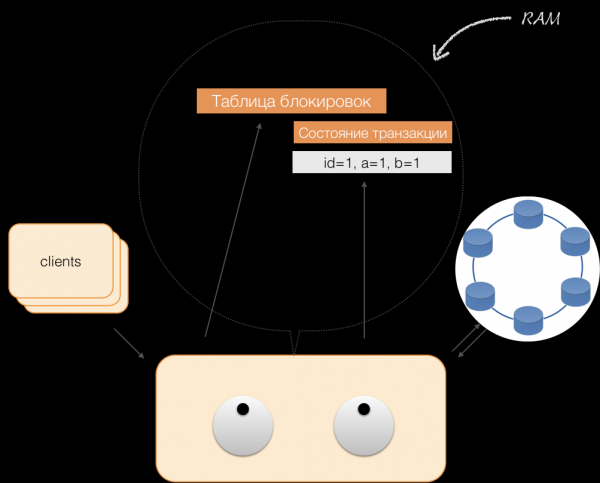
Quando o cliente deseja alterar os dados na transação, ele envia ao coordenador um pedido para modificar a entidade, e este coloca os novos dados na tabela de estado das transações na memória. Neste ponto, a gravação é concluída — a gravação no armazenamento não é realizada.
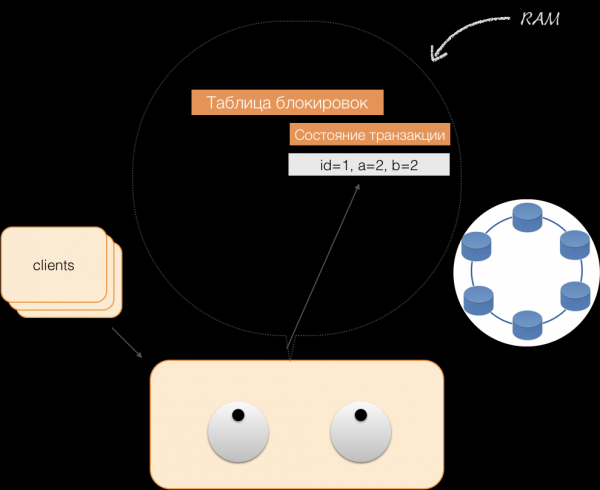
Quando o cliente solicita dados que ele mesmo alterou dentro de uma transação ativa, o coordenador procede da seguinte forma:
- se o ID já estiver na transação, os dados são extraídos da memória;
- se o ID não estiver na memória, os dados ausentes são lidos dos nós de armazenamento, combinados com os que já estão na memória, e o resultado é entregue ao cliente.
Assim, o cliente pode ler suas próprias alterações, enquanto outros clientes não veem essas alterações, porque elas estão armazenadas apenas na memória do coordenador e ainda não estão nos nós do Cassandra.
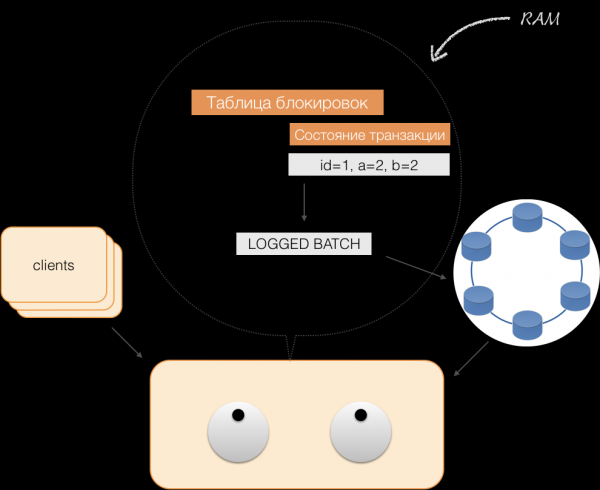
Quando o cliente envia um commit, o estado armazenado na memória do serviço é salvo pelo coordenador em um logged batch, que é então enviado aos repositórios Cassandra. Os repositórios fazem tudo o que é necessário para que este pacote seja aplicado de forma atômica (completa) e retornam uma resposta ao coordenador, que libera os bloqueios e confirma o sucesso da transação ao cliente.
E para o rollback, o coordenador só precisa liberar a memória ocupada pelo estado da transação.
Como resultado das melhorias descritas acima, implementamos os princípios ACID:
- Atomicidade. Isso garante que nenhuma transação seja registrada no sistema parcialmente; serão executadas todas as suas suboperações ou nenhuma delas. Este princípio é respeitado por meio do logged batch no Cassandra.
- Consistência. Cada transação bem-sucedida, por definição, registra apenas resultados válidos. Se, após a abertura da transação e a execução de algumas operações, perceber-se que o resultado é inválido, um rollback é realizado.
- Isolamento. Ao executar uma transação, transações paralelas não devem influenciar seu resultado. Transações concorrentes são isoladas por meio de bloqueios pessimistas no coordenador. Para leituras fora da transação, o princípio de isolamento é mantido no nível Read Committed.
- Resiliência. Independentemente dos problemas em níveis inferiores — desligamento do sistema, falha de hardware — alterações realizadas por uma transação concluída com sucesso devem permanecer salvas após a retomada do funcionamento.
Leitura por índices
Vamos pegar uma tabela simples:
CREATE TABLE photos (
id bigint primary key,
owner bigint,
modified timestamp,
…)
Ela possui ID (chave primária), proprietário e data de modificação. Precisamos fazer uma consulta muito simples — selecionar dados pelo proprietário com a data de modificação "nas últimas 24 horas".
SELECT *
WHERE owner=?
AND modified>?
Para que tal consulta seja executada rapidamente, em um SGBD SQL clássico, é necessário construir um índice nas colunas (owner, modified). Podemos fazer isso de forma bastante simples, já que agora temos garantias ACID!
Índices no C*One
Há uma tabela original com fotos, na qual o ID do registro é a chave primária.
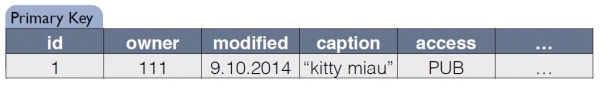
Para o índice, o C*One cria uma nova tabela que é uma cópia da original. A chave coincide com a expressão do índice, e inclui também a chave primária do registro da tabela original:
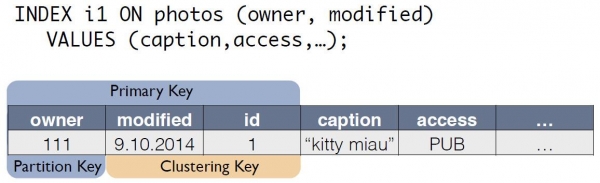
Agora, a consulta por "proprietário nas últimas 24 horas" pode ser reescrita como um select de outra tabela:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
A consistência dos dados da tabela original photos e do índice i1 é mantida automaticamente pelo coordenador. Com base apenas no esquema de dados, ao receber uma alteração, o coordenador gera e armazena a alteração não apenas da tabela principal, mas também das cópias. Nenhuma ação adicional é realizada na tabela de índice, os logs não são lidos, bloqueios não são utilizados. Ou seja, adicionar índices consome quase nenhum recurso e praticamente não influencia na velocidade das modificações.
Com o ACID, conseguimos implementar índices "como no SQL". Eles têm consistência, podem ser escaláveis, funcionam rapidamente, podem ser compostos e integrados na linguagem de consulta CQL. Não é necessário fazer alterações no código do aplicativo para suportar os índices. É tudo tão simples quanto no SQL. E o mais importante, os índices não afetam a velocidade de execução das modificações na tabela de transações original.
O que foi produzido
Desenvolvemos o C*One há três anos e o colocamos em operação industrial.
O que conseguimos no final? Vamos avaliar isso com base no subsistema de processamento e armazenamento de fotos, um dos tipos de dados mais importantes em uma rede social. Não estamos falando apenas dos arquivos das fotos, mas de toda a metainformação. Atualmente, no "Odноклассники", há cerca de 20 bilhões desses registros, o sistema processa 80 mil consultas de leitura por segundo, até 8 mil transações ACID por segundo relacionadas à modificação de dados.
Quando usamos SQL com fator de replicação = 1 (mas em RAID 10), a metainformação das fotos era armazenada em um cluster altamente disponível de 32 máquinas com Microsoft SQL Server (mais 11 reservas). Também foram designados 10 servidores para armazenamento de backups. No total, eram 50 máquinas caras. Nesse cenário, o sistema funcionou com carga nominal, sem margem.
Após a migração para o novo sistema, obtivemos um fator de replicação = 3 — com uma cópia em cada data center. O sistema consiste em 63 nós de armazenamento Cassandra e 6 máquinas coordenadoras, totalizando 69 servidores. No entanto, essas máquinas são significativamente mais baratas, e seu custo total representa cerca de 30% do custo do sistema em SQL. A carga se mantém em torno de 30%.
Com a implementação do C*One, as latências também diminuíram: em SQL, a operação de gravação levava cerca de 4,5 ms. No C*One, cerca de 1,6 ms. A duração da transação, em média, é inferior a 40 ms, o commit é realizado em 2 ms, e a duração de leitura e escrita é, em média, de 2 ms. O percentil 99 é de apenas 3-3,1 ms, e o número de timeouts diminuiu em 100 vezes — tudo isso graças ao amplo uso de especulações.
Até o momento, a maior parte dos nós do SQL Server foi desativada, e novos produtos estão sendo desenvolvidos apenas com a utilização do C*One. Adaptamos o C*One para funcionar em nossa nuvem , o que permitiu acelerar a implantação de novos clusters, simplificar a configuração e automatizar a operação. Sem o código-fonte, isso teria sido significativamente mais complicado e improvisado.
Atualmente, estamos trabalhando na migração de outros nossos armazéns para a nuvem — mas isso é uma história completamente diferente.
Fonte: habr.com
