

TL;DR
- Para alcançar alta observabilidade de contêineres e microsserviços, é insuficiente apenas ter logs e métricas primárias.
- Para uma recuperação mais rápida e aumento da resiliência, as aplicações devem aplicar o Princípio de Alta Observabilidade (HOP, High Observability Principle).
- No nível da aplicação, para o HOP, é necessário: registro adequado, monitoramento rigoroso, verificações de prontidão e rastreamento de desempenho/transições.
- Como elemento do HOP, utilize verificações readinessProbe e livenessProbe Kubernetes.
O que é o Modelo de Verificação de Prontidão?
Ao projetar uma aplicação crítica e altamente disponível, é muito importante considerar um aspecto como a resiliência. A aplicação é considerada resiliente se ela se recupera rapidamente de falhas. Uma aplicação típica em nuvem utiliza uma arquitetura de microsserviços – onde cada componente é colocado em um contêiner separado. E para garantir que a aplicação no k8s seja altamente disponível, ao projetar um cluster, é necessário seguir certos modelos. Entre eles está o Modelo de Verificação de Prontidão. Ele define como a aplicação informa ao k8s sobre sua prontidão. Isso inclui não apenas se o pod está em funcionamento, mas também como ele recebe e responde a requisições. Quanto mais o Kubernetes souber sobre a prontidão do pod, melhores serão as decisões que ele tomará sobre o roteamento de tráfego e balanceamento de carga. Assim, o Princípio de Alta Observabilidade permite que a aplicação responda a requisições em tempo hábil.
Princípio de Alta Observabilidade (HOP)
O Princípio de Alta Observabilidade é um dos . Na arquitetura de microsserviços, os serviços não se importam com a forma como suas solicitações são processadas (e isso está correto), mas é importante como obter respostas dos serviços que as recebem. Por exemplo, para a autenticação do usuário, um contêiner envia uma solicitação HTTP a outro, aguardando uma resposta em um formato específico – e é só isso. O pedido pode ser tratado por PythonJS, e a resposta pode vir do Python Flask. Os contêineres são uns para os outros como caixas pretas com conteúdos ocultos. No entanto, o princípio NOR exige que cada serviço exponha vários endpoints de API, mostrando quão operacional ele é, bem como seu estado de prontidão e resiliência. Esses indicadores são solicitados pelo Kubernetes para planejar os próximos passos em roteamento e balanceamento de carga.
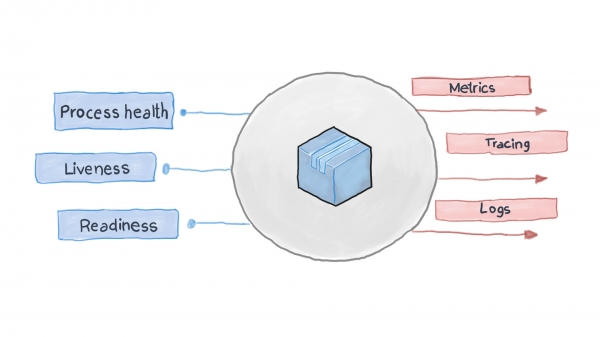
Um aplicativo em nuvem bem projetado registra seus eventos principais usando os padrões de entrada e saída STDERR e STDOUT. Em seguida, um serviço auxiliar, como filebeat, logstash ou fluentd, envia os logs para um sistema de monitoramento centralizado (por exemplo, Prometheus) e um sistema de coleta de logs (como o conjunto de ferramentas ELK). O diagrama abaixo ilustra como o aplicativo em nuvem opera de acordo com o Modelo de Verificação de Funcionamento e o Princípio de Alta Observabilidade.
Como aplicar o Modelo de Verificação de Funcionamento no Kubernetes?
O k8s monitora o estado dos pods a partir da caixa, utilizando um dos controladores (, , , e outros, etc.). Ao identificar que um pod caiu por algum motivo, o controlador tenta reiniciá-lo ou reprogramá-lo em outro nó. No entanto, um pod pode relatar que está em funcionamento, enquanto na verdade não está. Por exemplo: seu aplicativo utiliza o Apache como servidor web, e você configurou o componente em vários pods do cluster. Como a biblioteca foi configurada incorretamente, todas as solicitações ao aplicativo retornam o código 500 (erro interno do servidor). Ao verificar a entrega, o teste de estado dos pods é bem-sucedido, mas os clientes pensam diferente. Essa situação indesejada pode ser descrita da seguinte maneira:
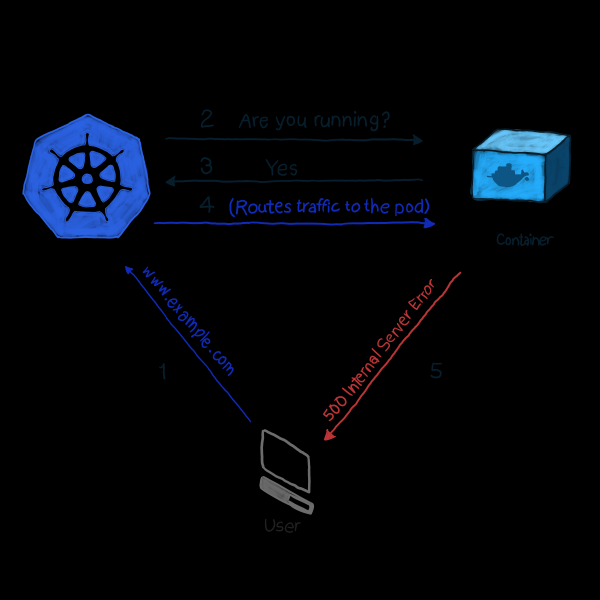
No nosso exemplo, o k8s executa a verificação de funcionamentoNeste tipo de verificação, o kubelet monitoriza continuamente o estado do processo no contêiner. Assim que detectar que o processo parou, ele o reinicia. Se o erro for resolvido com um simples reinício do aplicativo, e o programa for projetado para desligar em caso de qualquer erro, então, para seguir as normas e o modelo de verificação de funcionamento, basta verificar o funcionamento do processo. É uma pena que nem todos os erros possam ser resolvidos com um reinício. Para esses casos, o k8s oferece duas maneiras mais profundas de detectar falhas na operação do pod: e .
LivenessProbe
Durante livenessProbe o kubelet realiza 3 tipos de verificações: ele não apenas determina se o pod está funcionando, mas também se está pronto para receber e responder adequadamente a solicitações:
- Estabelecer uma solicitação HTTP para o pod. A resposta deve conter um código de status HTTP na faixa de 200 a 399. Assim, os códigos 5xx e 4xx sinalizam que o pod está com problemas, mesmo que o processo esteja funcionando.
- Para verificar pods com serviços não-HTTP (como o servidor de e-mail Postfix), deve-se estabelecer uma conexão TCP.
- Executando um comando arbitrário para o pod (internamente). A verificação é considerada bem-sucedida se o código de saída do comando for 0.
Um exemplo de como isso funciona. A definição do próximo pod contém um aplicativo NodeJS, que retorna um erro 500 em resposta a solicitações HTTP. Para garantir que o contêiner seja reiniciado ao receber tal erro, usamos o parâmetro livenessProbe:
apiVersion: v1
kind: Pod
metadata:
 name: node500
spec:
 containers:
   - image: magalix/node500
     name: node500
     ports:
       - containerPort: 3000
         protocol: TCP
     livenessProbe:
       httpGet:
         path: /
         port: 3000
       initialDelaySeconds: 5
Isso não difere em nada de qualquer outra definição de pod, mas adicionamos o objeto .spec.containers.livenessProbe. Parâmetro httpGet que aceita um caminho pelo qual envia a solicitação HTTP GET (em nosso exemplo, isso é /, mas em cenários de produção pode ser algo como /api/v1/status). O livenessProbe também aceita o parâmetro initialDelaySeconds, que instrui as operações de verificação a esperar um número especificado de segundos. A espera é necessária porque o contêiner precisa de tempo para inicializar, e ao ser reiniciado, ele estará indisponível por um período.
Para aplicar essa configuração ao cluster, use:
kubectl apply -f pod.yamlApós alguns segundos, você pode verificar o conteúdo do pod com o seguinte comando:
kubectl describe pods node500No final da saída, procure .
Como você pode ver, o livenessProbe iniciou uma solicitação HTTP GET, o contêiner retornou um erro 500 (para o que foi programado), e o kubelet o reiniciou.
Se você estiver curioso sobre como o aplicativo NodeJS foi programado, aqui estão os arquivos app.js e Dockerfile que foram utilizados:
app.js
var http = require('http');

var server = http.createServer(function(req, res) {
    res.writeHead(500, { "Content-type": "text/plain" });
    res.end("Encontramos um erron");
});

server.listen(3000, function() {
    console.log('O servidor está rodando na porta 3000')
})
Dockerfile
FROM node
COPY app.js /
EXPOSE 3000
ENTRYPOINT [ "node","/app.js" ]
É importante ressaltar o seguinte: o livenessProbe reiniciará o contêiner apenas em caso de falha. Se a reinicialização não corrigir o erro que impede o funcionamento do contêiner, o kubelet não poderá tomar medidas para resolver a falha.
readinessProbe
O readinessProbe funciona de maneira semelhante ao livenessProbes (requisições GET, TCP connections e execução de comandos), exceto pelas ações de resolução de problemas. O contêiner que falhou não é reiniciado, mas isolado do tráfego de entrada. Imagine que um dos contêineres está executando muitos cálculos ou está sob alta carga, o que aumenta o tempo de resposta às solicitações. No caso do livenessProbe, a verificação de disponibilidade é acionada (através do parâmetro de verificação timeoutSeconds), após o que o kubelet reinicia o contêiner. Ao iniciar, o contêiner começa a executar tarefas que consomem recursos, e ele é reiniciado novamente. Isso pode ser crítico para aplicações que dependem da velocidade de resposta. Por exemplo, um carro em movimento espera uma resposta do servidor, a resposta se atrasa – e o carro colide.
Vamos escrever uma definição para redinessProbe, que definirá um tempo de resposta para a solicitação GET de no máximo dois segundos, enquanto o aplicativo responderá à solicitação GET em cinco segundos. O arquivo pod.yaml deve ser da seguinte forma:
apiVersion: v1
kind: Pod
metadata:
 name: nodedelayed
spec:
 containers:
   - image: afakharany/node_delayed
     name: nodedelayed
     ports:
       - containerPort: 3000
         protocol: TCP
     readinessProbe:
       httpGet:
         path: /
         port: 3000
       timeoutSeconds: 2
Vamos implantar o pod com kubectl:
kubectl apply -f pod.yamlVamos esperar alguns segundos e então veremos como o readinessProbe se comportou:
kubectl describe pods nodedelayedNo final da saída, podemos ver que parte dos eventos é semelhante a .
Como você pode ver, o kubectl não reiniciou o pod quando o tempo de verificação excedeu 2 segundos. Em vez disso, ele cancelou a solicitação. As conexões de entrada foram redirecionadas para outros pods funcionais.
Observe: now that the extra load has been removed from the pod, kubectl is directing requests to it again: responses to GET requests are no longer delayed.
For comparison, below is the modified app.js file:
var http = require('http');

var server = http.createServer(function(req, res) {
   const sleep = (milliseconds) => {
       return new Promise(resolve => setTimeout(resolve, milliseconds))
   }
   sleep(5000).then(() => {
       res.writeHead(200, { "Content-type": "text/plain" });
       res.end("Hellon");
   })
});

server.listen(3000, function() {
   console.log('Server is running at 3000')
})
TL;DR
Before the advent of cloud applications, logs were the main tool for monitoring and checking application statuses. However, there were no means to take any measures for troubleshooting. Logs are still useful today; they must be collected and sent to a logging system for crash analysis and decision-making. [this could all be done without cloud applications using monit, for example, but with k8s it became much easier 🙂 – ed. ]
Today, changes need to be made almost in real-time, so applications should no longer be black boxes. No, they must expose endpoints that allow monitoring systems to request and collect valuable data about the state of processes to react instantly if necessary. This is called the Health Check design pattern, following the principle of high observability (HO).
Kubernetes, by default, offers two types of health checks: readinessProbe and livenessProbe. Both use the same types of checks (HTTP GET requests, TCP connections, and command execution). They differ in what actions they take in response to issues in the pods. livenessProbe restarts the container in hopes that the error won’t occur again, while readinessProbe isolates the pod from incoming traffic until the issue is resolved.
Proper application design should include both types of checks and ensure they gather sufficient data, especially when an exception occurs. It should also expose necessary API endpoints that transmit important health metrics to the monitoring system (like Prometheus).
Fonte: habr.com
