

Sempre me interessei em como organizar melhor os livros na minha biblioteca eletrônica. Acabei chegando a esta opção com contagem automática de páginas e outras funcionalidades. Todos os interessados, por favor, cliquem no link abaixo.
Parte 1. Dropbox
Todos os meus livros estão no Dropbox. Existem 4 categorias nas quais eu dividi tudo: Texto, Manual, Ficção, Não-ficção. Mas eu não adiciono os manuais na tabela.
A maior parte dos livros está em .epub, os restantes são .pdf. Ou seja, a solução final deve cobrir ambos os formatos.
Os caminhos para os livros são aproximadamente assim:
/Книги/Нехудожественное/Новое/Дизайн/Юрий Гордон/Книга про буквы от А до Я.epub Se o livro é uma ficção, a categoria (ou seja, 'Design' no caso acima) é removida.
Decidi não complicar com a API do Dropbox, já que tenho o aplicativo que sincroniza a pasta. Ou seja, o plano é o seguinte: pegamos os livros da pasta, passamos cada livro por um contador de palavras e adicionamos ao Notion.
Parte 2. Adicionando uma linha
A tabela deve se parecer aproximadamente com a seguinte. ATENÇÃO: é melhor nomear as colunas em alfabeto latino.
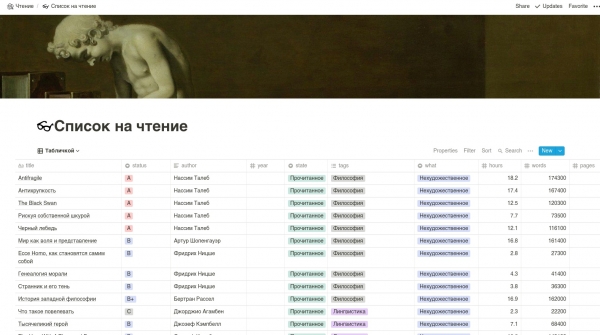
Vamos usar a API não oficial do Notion, porque a oficial ainda não foi liberada.

Vamos ao Notion, pressionamos Ctrl + Shift + J, vamos em Aplicativo -> Cookies, copiamos token_v2 e o chamamos de TOKEN. Em seguida, vamos para a página desejada com a tabela da biblioteca e copiamos o link. Chamamos isso de NOTION.
Depois escrevemos o código para conectar ao Notion.
database = client.get_collection_view(NOTION)
current_rows = database.default_query().execute()
Vamos escrever uma função para adicionar uma linha à tabela.
def add_row(path, file, words_count, pages_count, hours):
    row = database.collection.add_row()
    row.title = file

    tags = path.split("/")

    if len(tags) >= 1:
        row.what = tags[0]

    if len(tags) >= 2:
        row.state = tags[1]

    if len(tags) >= 3:
        if tags[0] == "Ficção":
            row.author = tags[2]

        elif tags[0] == "Não-ficção":
            row.tags = tags[2]

        elif tags[0] == "Textos":
            row.tags = tags[2]

    if len(tags) >= 4:
        row.author = tags[3]

    row.hours = hours
    row.pages = pages_count
    row.words = words_count
O que está acontecendo aqui? Estamos pegando e adicionando uma nova linha à tabela na primeira posição. Depois, dividimos o nosso caminho por ' / ' e obtemos as tags. As tags se referem a 'Ficção', 'Design', quem é o autor e assim por diante. Em seguida, definimos todos os campos necessários da tabela.
Parte 3. Contando palavras, horas e outras funcionalidades
Esta é uma tarefa um pouco mais complicada. Como sabemos, temos dois formatos: ePub e PDF. Se para o ePub tudo está claro — provavelmente, há palavras lá, quanto ao PDF, as coisas não são tão univocamente claras: ele pode ser composto apenas de imagens coladas.
Portanto, a função para contar palavras em PDF será a seguinte: pegamos o número de páginas e multiplicamos por uma constante (número médio de palavras por página).
Aqui está:
def get_words_count(pages_number):
    return pages_number * WORDS_PER_PAGE
Este WORDS_PER_PAGE para uma página A4 é aproximadamente 300.
Agora vamos escrever uma função para contar as páginas. Vamos usar .
def get_pdf_pages_number(path, filename):
    pdf = PdfFileReader(open(os.path.join(path, filename), 'rb'))
    return pdf.getNumPages()
Em seguida, vamos escrever algo para contar as páginas no ePub. Usamos . Aqui pegamos o livro, convertendo em linhas, e para cada linha contamos as palavras.
def get_epub_pages_number(path, filename):
    book = open_book(os.path.join(path, filename))
    lines = convert_epub_to_lines(book)
    words_count = 0

    for line in lines:
        words_count += len(line.split(" "))

    return round(words_count / WORDS_PER_PAGE)
Agora faremos a contagem do tempo. Pegamos nosso número favorito de palavras e dividimos pela sua velocidade de leitura.
def get_reading_time(words_count):
    return round(((words_count / WORDS_PER_MINUTE) / 60) * 10) / 10
Parte 4. Juntando todas as partes
Precisamos percorrer todos os caminhos possíveis na nossa pasta de livros. Verificar se o livro já está no Notion: se estiver — não precisamos criar a linha.
Depois, precisamos determinar o tipo de arquivo, dependendo disso, contar o número de palavras. No final, adicionar o livro.
Aqui está o código que temos:
for root, subdirs, files in os.walk(BOOKS_DIR):
    if len(files) > 0 and check_for_excusion(root):
        for file in files:
            array = file.split(".")
            filetype = file.split(".")[len(array) - 1]
            filename = file.replace("." + filetype, "")
            local_root = root.replace(BOOKS_DIR, "")

            print("Dir: {}, file: {}".format(local_root, file))

            if not check_for_existence(filename):
                print("Dir: {}, file: {}".format(local_root, file))

                if filetype == "pdf":
                    count = get_pdf_pages_number(root, file)

                else:
                    count = get_epub_pages_number(root, file)

                words_count = get_words_count(count)
                hours = get_reading_time(words_count)
                print("Pages: {}, Words: {}, Hours: {}".format(count, words_count, hours))
                add_row(local_root, filename, words_count, count, hours)
E a função para verificar se o livro foi adicionado é assim:
def check_for_existence(filename):
    for row in current_rows:
        if row.title in filename:
            return True

        elif filename in row.title:
            return True

    return False
Conclusão
Obrigado a todos que leram este artigo. Espero que ajude você a ler mais 🙂
Fonte: habr.com
