

Hoje, quarta-feira, lançamos mais uma versão do Kubernetes — 1.16. Seguindo a tradição do nosso blog, aqui estamos novamente para falar sobre as mudanças mais significativas nesta décima versão.
As informações usadas para preparar este material foram retiradas de , e os respectivos issues, pull requests e Propostas de Melhoria do Kubernetes (KEP). Então, vamos lá!..
Nódulos
Um número realmente grande de novidades notáveis (em status alfa) foi apresentado no lado dos nódulos dos clusters K8s (Kubelet).
Primeiramente, foram introduzidos os chamados «» (Ephemeral Containers), que têm como objetivo simplificar os processos de depuração em pods. O novo mecanismo permite iniciar contêineres especiais que começam no namespace dos pods existentes e têm uma vida útil curta. A intenção é interagir com outros pods e contêineres para resolver problemas e para fins de depuração. Para essa funcionalidade, foi implementado um novo comando kubectl debug, semelhante ao kubectl exec: apenas, em vez de iniciar um processo em um contêiner (como no caso de exec), ele inicia um contêiner em um pod. Por exemplo, este comando conectará um novo contêiner ao pod:
kubectl debug -c debug-shell --image=debian target-pod -- bashDetalhes sobre contêineres efêmeros (e exemplos de uso) podem ser encontrados no . A implementação atual (no K8s 1.16) é uma versão alfa, e entre os critérios para sua transição para a versão beta está "testar a API de Contêineres Efêmeros por pelo menos 2 versões [Kubernetes]".
NB: Em essência e até pelo nome, a funcionalidade lembra um plugin já existente , sobre o qual nós . Espera-se que com a introdução de contêineres efêmeros o desenvolvimento de um plugin externo separado seja interrompido.
Outra novidade é , destinada a fornecer um mecanismo para calcular gastos adicionais em pods, que podem variar muito dependendo do ambiente de execução utilizado. Como exemplo, os autores mencionam o Kata Containers, que requer a execução de um kernel convidado, agente kata, sistema init, etc. Quando o overhead se torna tão alto, não pode ser ignorado, o que significa que é necessário um modo de contabilizá-lo para futuras alocações, planejamento etc. Para isso, foi adicionado um campo Overhead *ResourceList no PodSpec que se correlaciona com os dados em RuntimeClass, se houver.
Mais uma novidade significativa é o gerenciador de topologia de nódulos (Node Topology Manager), chamado para unificar a abordagem para o ajuste fino da distribuição de recursos de hardware para vários componentes no Kubernetes. Esta iniciativa surge da crescente necessidade de variados sistemas modernos (nas áreas de telecomunicações, aprendizado de máquina, serviços financeiros, etc.) para computação paralela de alto desempenho e minimização da latência na execução de operações, utilizando para isso as capacidades avançadas de CPU e aceleração de hardware. Essas otimizações no Kubernetes até agora foram alcançadas graças a componentes dispersos (CPU manager, Device manager, CNI), e agora será adicionado uma interface interna única, que unificará a abordagem e simplificará a conexão de novos componentes semelhantes — os chamados componentes topology-aware — do lado do Kubelet. Detalhes — em .
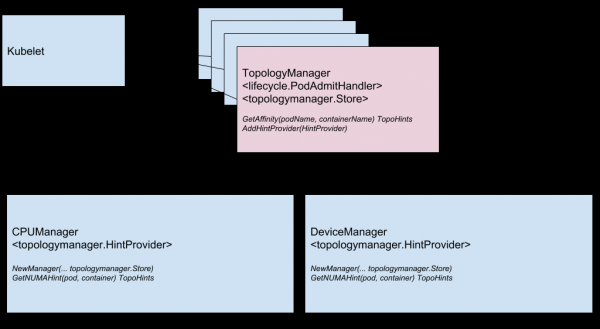
Esquema dos Componentes do Topology Manager
O próximo recurso — verificação de contêineres durante seu início (). Como se sabe, para contêineres que demoram para iniciar, é difícil obter um status atual: eles são ou 'mortalmente' finalizados antes de realmente funcionarem, ou ficam em deadlock por muito tempo. A nova verificação (ativada por meio de uma feature gate chamada StartupProbeEnabled) cancela — ou melhor, adia — a ação de quaisquer outras verificações até que o pod tenha completado seu início. Por essa razão, o recurso foi inicialmente denominado . Para pods que demoram para iniciar, é possível realizar sondagens de status em intervalos de tempo relativamente curtos.
Além disso, imediatamente na versão beta foi apresentada uma melhoria para o RuntimeClass, acrescentando suporte a 'clusters heterogêneos'. Com agora não é mais necessário que cada nó tenha suporte para cada RuntimeClass: para os pods, é possível escolher o RuntimeClass sem se preocupar com a topologia do cluster. Antes, para alcançar isso — para que os pods fossem colocados em nós que suportavam tudo o que precisavam — era preciso designar regras correspondentes para NodeSelector e tolerações. Em são apresentados exemplos de uso e, claro, detalhes de implementação.
Rede
Duas características de rede significativas que apareceram pela primeira vez (na versão alfa) no Kubernetes 1.16 — são:
- a pilha de rede dupla — IPv4/IPv6 — e seu correspondente "entendimento" no nível de pods, nós, serviços. Isso inclui a interação IPv4 para IPv4 e IPv6 para IPv6 entre pods, de pods para serviços externos, implementações de referência (dentro dos plugins Bridge CNI, PTP CNI e Host-Local IPAM), bem como compatibilidade com clusters Kubernetes que operam apenas com IPv4 ou IPv6. Detalhes da implementação estão em .
Exemplo de exibição de endereços IP de dois tipos (IPv4 e IPv6) na lista de pods:
kube-master# kubectl get pods -o wide NOME PRONTO STATUS REINÍCIOS IDADE IP NÓ nginx-controller 1/1 Executando 0 20m fd00:db8:1::2,192.168.1.3 kube-minion-1 kube-master# - Nova API para Endpoint — . Ela resolve problemas de desempenho/escabilidade da existente API Endpoint, afetando vários componentes no control-plane (apiserver, etcd, endpoints-controller, kube-proxy). A nova API será adicionada ao grupo de APIs Discovery e poderá atender dezenas de milhares de endpoints de backend em cada serviço em um cluster composto por milhares de nós. Para isso, cada Serviço é mapeado em N objetos
EndpointSlice, cada um dos quais por padrão possui no máximo 100 endpoints (o valor é configurável). A API EndpointSlice também prevê possibilidades para seu futuro desenvolvimento: suporte a vários endereços IP para cada pod, novos estados para endpoints (não apenasProntoeNotReady), subsetting dinâmico para endpoints.
Ele avançou para a versão beta, apresentado no lançamento anterior , chamado service.kubernetes.io/load-balancer-cleanup e anexado a cada serviço do tipo LoadBalancer. No momento da remoção de tal serviço, ele impede a real exclusão do recurso até que a "limpeza" de todos os recursos do balanceador correspondente esteja concluída.
API Machinery
Um verdadeiro "marco de estabilização" foi registrado na área do servidor API Kubernetes e sua interação. Grande parte disso ocorreu graças ao trânsito para o status estável de (CRD), que estavam no status beta desde os primórdios do Kubernetes 1.7 (o que remonta a junho de 2017!). A mesma estabilização também se aplicou às funcionalidades relacionadas:
- com um
/statuse/scalepara CustomResources; - de versões para CRD, baseada em um webhook externo;
- (em K8s 1.15) para defaulting e remoção automática de campos (pruning) da aplicação do esquema OpenAPI v3 para criação e publicação de documentação OpenAPI utilizada para validação dos recursos CRD no lado do servidor. para CustomResources;
- aplicando o esquema OpenAPI v3 para criação e publicação de documentação OpenAPI, usada para validação de recursos CRD no lado do servidor.
Mais um mecanismo, que se tornou familiar para administradores do Kubernetes: — também esteve por muito tempo em status beta (com K8s 1.9) e agora é considerado estável.
Duas outras funcionalidades alcançaram a versão beta: e .
E a única inovação significativa na versão alfa foi de SelfLink — um URI especial que representa o objeto especificado e faz parte de ObjectMeta e ListMeta (ou seja, parte de qualquer objeto no Kubernetes). Por que isso está sendo removido? A motivação "simples" como a ausência de razões reais (insuperáveis) para que esse campo continue existindo. Razões mais formais incluem otimizar o desempenho (removendo um campo desnecessário) e simplificar o trabalho do generic-apiserver, que deve lidar com esse campo de forma especial (ele é o único campo que é definido imediatamente antes da serialização do objeto). O verdadeiro "obsolescência" (no âmbito da versão beta) SelfLink ocorrerá na versão 1.20 do Kubernetes, e a obsolescência final — 1.21.
Armazenamento de dados
O trabalho principal na área de armazenamento, assim como nas versões anteriores, é observado na área . As principais mudanças aqui foram:
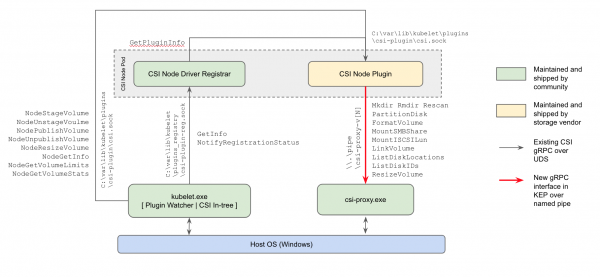
- pela primeira vez (na versão alfa) suporte a plugins CSI para nós de trabalho com Windows: a forma atual de trabalhar com armazenamentos aqui substituirá os plugins in-tree no núcleo do Kubernetes e os plugins FlexVolume da Microsoft baseados em Powershell;

O esquema de implementação de plugins CSI no Kubernetes para Windows - a possibilidade , apresentado ainda na K8s 1.12, avançou para a versão beta;
- uma "promoção" semelhante (da versão alfa para a beta) foi alcançada pela capacidade de usar o CSI para criar volumes efêmeros locais ().
Introduzida na versão anterior do Kubernetes (usando PVCs existentes como DataSource para criar novos PVCs) agora também foi promovida para a versão beta.
Agendador
Duas mudanças notáveis no agendamento (ambas na versão alfa):
- — a possibilidade de usar pods para uma "distribuição justa" das cargas em vez de unidades lógicas de aplicativo (como Deployment e ReplicaSet) e o ajuste dessa distribuição (como um requisito rígido ou como uma condição suave, ou seja, uma prioridade). A funcionalidade expandirá as capacidades já existentes de distribuição de pods programados, atualmente limitadas pelas opções
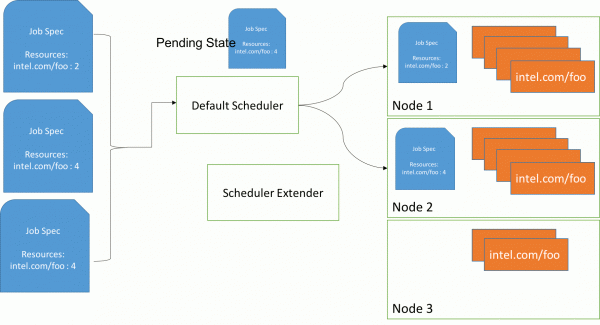
PodAffinityePodAntiAffinity, fornecendo aos administradores um controle mais refinado sobre essa questão, o que significa melhor alta disponibilidade e consumo otimizado de recursos. Detalhes em . - Uso Política BestFit em Função de Prioridade RequestedToCapacityRatio durante o planejamento de pods, permitindo aplicar (“empacotamento em contêineres”) tanto para recursos principais (processador, memória) quanto para recursos avançados (como GPU). Para mais detalhes, veja em .

Planejamento de pods: antes do uso da best fit policy (diretamente através do agendador padrão) e com seu uso (via scheduler extender)
Além disso, a capacidade de criar seus próprios plugins para o agendador fora da principal árvore de desenvolvimento do Kubernetes (out-of-tree).
Outras alterações
Além disso, na versão 1.16 do Kubernetes, também podemos destacar a iniciativa de das métricas existentes em ordem completa, ou mais precisamente — em conformidade com para a instrumentação do K8s. Eles, em grande parte, baseiam-se na correspondente . As inconsistências surgiram por várias razões (por exemplo, algumas métricas foram simplesmente criadas antes das instruções atuais aparecerem), e os desenvolvedores decidiram que era hora de padronizar tudo, “em conformidade com o restante do ecossistema do Prometheus”. A implementação atual dessa iniciativa está no status de versão alfa, que será gradualmente elevado nas versões subsequentes do Kubernetes para beta (1.17) e estável (1.18).
Além disso, podem ser observadas as seguintes mudanças:
- Desenvolvimento de suporte ao Windows com da ferramenta Kubeadm para este SO (versão alfa),
RunAsUserNamepara contêineres do Windows (versão alfa), apoio ao Group Managed Service Account (gMSA) até a versão beta, mount/attach para volumes vSphere. - do mecanismo de compressão de dados nas respostas da API. Anteriormente, para esses objetivos, um filtro HTTP era utilizado, que impunha certas restrições, impedindo que fosse habilitado por padrão. Agora funciona a “compressão transparente de solicitações”: os clientes que enviam
Accept-Encoding: gzipno cabeçalho recebem uma resposta comprimida em GZIP, se seu tamanho exceder 128 KB. Clientes em Go suportam automaticamente a compressão (enviam o cabeçalho necessário), então perceberão imediatamente a redução do tráfego. (Para outras linguagens, pequenas modificações podem ser necessárias.) - escalonar HPA de até zero pods com base em métricas externas. Se o dimensionamento for feito com base em objetos/métricas externas, é possível escalar automaticamente para 0 réplicas quando as cargas de trabalho estão ociosas, economizando recursos. Essa função deve ser especialmente útil em casos em que os workers solicitam recursos de GPU, e o número de diferentes tipos de workers ociosos supera o número de GPUs disponíveis.
- Novo cliente — — para acesso "genérico" aos objetos. Ele é destinado a facilitar a obtenção de metadados (ou seja, subdivisão
metadata) dos recursos do cluster e realizar operações do tipo coleta de lixo e cota. - Coletar Kubernetes sem provedores de nuvem obsoletos ("inclusos" no in-tree) (versão alfa).
- No utilitário kubeadm uma função experimental (versão alfa) para aplicar patches do kustomize durante operações
init,joineupgrade. Para mais informações sobre como usar a bandeira--experimental-kustomize, veja em . - Novo endpoint para apiserver — , — permitindo exportar informações sobre sua prontidão (readiness). O API server também ganhou uma bandeira
--maximum-startup-sequence-duration, permitindo regular seus reinícios. - Duas funções para Azure foram anunciadas como estáveis: suporte a e Além disso, no Azure foram adicionadas:
- AAD e ADFS;
-
service.beta.kubernetes.io/azure-pip-namepara especificar o IP público do balanceador de carga; - configurações
LoadBalancerNameeLoadBalancerResourceGroup.
- A AWS agora tem para EBS no Windows e DescribeInstances
O Kubeadm agora migra automaticamente. - a configuração do CoreDNS ao atualizar a versão do CoreDNS. no respectivo Docker image
- world-executable, permitindo executar essa imagem sem a necessidade de privilégios de root. Além disso, a imagem de migração do etcd etcd suporta a versão etcd2. Cluster Autoscaler 1.16.0 mudou para usar distroless como imagem base, melhorou o desempenho, adicionou novos provedores de nuvem (DigitalOcean, Magnum, Packet).
- Em 🥇Kubernetes 1.16: resumo das principais novidades | ProHoster
- 🥇Kubernetes 1.16: visão geral das principais novidades | ProHoster
P.S.
Confira também em nosso blog:
- «»;
- «»;
- «»;
- «».
Fonte: habr.com
