

O sistema de recomendação de vídeo online em que estamos trabalhando é uma solução comercial fechada e, tecnicamente, consiste em um cluster multiparte de componentes proprietários e de código aberto. O objetivo deste artigo é descrever a implementação do sistema de clusterização Docker Swarm em um ambiente de staging, sem prejudicar o fluxo de trabalho existente de nossos processos dentro de um tempo limitado. A narrativa apresentada a vocês está dividida em duas partes. A primeira parte descreve o CI/CD antes da utilização do Docker Swarm, e a segunda — o processo de sua implementação. Aqueles que não estão interessados em ler a primeira parte podem avançar diretamente para a segunda.
Parte I
Em um ano muito distante, era necessário configurar o processo de CI/CD o mais rápido possível. Uma das condições era não usar Docker para o deployment dos componentes em desenvolvimento por várias razões:
- para garantir um funcionamento mais confiável e estável dos componentes em produção (ou seja, na prática, a exigência de não usar virtualização)
- os principais desenvolvedores não queriam trabalhar com Docker (estranho, mas era a realidade)
- por razões ideológicas da gestão de P&D
A infraestrutura, o stack e os requisitos de entrada aproximados para o MVP eram os seguintes:
- 4 servidores Intel® X5650 com Debian (uma máquina mais potente totalmente dedicada ao desenvolvimento)
- O desenvolvimento de componentes personalizados está sendo realizado em C++, Python3
- As principais ferramentas de terceiros utilizadas são: Kafka, Clickhouse, Airflow, Redis, Grafana, Postgresql, Mysql, …
- Pipelines de construção e teste de componentes separados para debug e release
Uma das primeiras questões que precisa ser resolvida na fase inicial é como será feita a implantação dos componentes personalizados em algum ambiente (CI/CD).
Componentes de terceiros decidiram ser instalados e atualizados sistematicamente. Aplicações personalizadas, desenvolvidas em C++ ou Python, podem ser implementadas de várias maneiras. Entre elas, por exemplo: criação de pacotes do sistema, envio para repositórios de imagens compiladas e a posterior instalação em servidores. Por razões já desconhecidas, foi escolhido outro método, a saber: através de CI, os arquivos executáveis das aplicações são compilados, um ambiente virtual do projeto é criado, os módulos Python são instalados a partir do requirements.txt e todos esses artefatos são enviados junto com as configurações, scripts e o ambiente necessário para as aplicações aos servidores. A seguir, as aplicações são iniciadas a partir de um usuário virtual sem direitos de administrador.
O Gitlab-CI foi escolhido como sistema de CI/CD. O pipeline resultante ficou aproximadamente assim:
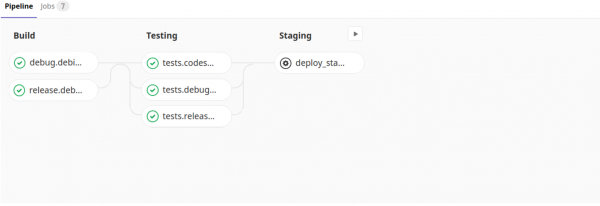
Estruturalmente, o gitlab-ci.yml ficou da seguinte forma
---
variables:
  # versão mínima da CPU nos servidores onde o cluster é implantado
  CMAKE_CPUTYPE: "westmere"

  DEBIAN: "MYREGISTRY:5000/debian:latest"

before_script:
  - eval $(ssh-agent -s)
  - ssh-add  ~/.ssh/config

stages:
  - build
  - testing
  - deploy

debug.debian:
  stage: build
  image: $DEBIAN
  script:
    - cd builds/release && ./build.sh
    paths:
      - bin/
      - builds/release/bin/
    when: always
release.debian:
  stage: build
  image: $DEBIAN
  script:
    - cd builds/release && ./build.sh
    paths:
      - bin/
      - builds/release/bin/
    when: always

## fase de testes
tests.codestyle:
  stage: testing
  image: $DEBIAN
  dependencies:
    - release.debian
  script:
    - /bin/bash run_tests.sh -t codestyle -b "${CI_COMMIT_REF_NAME}_codestyle"
tests.debug.debian:
  stage: testing
  image: $DEBIAN
  dependencies:
    - debug.debian
  script:
    - /bin/bash run_tests.sh -e codestyle/test_pylint.py -b "${CI_COMMIT_REF_NAME}_debian_debug"
  artifacts:
    paths:
      - run_tests/username/
    when: always
    expire_in: 1 week
tests.release.debian:
  stage: testing
  image: $DEBIAN
  dependencies:
    - release.debian
  script:
    - /bin/bash run_tests.sh -e codestyle/test_pylint.py -b "${CI_COMMIT_REF_NAME}_debian_release"
  artifacts:
    paths:
      - run_tests/username/
    when: always
    expire_in: 1 week

## fase de preparação
deploy_staging:
  stage: deploy
  environment: staging
  image: $DEBIAN
  dependencies:
    - release.debian
  script:
    - cd scripts/deploy/ &&
        python3 createconfig.py -s $CI_ENVIRONMENT_NAME &&
        /bin/bash install_venv.sh -d -r ../../requirements.txt &&
        python3 prepare_init.d.py &&
        python3 deploy.py -s $CI_ENVIRONMENT_NAME
  when: manual
É importante notar que a compilação e os testes são realizados em sua própria imagem, onde todos os pacotes do sistema necessários já estão instalados e outras configurações foram feitas.
Embora cada um desses scripts em jobs seja interessante à sua maneira, não vou descrever cada um deles, pois isso levaria tempo considerável e não é o objetivo deste artigo. Apenas gostaria de ressaltar que a fase de deploy consiste em uma sequência de chamadas de scripts:
- createconfig.py — cria o arquivo settings.ini com as configurações dos componentes em diferentes ambientes para o deploy subsequente (Pré-produção, Produção, Testes, …)
- install_venv.sh — cria um ambiente virtual para componentes Python em um diretório específico e o copia para servidores remotos
- prepare_init.d.py — prepara os scripts de início/parada dos componentes com base em um modelo
- deploy.py — distribui e reinicia os novos componentes
O tempo passou. A fase de staging foi substituída por pré-produção e produção. O suporte ao produto foi adicionado em mais uma distribuição (CentOS). Mais 5 servidores físicos potentes e uma dúzia de virtuais foram adicionados. E os desenvolvedores e testadores estavam encontrando cada vez mais dificuldades para testar suas tarefas em um ambiente que se aproximasse do estado de operação. Naquele momento, ficou claro que não poderia ficar sem isso...
Parte II
Assim, nosso cluster é uma cena notável, um sistema composto por algumas dezenas de componentes individuais, não descritos por Dockerfiles. Configurá-lo para um deploy em um ambiente específico só pode ser feito como um todo. Nossa tarefa é fazer o deploy do cluster no ambiente de staging para testá-lo antes dos testes de pré-lançamento.
Teoricamente, pode haver vários clusters funcionando ao mesmo tempo: quantas tarefas estiverem em estado concluído ou próximo da conclusão. A capacidade dos servidores à nossa disposição permite rodar vários clusters em cada servidor. Cada cluster de staging deve ser isolado (não deve haver sobreposição de portas, diretórios, etc.).
O recurso mais valioso é o nosso tempo, e tínhamos pouco.
Para um início mais rápido, escolhemos o Docker Swarm devido à sua simplicidade e flexibilidade de arquitetura. A primeira coisa que fizemos foi criar um gerente em servidores remotos e vários nós:
$ docker node ls
ID                            HOSTNAME            STATUS              AVAILABILITY        MANAGER STATUS      ENGINE VERSION
kilqc94pi2upzvabttikrfr5d     nop-test-1     Pronto               Ativo                                  19.03.2
jilwe56pl2zvabupryuosdj78     nop-test-2     Pronto               Ativo                                  19.03.2
j5a4yz1kr2xke6b1ohoqlnbq5 *   nop-test-3     Pronto               Ativo              Líder              19.03.2
Em seguida, criamos uma rede:
$ docker network create --driver overlay --subnet 10.10.10.0/24 nw_swarm
Depois, vinculamos o Gitlab-CI e os nós do Swarm em termos de gerenciamento remoto dos nós a partir do CI: instalação de certificados, configuração de variáveis secretas, além da configuração do serviço Docker no servidor de gerenciamento. Isso nos economizou muito tempo.
Em seguida, adicionamos jobs para criação e destruição de stacks no .gitlab-ci.yml.
No .gitlab-ci.yml foram adicionados mais alguns jobs
## staging stage
deploy_staging:
  stage: testing
  before_script:
    - echo "override global 'before_script'"
  image: "REGISTRY:5000/docker:latest"
  environment: staging
  dependencies: []
  variables:
    DOCKER_CERT_PATH: "/certs"
    DOCKER_HOST: tcp://10.50.173.107:2376
    DOCKER_TLS_VERIFY: 1
    CI_BIN_DEPENDENCIES_JOB: "release.centos.7"
  script:
    - mkdir -p $DOCKER_CERT_PATH
    - echo "$TLSCACERT" > $DOCKER_CERT_PATH/ca.pem
    - echo "$TLSCERT" > $DOCKER_CERT_PATH/cert.pem
    - echo "$TLSKEY" > $DOCKER_CERT_PATH/key.pem
    - docker stack deploy -c docker-compose.yml ${CI_ENVIRONMENT_NAME}_${CI_COMMIT_REF_NAME} --with-registry-auth
    - rm -rf $DOCKER_CERT_PATH
  when: manual

## stop staging stage
stop_staging:
  stage: testing
  before_script:
    - echo "override global 'before_script'"
  image: "REGISTRY:5000/docker:latest"
  environment: staging
  dependencies: []
  variables:
    DOCKER_CERT_PATH: "/certs"
    DOCKER_HOST: tcp://10.50.173.107:2376
    DOCKER_TLS_VERIFY: 1
  script:
    - mkdir -p $DOCKER_CERT_PATH
    - echo "$TLSCACERT" > $DOCKER_CERT_PATH/ca.pem
    - echo "$TLSCERT" > $DOCKER_CERT_PATH/cert.pem
    - echo "$TLSKEY" > $DOCKER_CERT_PATH/key.pem
    - docker stack rm ${CI_ENVIRONMENT_NAME}_${CI_COMMIT_REF_NAME}
    # TODO: need check that stopped
  when: manual
Do fragmento de código acima, podemos ver que duas botões (deploy_staging, stop_staging), que exigem intervenção manual, foram adicionados aos Pipelines.
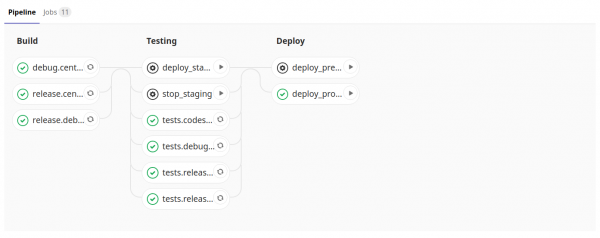
O nome do stack corresponde ao nome do branch e essa singularidade deve ser suficiente. Os serviços no stack recebem endereços IP únicos, e as portas, diretórios etc. serão isolados, mas iguais de stack para stack (já que o arquivo de configuração é o mesmo para todos os stacks) — que era o que buscávamos. O stack (cluster) é implantado com docker-compose.yml, que descreve nosso cluster.
docker-compose.yml
---
version: '3'

services:
  userprop:
    image: redis:alpine
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:
  celery_bcd:
    image: redis:alpine
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

  schedulerdb:
    image: mariadb:latest
    environment:
      MYSQL_ALLOW_EMPTY_PASSWORD: 'yes'
      MYSQL_DATABASE: schedulerdb
      MYSQL_USER: ****
      MYSQL_PASSWORD: ****
    command: ['--character-set-server=utf8mb4', '--collation-server=utf8mb4_unicode_ci', '--explicit_defaults_for_timestamp=1']
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

  celerydb:
    image: mariadb:latest
    environment:
      MYSQL_ALLOW_EMPTY_PASSWORD: 'yes'
      MYSQL_DATABASE: celerydb
      MYSQL_USER: ****
      MYSQL_PASSWORD: ****
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

  cluster:
    image: $CENTOS7
    environment:
      - CENTOS
      - CI_ENVIRONMENT_NAME
      - CI_API_V4_URL
      - CI_REPOSITORY_URL
      - CI_PROJECT_ID
      - CI_PROJECT_URL
      - CI_PROJECT_PATH
      - CI_PROJECT_NAME
      - CI_COMMIT_REF_NAME
      - CI_BIN_DEPENDENCIES_JOB
    command: >
      sudo -u myusername -H /bin/bash -c ". /etc/profile &&
        mkdir -p /storage1/$CI_COMMIT_REF_NAME/$CI_PROJECT_NAME &&
        cd /storage1/$CI_COMMIT_REF_NAME/$CI_PROJECT_NAME &&
            git clone -b $CI_COMMIT_REF_NAME $CI_REPOSITORY_URL . &&
            curl $CI_API_V4_URL/projects/$CI_PROJECT_ID/jobs/artifacts/$CI_COMMIT_REF_NAME/download?job=$CI_BIN_DEPENDENCIES_JOB -o artifacts.zip &&
            unzip artifacts.zip ;
        cd /storage1/$CI_COMMIT_REF_NAME/$CI_PROJECT_NAME/scripts/deploy/ &&
            python3 createconfig.py -s $CI_ENVIRONMENT_NAME &&
            /bin/bash install_venv.sh -d -r ../..//requirements.txt &&
            python3 prepare_init.d.py &&
            python3 deploy.py -s $CI_ENVIRONMENT_NAME"
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    tty: true
    stdin_open: true
    networks:
      nw_swarm:

networks:
  nw_swarm:
    external: true
Aqui, podemos ver que os componentes estão unidos por uma única rede (nw_swarm) e estão disponíveis uns para os outros.
Os componentes do sistema (baseados em redis, mysql) estão separados do pool geral de componentes personalizados (planejamos separar também os personalizados como serviços). A fase de implantação do nosso cluster se apresenta como a transmissão de CMD para nossa única imagem configurada e, no geral, não difere muito da implantação descrita na Parte I. Vou enfatizar as diferenças:
- git clone … — obtemos os arquivos necessários para realizar a implantação (createconfig.py, install_venv.sh, etc.)
- curl… && unzip … — baixamos e descompactamos os artefatos da construção (utilitários compilados)
Só resta um problema ainda não descrito: os componentes que têm interface web não estão disponíveis nos navegadores dos desenvolvedores. Estamos resolvendo esse problema com um reverse proxy, da seguinte forma:
No .gitlab-ci.yml, após o deploy do stack do cluster, adicionamos a linha de deploy do balanceador (que, com os commits, apenas atualiza sua configuração (cria novos arquivos de configuração do nginx com base no modelo: /etc/nginx/conf.d/${CI_COMMIT_REF_NAME}.conf) — veja o código docker-compose-nginx.yml)
- docker stack deploy -c docker-compose-nginx.yml ${CI_ENVIRONMENT_NAME} --with-registry-auth
docker-compose-nginx.yml
---
version: '3'

services:
  nginx:
    image: nginx:latest
    environment:
      CI_COMMIT_REF_NAME: ${CI_COMMIT_REF_NAME}
      NGINX_CONFIG: |-
            server {
                listen 8080;
                server_name staging_${CI_COMMIT_REF_NAME}_cluster.dev;

                location / {
                    proxy_pass http://staging_${CI_COMMIT_REF_NAME}_cluster:8080;
                }
            }
            server {
                listen 5555;
                server_name staging_${CI_COMMIT_REF_NAME}_cluster.dev;

                location / {
                    proxy_pass http://staging_${CI_COMMIT_REF_NAME}_cluster:5555;
                }
            }
    volumes:
      - /tmp/staging/nginx:/etc/nginx/conf.d
    command:
      /bin/bash -c "echo -e "$$NGINX_CONFIG" > /etc/nginx/conf.d/${CI_COMMIT_REF_NAME}.conf;
        nginx -g "daemon off;";
        /etc/init.d/nginx reload"
    ports:
      - 8080:8080
      - 5555:5555
      - 3000:3000
      - 443:443
      - 80:80
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

networks:
  nw_swarm:
    external: true
Nos computadores dos desenvolvedores, atualizamos /etc/hosts; registramos a URL até o nginx:
10.50.173.106 staging_BRANCH-1831_cluster.dev
Assim, o deploy de clusters de staging isolados foi implementado e os desenvolvedores agora podem executá-los em quantidade suficiente para verificar suas tarefas.
Próximos planos:
- Separar nossos componentes como serviços
- Criar um Dockerfile para cada um
- Determinar automaticamente os nós menos sobrecarregados no stack
- Definir nós com base no padrão de nome (e não usar ID como no artigo)
- Adicionar uma verificação para garantir que o stack foi destruído
- …
Agradecimentos especiais a .
Fonte: habr.com
